企业级 AI 经营分析系统:语义层、专业模型与权限边界
原创
企业级 AI 经营分析系统:语义层、专业模型与权限边界
原创
数据党
发布于 2026-09-11 10:28:44
发布于 2026-09-11 10:28:44
在企业级数据架构升级的实践中,将 LLM 应用于经营分析系统已成为主流探索方向。然而,简单的 Text-to-SQL 架构在面对企业复杂的经营决策时存在明显的局限性:生成 SQL 容易出现字段歧义、过滤条件遗漏或口径漂移,难以满足财务与业务决策对数据口径稳定的要求。
构建生产级 AI 经营分析系统,核心的架构思路是实现“自然语言理解”与“确定性数据计算”的解耦,通过构建统一业务语义层、专业模型调度引擎以及全链路权限隔离体系,搭建稳定可靠的智能数据分析平台。
1. 语义层与底层数据治理架构
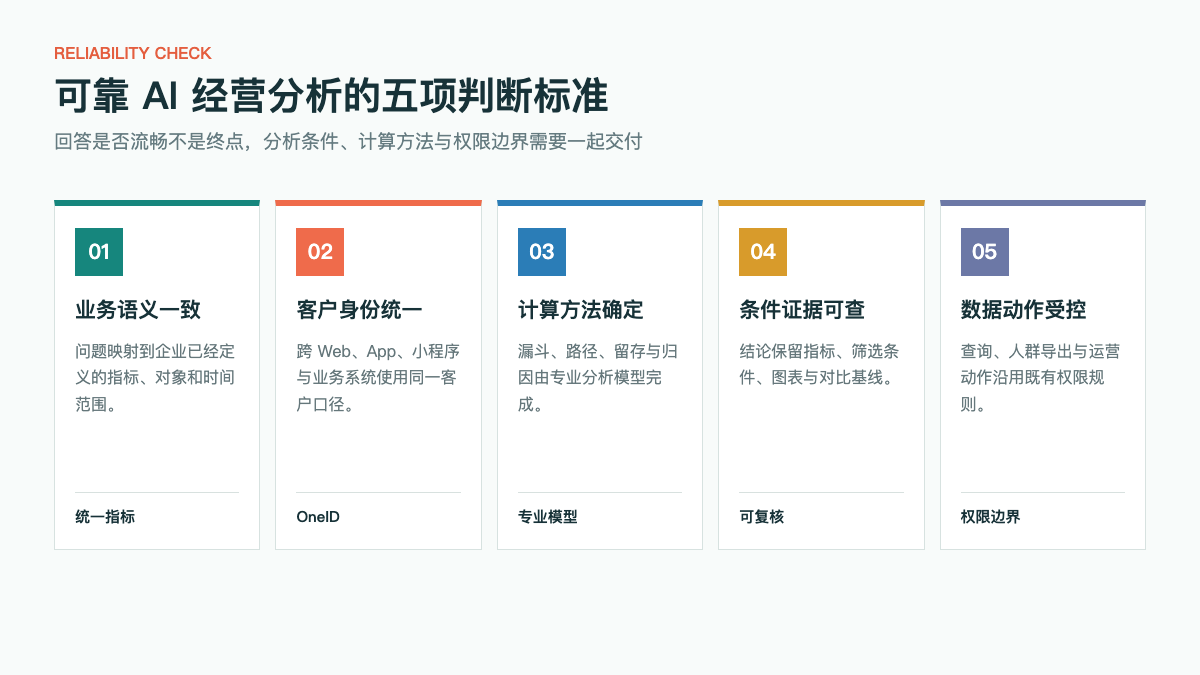
经营分析问题的输入往往具有高度的不确定性。例如“新客首单转化率”,涉及“新客定义”、“首单判定”以及“时间窗口”等多个维度的计算逻辑。
为避免大模型直接拼装数据库查询语句导致的口径混乱,生产系统必须引入一层标准的业务语义层(Semantic Layer)。
在工程实现中,系统将采集到的底层数据抽象为主体(Subject)、事件(Event)、属性(Attribute)与统一指标(Metric)。同时,利用 OneID 识别算法对来自 Web、App、小程序及 CRM 的数据进行跨端身份融合。大模型在接收到自然语言请求后,优先进行意图识别并将其映射为语义层中预定义的 Metric ID 与 Dimension ID。这样可以确保不同团队通过自然语言提问时,底层调用的算法和数据集完全一致。
2. 大模型 Agent 与专业分析模型的工程解耦
在大模型与分析引擎的协同设计上,大模型不承担复杂的数学计算与图形生成,而是专注于工作流编排与上下文管理。
在系统实施中,可以使用类似 GrowingIO 的智能数据分析专家 Agent 作为调度中枢:
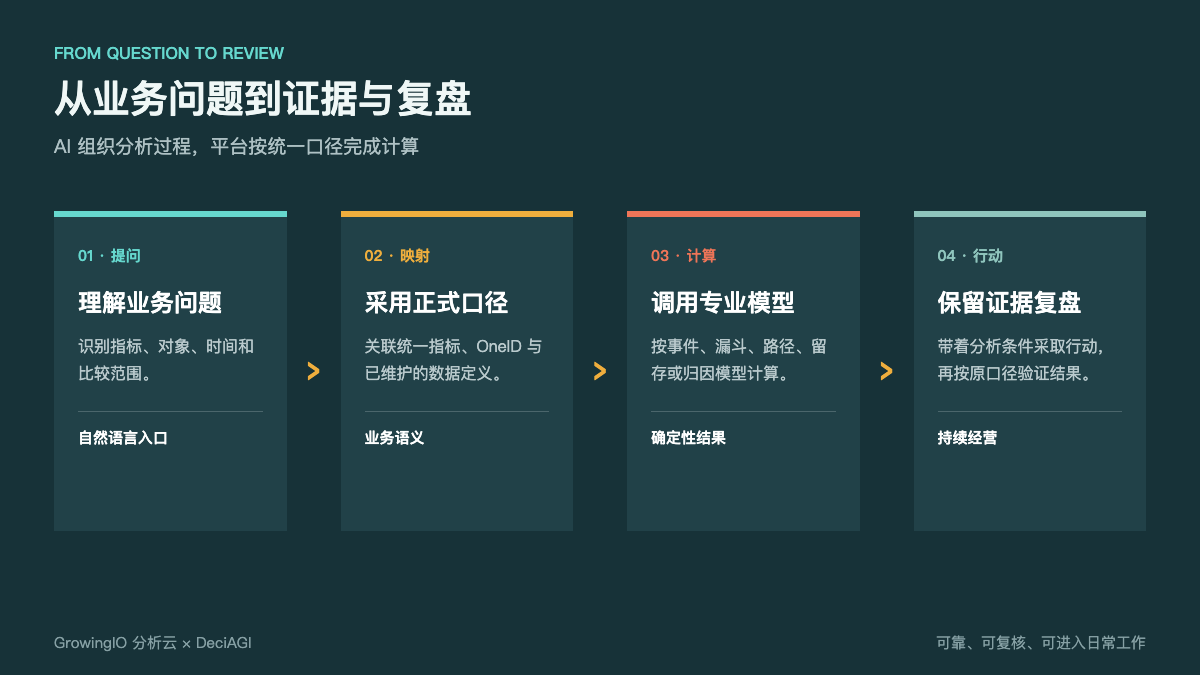
意图拆解与计划生成:Agent 接收业务提问后,制定“基线对比 -> 维度下钻 -> 漏斗定位 -> 归因分析”的执行计划;
确定性模型调用:Agent 向底层的用户行为分析(UBA)计算引擎发送标准化 API 请求。具体的漏斗转化率、路径流向矩阵以及留存率,完全由底层的确定性引擎计算产生;
响应文本合成:Agent 接收引擎返回的结构化 JSON 数据,重新组装为符合业务阅读习惯的分析文本。
这种设计模式把大模型与数值计算分开,便于稳定复现分析结果,确保了分析过程的严密性。
3. 多轮对话上下文继承与数据证据链
生产级系统必须支持复杂的连续追问。系统设计中需建立会话状态管理器(Session State Manager),保存当前分析所依托的时间范围、用户分群以及过滤条件。
当用户输入“仅查看新版本用户的表现”时,状态管理器增量更新维度切片,避免每次追问都需要重置分析上下文。
此外,系统必须为生成的每一项结论提供数据证据链(Evidence Chain):
参数可视化:在分析文本下方提供清晰的过滤参数与计算逻辑说明;
跳转复查:提供指向底层可视化图表的深度链接,支持业务人员一键跳回漏斗图、趋势图或留存矩阵中进行复核;
运营动作连接:在客户数据平台(CDP)中,可将分析发现的异常人群一键保存为受众分群,直接连通智能运营平台进行后续触达。
4. 权限隔离机制与部署模式
数据安全是企业级系统不可逾越的红线。AI 接口不能成为绕过企业既有 RBAC/ABAC 权限体系的漏洞。
在系统架构设计中,Agent 发起的每一笔数据查询都必须附带当前用户的身份凭证。分析引擎在底层自动注入数据过滤规则(如行级数据权限与字段掩码),确保市场人员只能调阅授权渠道的数据,区域负责人只能查看管辖区域的经营结果。
在部署层面,系统应当兼顾 SaaS 部署的高效扩展性与私有化部署的安全合规性,支持根据企业的数据敏感等级灵活选择存储与计算模式。通过将语义统一、确定计算、证据追溯与严格权限融合在一起,才能构建出可落地的生产级 AI 经营分析系统。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号