医疗票据OCR与理赔规则自动化:从信息孤岛到智能审核的全链路技术解析
原创
医疗票据OCR与理赔规则自动化:从信息孤岛到智能审核的全链路技术解析
原创
快瞳科技
修改于 2026-09-08 17:26:22
修改于 2026-09-08 17:26:22
在商业医保与TPA理赔业务中,票据信息提取低效、规则适配脱节、数据标准混乱,长期制约着理赔时效与风控精度。本文从技术视角拆解OCR+知识图谱+规则引擎的融合方案,并附常见实施问题解答,助力企业构建可落地的智能化理赔底座。
一、商业医保理赔的三大核心堵点
1. 票据形态复杂,信息结构化成本高昂
医疗单据涵盖门诊发票、住院结算单、费用明细清单、病历小结等十余种类型,版式差异大、打印质量参差、手写批注常见。人工录入单张平均需5~10分钟,一份30页的复杂案件耗时约2.5小时,且关键字 段(金额、病种、诊疗项目)错漏率可达12%,直接导致核算偏差与纠纷。
2. 理赔规则动态多变,人工匹配不堪重负
各地医保目录(药品/诊疗项目)更新频繁,商保条款(赔付比例、免赔额、免责范围)高度个性化。审核人员需逐项比对票据明细、医保政策与保单规则,人均日处理量仅8至10单,复杂案件需跨部门协同,理赔周期普遍拉长至7~15天,且“同案不同判”现象频发,影响合规与用户体验。
3. 系统接口异构,数据流转存在天然屏障
商保核心系统、TPA审核平台、医保结算端的数据格式互不兼容,缺乏统一对接协议。提取出的信息常需人工二次录入或格式转换,数据孤岛严重;同时缺少内置校验机制,异常数据(如金额逻辑矛盾、病种与项目不符)难以实时捕获,部分场景下骗保漏检率高达15%。
二、技术破局:OCR+知识图谱+规则引擎的三层架构
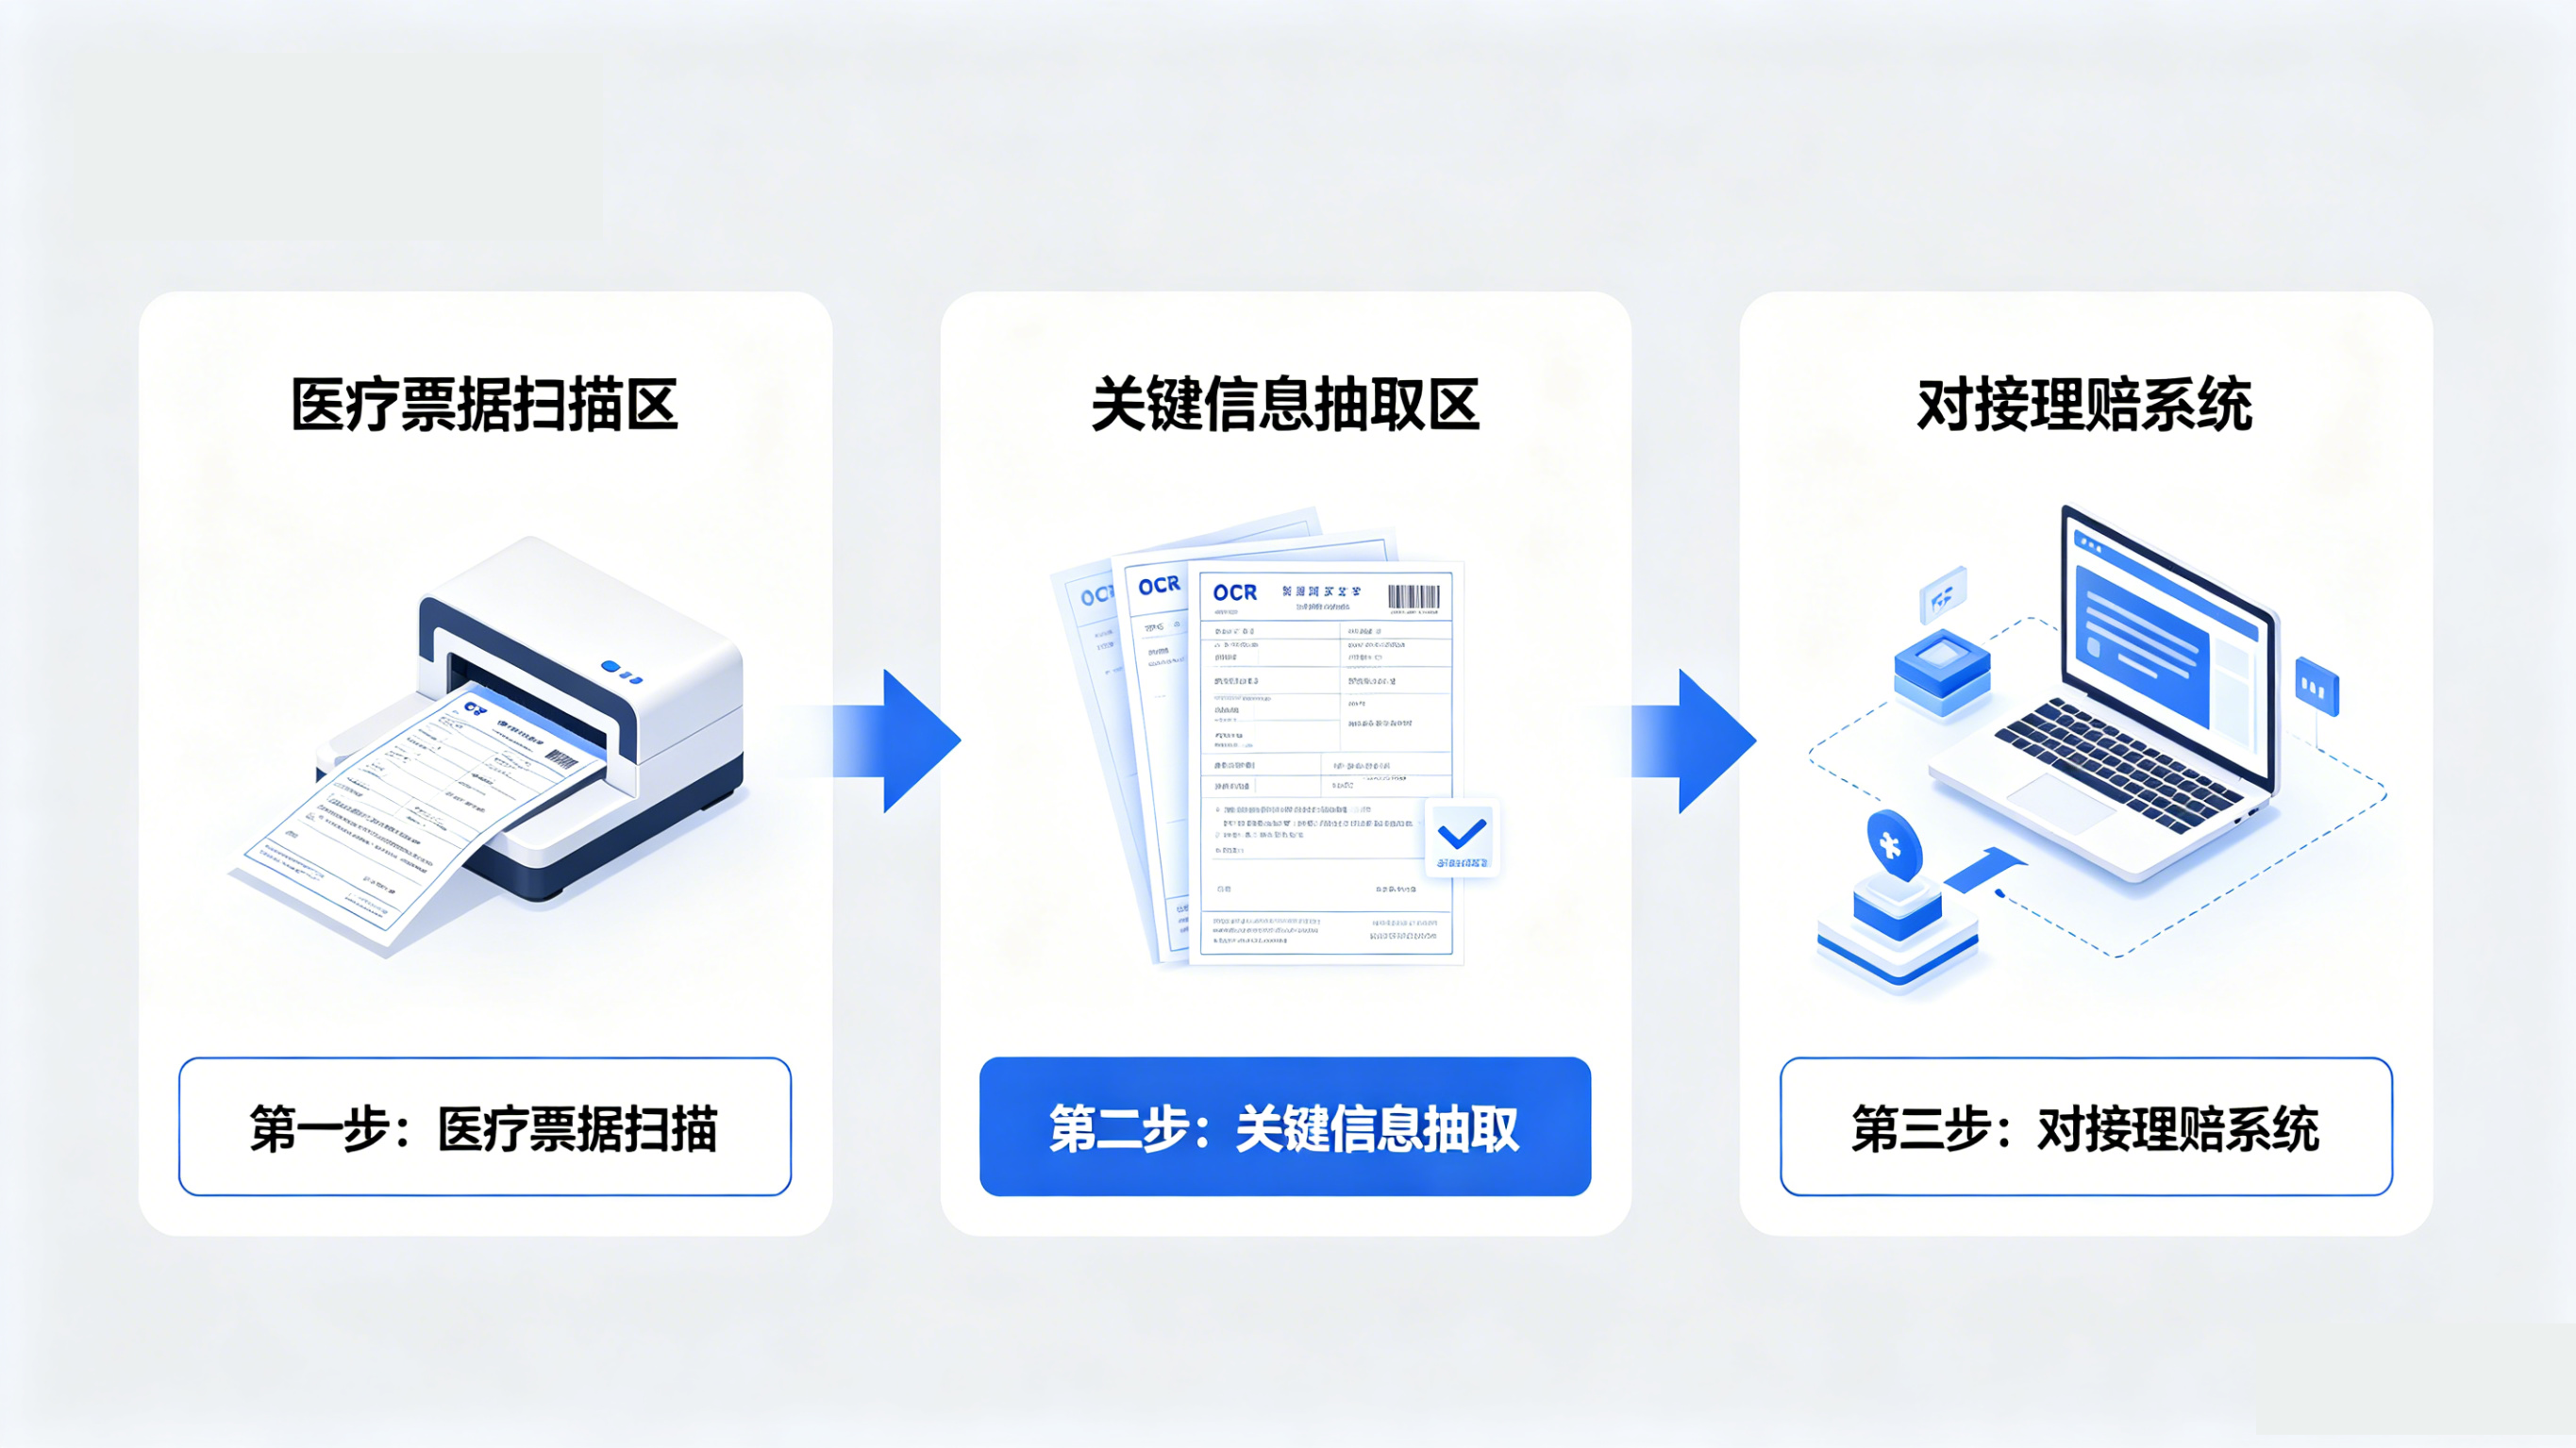
当前业界成熟方案已不再局限于单一OCR识别,而是构建“精准抽取 — 语义理解 — 自动裁决”的闭环链路,快瞳的核心技术模块如下:
1. 全场景医疗票据智能识别
多模态图像预处理:采用自适应二值化、透视校正、纹理修复等算法,抵抗光照不均、褶皱、角度偏移等干扰,显著提升低质量图像的可读性。
专用版式分析模型:基于深度学习的目标检测与序列标注,无需预设模板即可适配全国各级医疗机构的不同票据版式,覆盖门诊/住院发票、费用清单、结算单、病历等10+类单证。
关键字段结构化抽取:一次性输出总费用、医保支付额、个人自付、ICD-10疾病编码、药品及检查明细等30+字段,标准清晰单据识别准确率可达98%以上,模糊单据亦能保持90%左右的准确率。
2. 医疗知识图谱赋能语义校验与规则适配
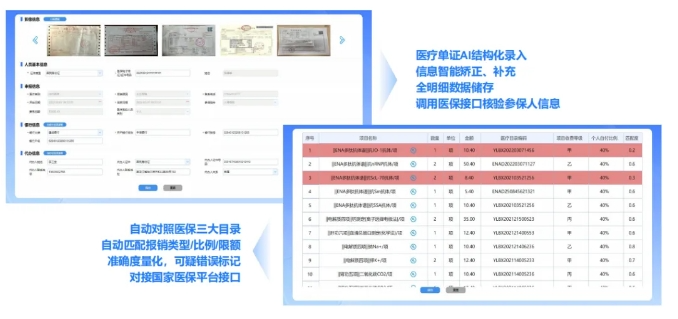
大规模医学知识库:整合3000万+实体关系(疾病、药品、诊疗项目、医保三目),预置全国各省市最新医保政策及限定支付条件,并可动态更新。
逻辑一致性校验:提取结果自动关联知识图谱,校验诊断与费用项目是否匹配、药品是否属于报销范围、收费是否符合当地定价标准,从源头拦截不合理数据。
动态规则引擎:支持商保公司自定义赔付比例、免赔额、除外责任等规则,实现“地区+险种+保单”多维度规则自动匹配,秒级输出理算结果,人工仅需复核异常案件。
3. 标准化接口与轻量化集成
多格式输出:识别与校验结果支持JSON、XML、Excel等通用数据格式,可直接对接各类核心系统,避免二次开发转换。
RESTful API设计:提供标准HTTP/HTTPS接口,兼容主流开发语言(Java、Python、Go等),支持私有云、公有云或本地化部署,平均集成周期缩短至1~2周,无需推翻原有系统架构。
三、方案落地的核心价值
维度 | 传统模式 | 智能化模式 |
|---|---|---|
单张票据处理时间 | 5~10分钟 | 3~5秒 |
日均审核单量 | 8~10单 | 80~100单(自动+人工复核) |
常规案件理赔时效 | 3~5天 | 2小时以内 |
规则适配准确率 | 依赖人工,约85% | 100%(基于规则引擎) |
人力成本 | 基准 | 降低60%~70% |
欺诈/违规识别率 | 约85% | 提升至95%以上 |
此外,自动化 的校验与理算显著减少了“同案不同判”纠纷,客户满意度可提升至95%以上,同时降低资金风险和合规压力。
四、FAQ:企业部署常见问题与解答
Q1:OCR对模糊、老旧或带有手写批注的票据是否可用?
A:现代医疗OCR方案内置多级图像增强和手写/印刷体分离模型。对于轻度模糊和常规手写批注(如医生签名、日期补充),识别率可达85%~90%;若票据严重污损或字迹完全无法辨认,系统会主动标记为“人工干预”并推送至审核队列,确保不遗漏关键信息。
Q2:如何保证规则引擎与各地频繁变动的医保政策同步?
A:规则引擎设计为可热更新的配置中心,支持运营人员在线调整目录映射、支付限制、定价标准,无需重启服务。同时,系统可订阅官方发布的医保目录变更通知,主动提醒待更新条目,确保规则实时性。
Q3:集成到现有理赔系统需要改造哪些部分?
A:通常只需在前端调用OCR识别API,并将返回的结构化数据传入规则引擎接口,最后接收理算结果写入核心库。整个流程采用微服务设计,对原有业务代码侵入极小,1~2周可完成联调上线,也可选择独立部署为旁路服务,先用于辅助审核,逐步过渡。
Q4:数据安全与隐私合规如何保障?
A:方案支持全链路数据加密(传输层TLS + 存储层AES-256),并可按需部署于企业内网或私有云,原始图像和识别结果均不离开客户安全域。权限管理细粒度控制,操作日志全留痕,符合等保及医疗数据合规要求。
Q5:系统能否同时处理PDF多页文档和批量票据?
A:支持。PDF可自动拆页并合并结果,批量任务通过异步队列处理,单服务器吞吐量可达2000页/小时,并可水平扩展提升并发能力。
Q6:对于特殊险种(如特药险、齿科险)是否需要定制开发?
A:识别层可定制新增字段(如特定药品批号、治疗部位),规则引擎允许配置专属赔付逻辑和除外条款,无需重写核心代码,通过配置化方式即可快速适配新险种。
Q7:如何验证识别准确率和规则计算正确性?
A:一般提供离线测试工具,允许企业用历史标注票据进行批量回测,对比系统输出与人工标注的差异。同时,规则引擎内置单元测试框架,可针对不同保单和费用清单编写测试用例,确保每次规则变更后结果可验证。
五、从人力密集到数据驱动的演进路径
头部保险及TPA机构的实践表明,该技术栈已累计处理数亿次票据调用,信息提取准确率稳定在98%以上,理赔综合时效缩短超60%。其长期价值不仅体现于效率提升,更在于:
业务层:缩短理赔周期,优化客户体验,增强产品竞争力;
风控层:实现事前校验、事中监控、事后追溯的全流程风险闭环;
成本层:释放大量基础审核人力,转向更高价值的案件分析与服务优化。
结语
医疗票据OCR与规则自动化技术的融合,本质上解决的是“非结构化数据→结构化信息→可执行决策”的映射问题,这正是理赔数字化的核心瓶颈所在。通过标准化识别、知识图谱校验和可配置规则引擎的协同,企业可在不颠覆现有系统的前提下,快速构建高效、合规、可扩展的智能审核能力,推动理赔服务从“慢、贵、险”向“快、准、稳”转变。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号