非编码基因(主要是lncRNA)对单细胞、stereo-seq、visium HD分析上的影响
原创
非编码基因(主要是lncRNA)对单细胞、stereo-seq、visium HD分析上的影响
原创
追风少年i
修改于 2026-09-06 08:57:49
修改于 2026-09-06 08:57:49
作者,Evil Genius
这一篇我们来总结非编码基因(主要是lncRNA)对单细胞、stereo-seq、visium HD分析上的影响。
现在大家拿到单细胞、stereo-seq、visium HD的基础分析报告,看着指标都挺好,实际上相比于原来添加了很多非编码基因,真正可以用的没有基础报告写的那么多。
非编码基因的存在,会怎样影响数据QC、聚类、细胞注释、细胞亚群识别、空间邻域/niche以及细胞通讯分析。
一、先明确:什么叫“非编码基因”?
这里主要包括:
- lncRNA(长链非编码RNA)
- miRNA
- snRNA
- snoRNA
- circRNA
- pseudogene(严格来说假基因并不全部属于“非编码RNA”)
- 其他ncRNA
其中对于常规:
scRNA-seq / Stereo-seq / Visium HD
最容易在表达矩阵中看到并影响分析的,主要是:
lncRNA、pseudogene、部分其他非编码转录本。
例如:
MALAT1
NEAT1
XIST
GAS5
H19
以及大量:
RP11-xxxx
ACxxxx
ALxxxx
LINCxxxx
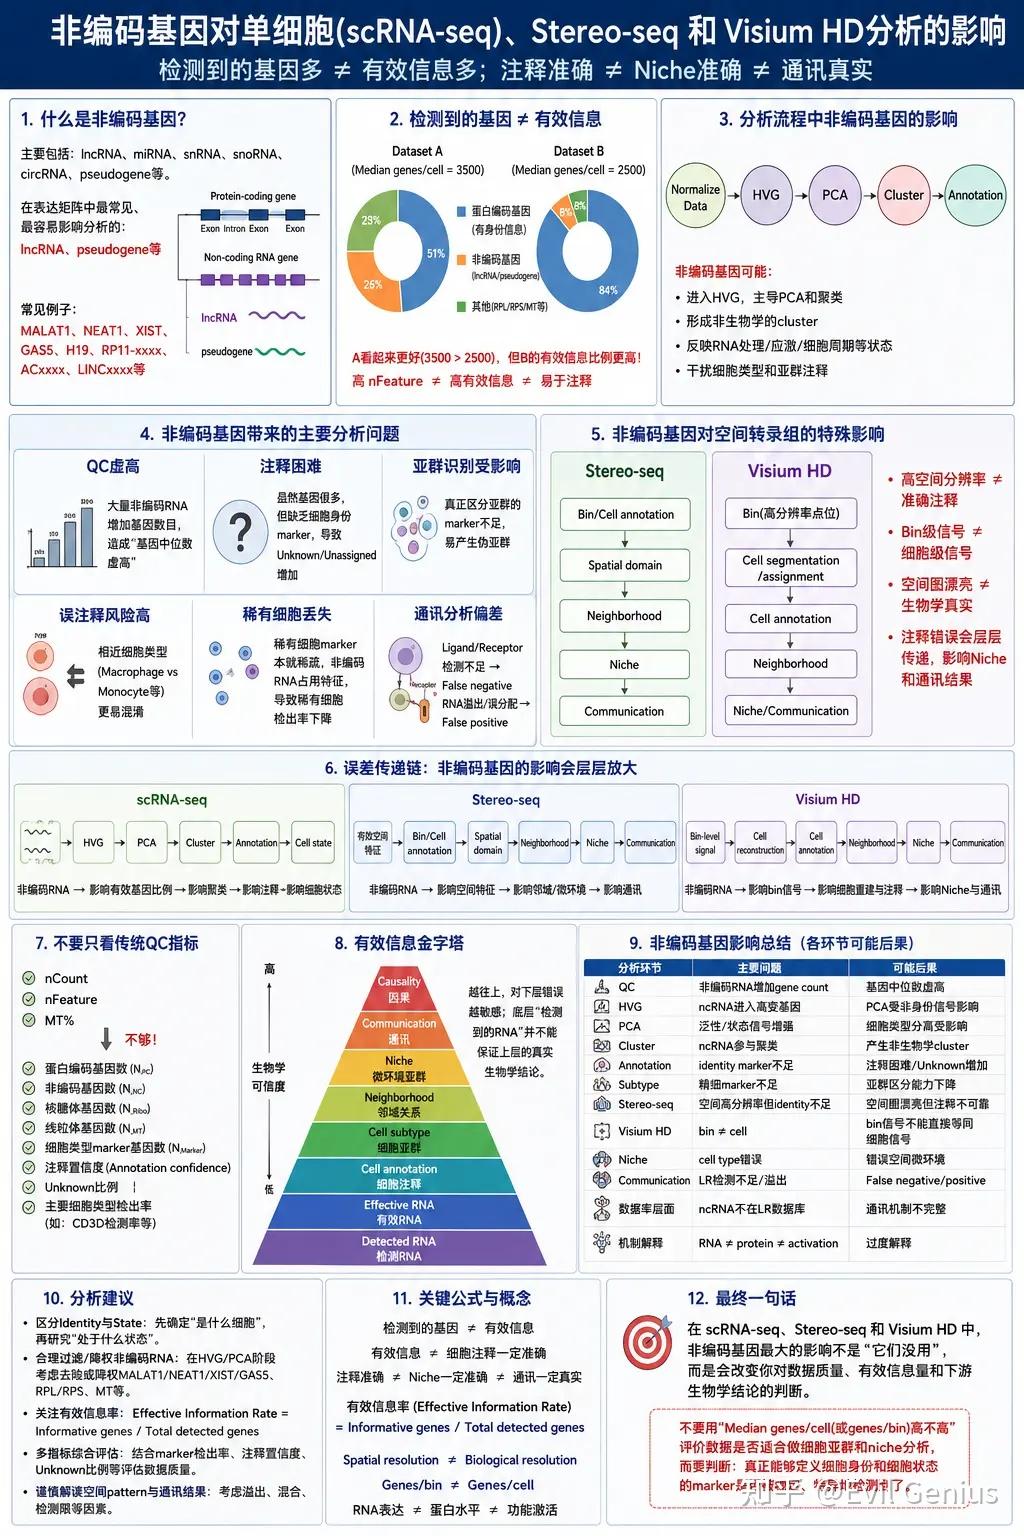
二、最重要的认识:检测到的基因 ≠ 有效的生物学信息
这是整个问题的核心。
很多数据QC首先看:
例如:
Median genes/cell = 3,500
看起来非常好。
但是这3500个基因可能包含:
3500 genes
│
├── Protein-coding genes
│      └── 大量细胞身份marker
│
├── lncRNA
│
├── pseudogene
│
├── ribosomal genes
│
├── mitochondrial genes
│
├── housekeeping genes
│
└── 低信息量基因
所以:
进一步:
因此,一个细胞:
检测到3500个基因
不一定意味着:
拥有3500个可以用于细胞注释的有效特征。
三、非编码基因对QC的第一个影响:造成“基因数量虚高”
这是最值得强调的问题。
假设两个数据:
Dataset A
Median genes/cell = 3500

Protein-coding = 1800
lncRNA/pseudogene = 900
Ribosomal/other = 800
Dataset B
Median genes/cell = 2500

Protein-coding = 2100
lncRNA/pseudogene = 200
Ribosomal/other = 200
如果只看:
nFeature_RNA会认为:
A的数据质量更好。
但如果真正关注:
细胞身份信息
B可能反而更加可靠。
所以:
四、第二个影响:非编码基因可能成为高变基因
Seurat等分析流程通常会进行:
NormalizeData
      ↓
FindVariableFeatures
      ↓
ScaleData
      ↓
PCA
      ↓
Neighbors
      ↓
Clusters
问题来了:
如果:
MALAT1
NEAT1
XIST
H19
GAS5
在不同细胞之间存在明显表达差异,它们可能进入:
Highly Variable Features
于是:
HVG
 ↓
PCA
 ↓
PC
 ↓
Neighbor graph
 ↓
Cluster
也就是说:
非编码RNA可能直接参与决定细胞聚类。
五、第三个问题:聚类可能更多反映“RNA表达程序”,而不是细胞类型
这是一个非常重要的区别。
理想情况:
CD3D
CD3E
TRBC1
IL7R
NKG7
MS4A1
LYZ
EPCAM
COL1A1
这些基因帮助我们形成:
T cell
B cell
Macrophage
Epithelial
Fibroblast
但是如果大量高变基因是:
MALAT1
NEAT1
XIST
GAS5
那么PCA可能部分反映:
RNA processing
stress
cell cycle
sex chromosome
transcriptional state
而不是:
cell identity于是:
Cluster存在,但Cluster ≠ biological cell type。
六、一个典型例子:XIST
假设研究的是:
女性肿瘤样本XIST可能非常明显。
如果:
XIST进入HVG/PCA:
XIST high
     ↓
PC loading
     ↓
PCA separation
     ↓
Cluster separation
最后可能出现:
Cluster 1
XIST high

Cluster 2
XIST low
但这两个cluster:
可能并不是两个新的细胞亚群。
而只是:
XIST表达状态不同。
因此:
七、第四个问题:非编码基因会影响细胞注释
这是“看着基因中位数很高,但是注释不出来”。
可以把原因总结成:
高 nFeature
      ↓
并不代表
      ↓
高 annotation information
例如:
Cell A

3500 genes
↓
其中:
MALAT1
NEAT1
GAS5
RPLP0
RPS...
MT...
大量lncRNA
但是:
CD3D      0
CD3E      0
TRBC1     0
MS4A1     0
LYZ       0
EPCAM     0
COL1A1    0
结果:
这个细胞“基因很多”,但没有足够的cell identity marker。
最终:
Unknown
Unassigned
Ambiguous
或者被错误分配。
八、第五个问题:相近细胞类型更容易发生误注释
非编码基因本身通常不能很好地解决:
Macrophage
       ↕
Monocyte

DC
       ↕
Macrophage

CAF
       ↕
Pericyte

CD4 T
       ↕
CD8 T
例如:
Macrophage
LYZ
LST1
FCER1G
CTSS
C1QC
APOE
如果真正有区分能力的marker没有被稳定检测:
C1QC  low
APOE  low
FCER1G low
而非编码RNA占据大量表达特征:
MALAT1
NEAT1
GAS5
就容易出现:
cell identity signal弱,generic RNA signal强。
九、第六个问题:细胞亚群识别会受到影响
这是比“注释”更进一步的问题。
例如:
CD8 T cell之后希望进一步分成:
Naive
Effector
Exhausted
Proliferative
Memory
理想marker:
TCF7
CCR7
IL7R
LST1
GZMB
GNLY
PDCD1
TIGIT
LAG3
TOX
MKI67
如果这些真正有生物学意义的marker检测不足,而:
MALAT1
NEAT1
GAS5
等占据较大权重,就可能出现:
Cluster A
Cluster B
Cluster C
但是:
这些cluster不一定对应真实的功能亚群。
所以:
十、对传统scRNA-seq的影响尤其要注意
传统scRNA-seq有一个优势:
通常接近全转录组检测。
所以:
Protein-coding
+
lncRNA
+
pseudogene
+
其他transcripts
都可能进入矩阵。
这意味着:
优点
非编码RNA可能提供:
- 发育状态
- 转录调控
- 应激状态
- 肿瘤状态
- 性别相关信息
- 染色质/转录程序信息
但是缺点
如果直接把所有feature:
全部Normalize
↓
全部HVG
↓
全部PCA
↓
全部Clustering
可能导致:
细胞类型信息和状态信息混在一起。
十一、因此scRNA-seq最好把“identity”和“state”分开
推荐思路:
RNA expression
       ↓
 ┌─────┴─────┐
 ↓           ↓
Identity     State
 ↓           ↓
CD3D         IFN
MS4A1        Stress
LYZ          Cell cycle
EPCAM        Hypoxia
COL1A1       EMT
也就是说:
第一层
确定:
这个是什么细胞?
第二层
确定:
这个细胞处于什么状态?
而不能:
所有gene
 ↓
PCA
 ↓
Cluster
 ↓
直接定义subtype
十二、对Stereo-seq的影响
Stereo-seq和scRNA-seq相比,最大的区别是:
多了空间信息。
所以非编码基因的问题不会消失,反而会进一步影响:
Gene expression
 ↓
Cell/bin annotation
 ↓
Spatial neighborhood
 ↓
Niche
十三、Stereo-seq第一个问题:高分辨率不等于高注释准确度
Stereo-seq可以提供非常高的空间分辨率。
但:
也就是说:
空间坐标非常精确不代表:
每一个空间单位的cell identity都准确仍然需要:
gene expression
+
cell segmentation
+
cell annotation
共同确定。
十四、Stereo-seq中的非编码基因会影响bin/cell的有效信息判断
例如:
Bin A
200 genes
看起来不错。
但如果:
MALAT1
NEAT1
GAS5
RPL
RPS
占据大量特征:
真正的:
CD3D
CD3E
TRBC
LYZ
COL1A1
EPCAM
很少。
那么:
这个bin虽然“gene number高”,但是cell identity information并不高。
十五、Stereo-seq特别容易遇到“空间信号很好看,但是细胞身份不够可靠”
这是空间数据与scRNA最大的区别之一。
可能看到:
Spatial map

红色区域
蓝色区域
绿色区域
图非常漂亮。
但是:
颜色的来源可能只是某几个高表达gene,而不一定代表真正的细胞亚群。
因此:
十六、Visium HD也是同样的问题
Visium HD最大的优势是:
比传统Visium具有更高空间分辨率。
但它仍然需要解决:
bin
 ↓
cell segmentation / cell assignment
 ↓
cell type annotation
因此:
高分辨率bin不等于天然获得准确单细胞。
十七、Visium HD中特别容易出现一个问题:一个细胞可能包含多个bin
例如:
Cell
 ┌─────────────┐
 │ ▪ ▪ ▪ ▪ ▪  │
 │ ▪ ▪ ▪ ▪ ▪  │
 │ ▪ ▪ ▪ ▪ ▪  │
 └─────────────┘
这些bin:
Bin 1
Bin 2
Bin 3
...
都可能属于同一个细胞。
所以:
gene detected/bin不能简单理解为:
gene detected/cell十八、因此Visium HD的“Median genes/bin”尤其不能直接作为细胞质量指标
这是非常重要的。
应该区分:
和:
如果经过cell segmentation:
多个bin
 ↓
一个cell
才可以进一步讨论:
genes/cell
UMI/cell
marker/cell
否则容易出现:
用bin级QC去解释细胞级生物学。
十九、非编码基因会进一步影响Stereo-seq / Visium HD的空间亚群分析
例如研究:
Tumor cells是否存在两个空间亚群?
需要做:
Tumor cells
 ↓
subcluster
 ↓
Tumor subtype 1
Tumor subtype 2
但如果驱动差异的是:
MALAT1
NEAT1
XIST
H19
那么需要先判断:
这是新的肿瘤亚群?
还是:
不同的转录状态?
还是:
技术/测序深度差异?
还是:
空间区域造成的RNA组成差异?
二十、这会直接影响Spatial Niche分析
典型流程:
空间转录组
      ↓
Cell annotation
      ↓
Neighborhood
      ↓
Niche
      ↓
Niche-associated subtype
如果:
Cell annotation本身受到非编码RNA和有效marker不足的影响:
那么:
错误annotation
      ↓
错误neighborhood
      ↓
错误niche
所以:
二十一、举一个非常典型的肿瘤例子
假设真实情况:
Tumor
+
CAF
+
Macrophage
+
T cell
但是:
CAF marker
COL1A1
COL1A2
DCN
LUM
检测比较弱。
同时:
MALAT1
NEAT1
GAS5
检测非常高。
那么:
Cell identity signal
        ↓
      较弱

Generic transcript signal
        ↓
      较强
最后可能:
CAF
 ↓
Unknown / Tumor-like
那么后面:
CAF-rich niche自然也会被低估。
二十二、通讯分析会进一步受到影响
例如研究:
CAF → Tumor典型:
CAF
COL1A1
TGFB1
FGF
CXCL
     ↓
Tumor
TGFBR
FGFR
CXCR
但如果:
ligand或者:
receptor表达很低:
或者没有稳定检测:
就可能得到:
False negative反过来,如果邻近细胞RNA存在:
spillover
ambient RNA
assignment error
又可能产生:
False positive所以:
而不是:
二十三、非编码基因对CellChat / CellPhoneDB的一个特殊影响
经典的:
CellChat
CellPhoneDB
LIANA
主要围绕:
Ligand–Receptor
进行分析。
因此很多:
lncRNA
miRNA
pseudogene
不会直接进入传统的LR数据库。
这会造成:
非编码RNA
 ↓
调控ligand/receptor
 ↓
改变细胞通讯
但是:
CellChat
 ↓
看不到这一层
因此会形成:
通讯网络的调控层缺失。
二十四、这意味着非编码RNA会造成“通讯机制解释不完整”
真实机制可能:
lncRNA
 ↓
转录因子
 ↓
Ligand
 ↓
secretion
 ↓
Receptor
 ↓
downstream pathway
而CellChat可能分析:
Ligand
 ↓
Receptor
所以:
CellChat更适合提出通讯候选关系,而不是完整解释调控机制。
二十五、非编码RNA对三类数据的影响可以这样概括
① scRNA-seq
核心问题:
ncRNA
 ↓
HVG
 ↓
PCA
 ↓
Clustering
 ↓
Annotation
主要影响:
- QC判断
- HVG
- PCA
- clustering
- cell annotation
- cell state
- subcluster
② Stereo-seq
在上述基础上增加:
空间定位
 ↓
cell/bin annotation
 ↓
neighborhood
 ↓
niche
因此影响:
- spatial clustering
- cell type mapping
- spatial domains
- neighborhood
- niche
- spatially variable genes
③ Visium HD
除了上述问题,还要特别注意:
bin
 ↓
cell
的转换。
所以影响:
- bin-level QC
- cell segmentation
- cell calling
- annotation
- spatial domain
- neighborhood
- niche
- communication
二十六、三者可以形成一个非常清楚的误差传递链
scRNA-seq
非编码RNA
     ↓
有效基因比例
     ↓
HVG
     ↓
PCA
     ↓
Cluster
     ↓
Annotation
     ↓
Cell state
Stereo-seq
非编码RNA
     ↓
有效空间特征
     ↓
Bin/Cell annotation
     ↓
Spatial domain
     ↓
Neighborhood
     ↓
Niche
     ↓
Communication
Visium HD
非编码RNA
     ↓
Bin-level signal
     ↓
Cell reconstruction
     ↓
Cell annotation
     ↓
Spatial neighborhood
     ↓
Niche
     ↓
Communication
二十七、因此不要只看这几个传统QC指标
很多分析报告只给:
nCount
nFeature
MT%
实际上不够。
我更建议增加:
① Protein-coding genes
② Non-coding genes
③ Ribosomal genes
④ Mitochondrial genes
⑤ Cell-type marker genes
⑥ Annotation confidence
⑦ Unknown / unassigned proportion
⑧ Major cell type detection rate
例如:
CD3D detected in 78% T cells
MS4A1 detected in 65% B cells
LYZ detected in 82% macrophages
COL1A1 detected in 91% CAF
这些指标其实比单纯:
Median genes/cell = 3000
更有解释价值。
二十八、可以定义一个非常重要的概念:有效信息率
虽然不是统一的标准指标,但在实际项目QC中非常值得使用。
例如:
例如:
样本A
样本B
那么虽然:
A = 3000 genes
B = 2500 genes
但是:
B可能拥有更高的有效细胞身份信息。
二十九、最终应该形成一个“有效信息金字塔”
比较推荐用下面这个框架:
┌───────────────┐
                 │   Causality   │
                 │     因果      │
                 └───────▲───────┘
                         │
                 ┌───────┴───────┐
                 │ Communication │
                 │     通讯       │
                 └───────▲───────┘
                         │
                 ┌───────┴───────┐
                 │     Niche     │
                 │   微环境亚群   │
                 └───────▲───────┘
                         │
                 ┌───────┴───────┐
                 │ Neighborhood  │
                 │    邻域关系    │
                 └───────▲───────┘
                         │
                 ┌───────┴───────┐
                 │ Cell subtype  │
                 │    细胞亚群    │
                 └───────▲───────┘
                         │
                 ┌───────┴───────┐
                 │ Cell annotation│
                 │    细胞注释    │
                 └───────▲───────┘
                         │
                 ┌───────┴───────┐
                 │ Effective RNA │
                 │   有效RNA      │
                 └───────▲───────┘
                         │
                 ┌───────┴───────┐
                 │ Detected RNA  │
                 │   检测RNA      │
                 └───────────────┘
最底层的:
Detected RNA
并不能自动保证最上面的:
Causality
三十、最后总结
非编码基因对单细胞与空间转录组分析的主要影响
分析环节 | 主要问题 | 可能后果 |
|---|---|---|
QC | 非编码RNA增加gene count | 基因中位数虚高 |
有效信息 | ncRNA不一定具有cell identity信息 | 有效基因比例下降 |
HVG | ncRNA进入高变基因 | PCA受非身份信号影响 |
PCA | generic/states signal增强 | 细胞类型分离受影响 |
Clustering | 非编码RNA参与聚类 | 产生非生物学cluster |
Annotation | identity marker不足 | 注释困难/Unknown增加 |
Subtype | 精细marker不足 | 亚群区分能力下降 |
Rare cells | marker稀疏 | 稀有细胞容易丢失 |
Stereo-seq | 空间高分辨率但identity不足 | 空间图漂亮但注释不可靠 |
Visium HD | bin ≠ cell | bin级信号不能直接等同细胞信号 |
Spatial domain | 非编码RNA形成空间差异 | 可能出现假空间pattern |
Neighborhood | annotation误差传递 | 邻域组成偏差 |
Niche | cell type错误 | 错误空间微环境 |
Communication | ligand/receptor检测不足 | False negative |
Spillover | 邻近RNA错误归属 | False positive |
LR数据库 | ncRNA通常不在传统LR数据库 | 通讯机制不完整 |
机制解释 | RNA ≠ protein ≠ activation | 过度解释 |
最终一句话
对于 scRNA-seq、Stereo-seq和Visium HD,分析非编码基因时最需要避免的误区是:
进一步:
最终:
所以,非编码基因最大的分析影响不是简单的“它们没用”,而是会改变对数据质量、有效信息量和下游生物学结论的判断。
尤其是针对 Stereo-seq / Visium HD 空间微环境分析,最应该建立的思维是:
不要用“Median genes/cell(或 genes/bin)高不高”评价数据是否适合做细胞亚群和niche分析,而应该进一步判断:真正能够定义细胞身份和细胞状态的marker是否被稳定、特异地检测到了。
如果要进一步做严谨的数据分析,下一步就应该把这个框架落到 Seurat/Scanpy 的具体流程上:例如哪些 MALAT1/NEAT1/XIST/GAS5/RPL/RPS/MT 应该在 QC、HVG、PCA、annotation、niche 分析的哪个阶段处理,以及 scRNA、Stereo-seq、Visium HD分别应该怎么过滤非编码基因。
生活很好,有你更好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号