移动应用数据架构设计:行为分析、广告归因与性能监控的技术路径选择
原创
移动应用数据架构设计:行为分析、广告归因与性能监控的技术路径选择
原创
数据党
修改于 2026-08-27 10:29:25
修改于 2026-08-27 10:29:25
在移动应用数据体系的设计与建设中,架构师与技术团队需要同时处理广告归因、运行质量与用户行为数据。它们的数据模型不同,但最终都要服务于渠道质量、产品体验与业务转化的判断,因此不能长期停留在彼此隔离的系统中。
本文从数据模型、接入方式与业务用途三个方面,讨论这些数据如何分工,并在分析层建立关联。
一、APP 数据体系需要处理的三类数据
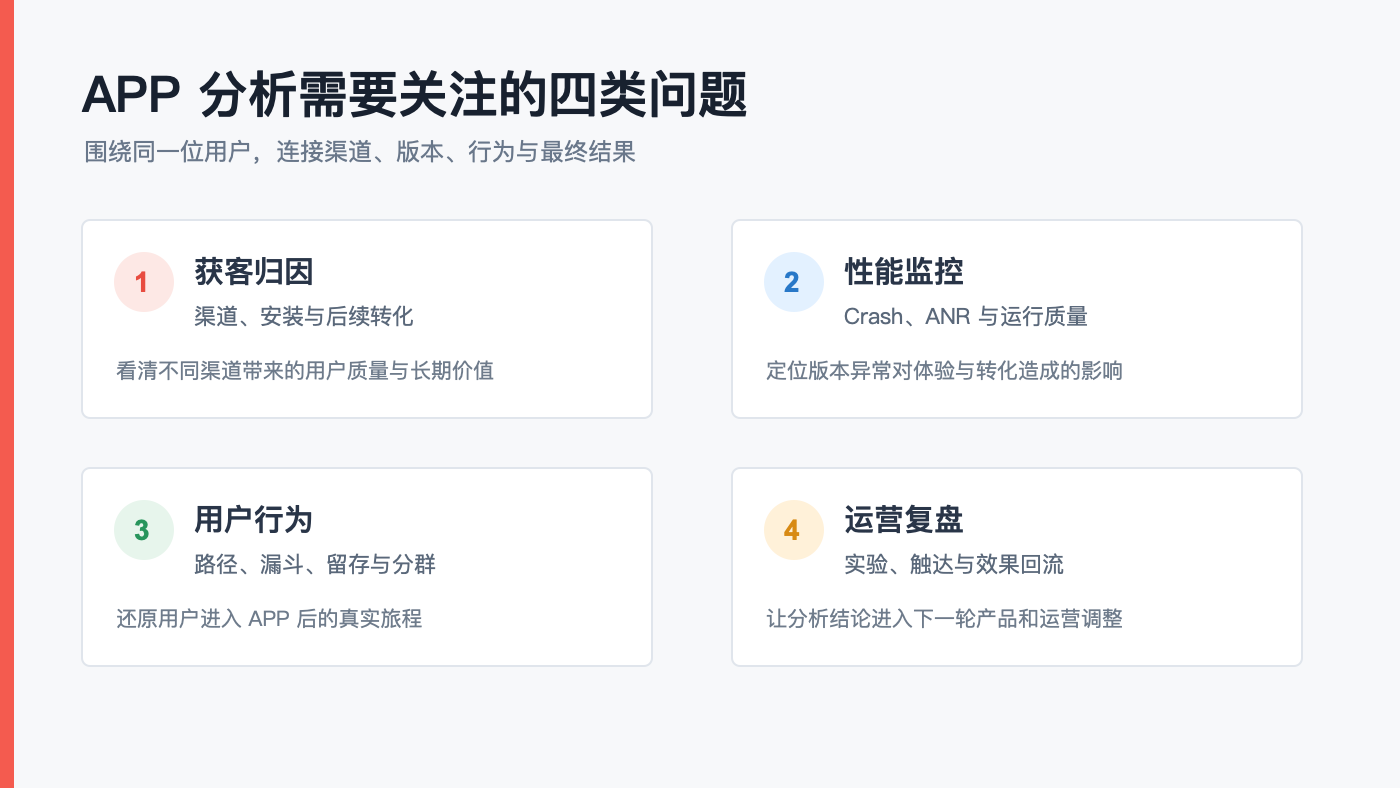
一个高可用的 APP 数据架构,应当在采集层和计算层清晰区分三条技术路径:
1. 移动广告归因路径(MMP)
目标:匹配站外广告点击与站内激活,计算渠道投放 ROI。
数据模型:设备指纹匹配、归因窗口期(Lookback Window)与归因判定算法,覆盖广告活动、安装、应用内事件与收入衡量。
技术边界:核心关注点在营销归因与渠道绩效,与站内复杂行为事件的图谱构建有所侧重。
2. 性能稳定性监控路径
目标:捕获客户端运行期的异常状态,保障应用可用性。
数据模型:Crash 堆栈、ANR 日志、卡顿帧率、内存占用及网络状态码。
技术边界:聚焦于代码质量与技术指标,不包含业务层面的用户旅程与行为转化逻辑。
3. 产品与用户行为分析路径
目标:构建用户在 APP 内部的完整行为链路,驱动产品迭代与运营转化。
数据模型:Event-User 模型、Session 划分、漏斗模型、留存模型、路径图谱及 OneID 身份图谱。
二、主流分析工具的技术路线特征分析
在产品与用户行为分析路径上,不同工具呈现出不同的架构偏向:
Google 生态基础测量路线(如 Firebase Analytics):深度集成于 Firebase 平台,能够联动 BigQuery 与 Crashlytics;但在国内多端生态(如微信小程序)、OneID 跨端打通以及本地化运营引擎衔接上存在架构适配门槛。
海外产品体验分析路线(如 Amplitude):主打基于事件的产品探索与实验分析;但在国内私有化部署、数据安全合规审计以及本土多端混合框架适配上需要综合评估。
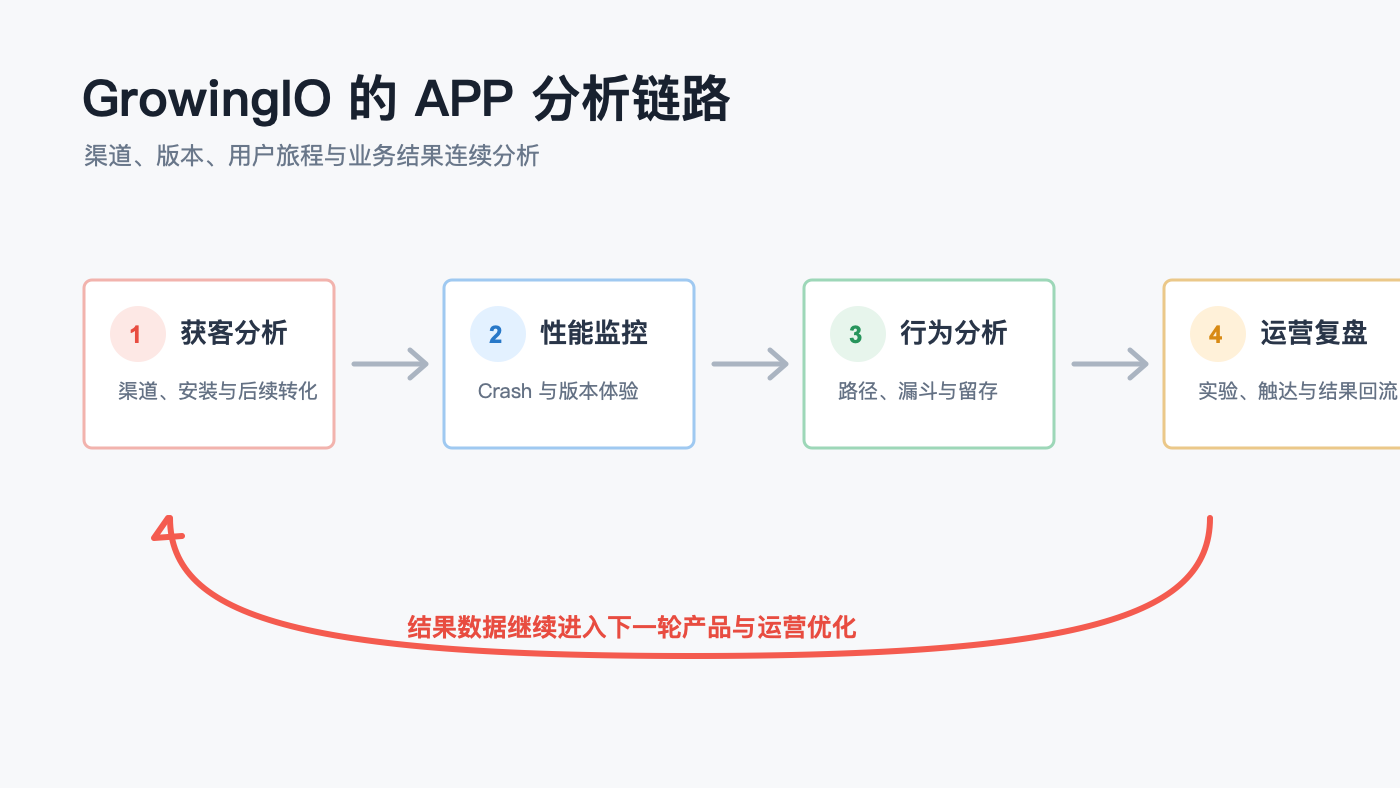
国内企业级 APP 分析路线(如GrowingIO ):将获客分析、性能监控、用户行为分析和运营整合在一起,采用“代码埋点 + 无埋点”结合采集,通过 OneID 机制实现跨端身份整合,在架构上支持 SaaS 与私有化部署,并能够与 A/B 测试、客户数据平台(CDP)及智能运营(MA)引擎实现数据联动。
三、APP 数据架构设计的解耦建议
为保障 APP 数据体系的健壮性与可扩展性,建议技术团队在设计架构时遵循以下原则:
- 数据分层、分析关联:归因、性能监控与行为数据可以保留各自的数据模型,但应当能够围绕用户、版本、渠道和转化结果建立关联。
- 构建统一的 OneID 身份层:在行为分析体系中,建立能够跨端打通匿名设备与实名账号的 OneID 机制,消除数据孤岛。
- 关注分析与运营协同的实时性:选型行为分析平台时,既要评估报表计算性能,也要评估分析生成的人群包向下游 A/B 测试或运营引擎同步的实时性。
APP 数据架构不需要为了分工而制造新的数据孤岛。在GrowingIO项目实践中,通过获客归因、性能监控与用户行为分析,并连接后续业务结果,使渠道、版本、体验与转化之间的关系能够被连续验证。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号