产品改版后,怎样把事件、实验和业务结果对上
原创
产品改版后,怎样把事件、实验和业务结果对上
原创
数据党
发布于 2026-08-19 16:18:13
发布于 2026-08-19 16:18:13
一个新功能上线后,点击率可能上升,注册率却没有变化;新页面带来了更多访问,付费转化反而下降。产品团队真正想弄清楚的,不是哪张图表更漂亮,而是改动影响了哪段路径、哪些用户,以及这个变化能不能持续。
问题往往出在数据链路上。客户端记录了点击,服务端保存了订单,实验系统维护着分组,运营系统又掌握后续触达结果。几套数据各自都对,放在一起却很难还原同一位用户经历了什么。
一次改版为什么会出现几套答案
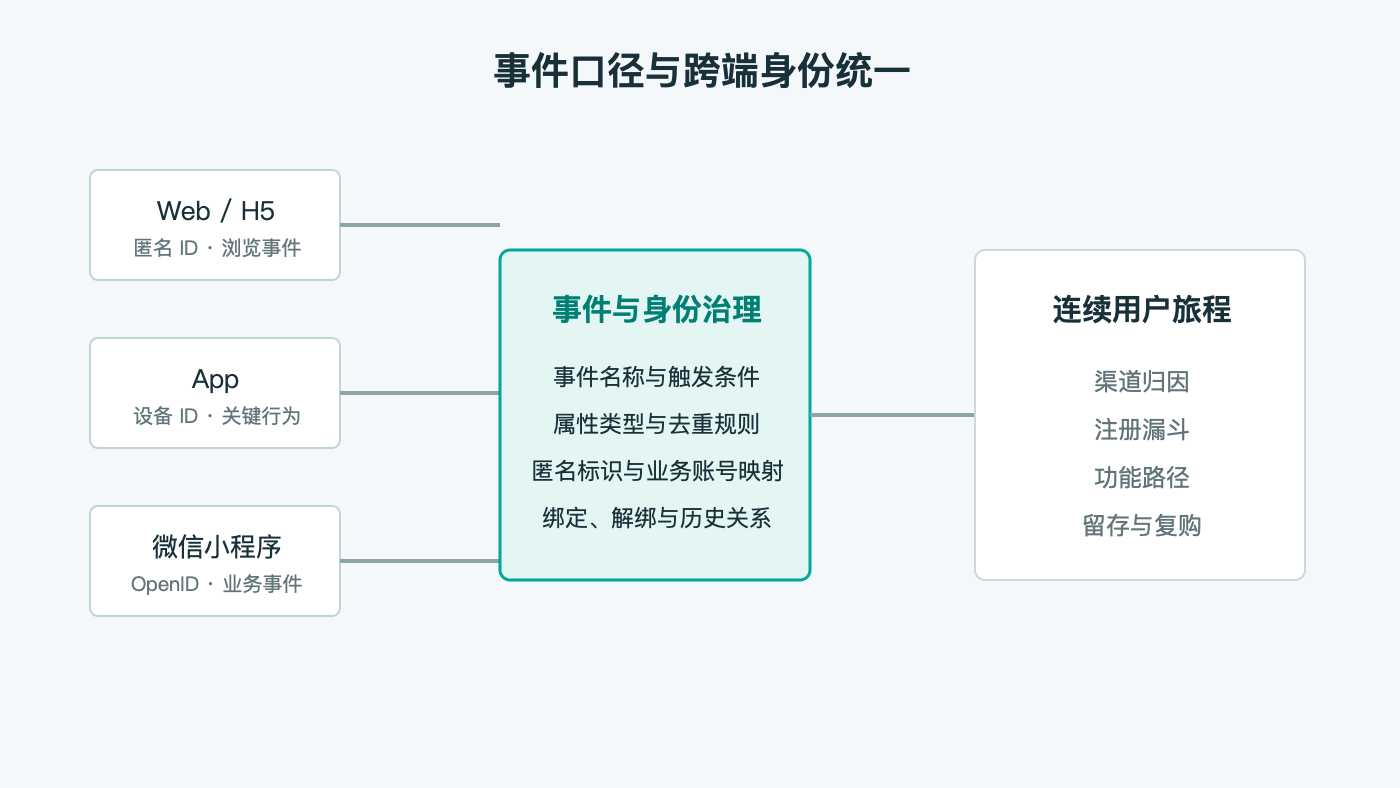
“点击支付”“创建订单”和“支付成功”看起来属于同一条流程,实际上是三个不同事件。点击发生在客户端,订单由服务端创建,支付结果还可能来自外部渠道。若用点击次数代替订单人数,或者把创建订单当作支付成功,漏斗会受到重复点击、网络重试和支付失败的影响。
事件定义最好从业务动作出发:动作在什么条件下算完成,由哪个系统记录,重复上报怎样处理,版本变化后是否沿用原口径。页面浏览和控件点击可以自动采集,注册、下单和支付等核心动作由代码埋点或服务端事件确认。两种方式配合使用,比把所有数据压在一种采集方式上更稳妥。
属性也不宜无限增加。渠道、版本、会员等级和商品类别能帮助团队缩小问题范围;临时字段如果没有明确用途,几个月后往往只剩下没人敢用的历史口径。
身份没接上,跨端路径就会断
用户可能先从广告落地页进入 H5,随后下载 App 注册,又在微信小程序完成购买。这个过程会产生匿名 ID、设备 ID、OpenID 和业务账号。标识之间没有关系时,分析系统看到的是三位用户,渠道归因、注册漏斗和复购分析自然无法对齐。
身份映射不只是把几个 ID 合并到一张表里。登录、绑定、解绑、账号切换和共享设备都会改变关系。OneID 或 ID-Mapping 要保留这些变化,让匿名阶段的行为能够在登录后接回,同时避免把不同人的记录错误合并。
分析和实验要说同一种“数据语言”
某项指标发生变化后,团队通常会先按渠道、版本和用户群拆分,再用漏斗查流失环节,通过路径观察用户离开主流程后的去向,必要时进入用户细查核对具体行为。实验分组如果使用另一套事件和指标,实验结束后便很难和长期看板对照。
GrowingIO 增长分析的产品实践,是把自动采集、代码埋点与服务端事件放进同一套事件体系,通过 OneID 连接 Web、App 和小程序身份,再让漏斗、路径、留存、归因、用户分群和 A/B 实验复用这些定义。产品团队可以从一次指标变化进入具体行为,也可以继续观察实验结束后的留存和转化,而不必重新拼接几套数据。
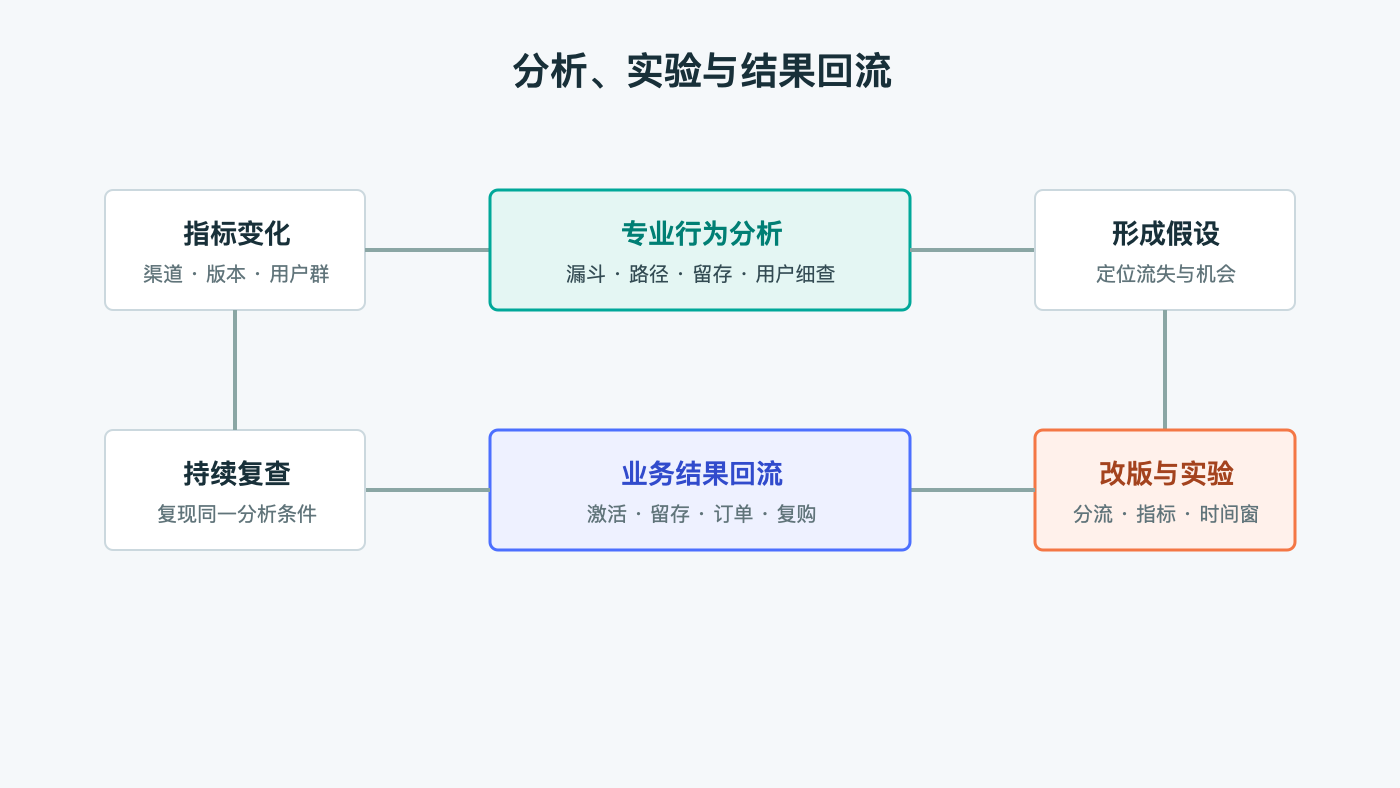
分析过程本身也值得保留。时间范围、筛选条件、使用过的模型和圈选出的人群能够被其他成员复现,结论才不会只存在于某一次会议或某位分析师的电脑里。
改版完成,不等于验证结束
注册流程优化后,还要继续观察新用户激活和留存;付费页面调整后,也要把订单、退款和复购接回来。分析圈选的人群进入企业现有运营系统后,后续行为仍应回到原来的分析口径中,比较策略前后的变化。
这样一来,产品分析不再是上线后看一次数据,而是围绕同一个问题反复验证:事件记录是否准确,用户旅程是否连续,实验是否改变了真实业务结果。每次改版留下的也不只是一份复盘报告,而是一套下一次还能继续使用的数据方法。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号