3万字吃透RabbitMQ,最详细的RabbitMQ讲解(VIP典藏版)
原创
3万字吃透RabbitMQ,最详细的RabbitMQ讲解(VIP典藏版)
原创
曾高飞
发布于 2026-05-07 17:42:08
发布于 2026-05-07 17:42:08
前言
早在之前就了解到了消息中间件,但是一直没有系统的学习,最近花了一段时间系统学习了当下最为主流的 RabbitMQ 消息队列,学习过程中也随时记录,刚开始学习的时候懵懵懂懂,做的笔记都比较杂乱,系统学习完后我将笔记内容不断反复修改,对章节进行设计调整,最终整合出了以下好理解、案例多、超详细的 RabbitMQ 学习笔记,希望能帮到大家~
一、MQ相关的概念
RabbitMQ 是一种分布式消息中间件,消息中间件也称消息队列MQ,那么什么是MQ呢?我们这节来探讨一下。
1.1、MQ的基本概念
什么是MQ
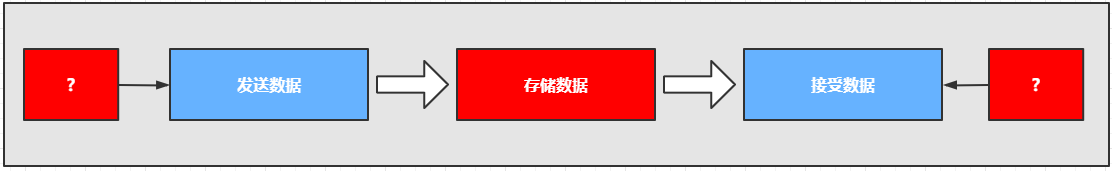
MQ(message queue),从字面意思上看就个 FIFO 先入先出的队列,只不过队列中存放的内容是 message 而已,它是一种具有接收数据、存储数据、发送数据等功能的技术服务。
img
在互联网架构中,MQ 是一种非常常见的上下游“逻辑解耦+物理解耦”的消息通信服务,用于上下游传递消息。使用了 MQ 之后,消息发送上游只需要依赖 MQ,不用依赖其他服务
为啥要用MQ
常见的MQ消息中间件有很多,例如ActiveMQ、RabbitMQ、Kafka、RocketMQ等等。那么为什么我们要使用它呢?因为它能很好的帮我解决一些复杂特殊的场景:
1️⃣ 高并发的流量削峰
举个例子,假设某订单系统每秒最多能处理一万次订单,也就是最多承受的10000qps,这个处理能力应付正常时段的下单时绰绰有余,正常时段我们下单一秒后就能返回结果。但是在高峰期,如果有两万次下单操作系统是处理不了的,只能限制订单超过一万后不允许用户下单。使用消息队列做缓冲,我们可以取消这个限制,把一秒内下的订单分散成一段时间来处理,这时有些用户可能在下单十几秒后才能收到下单成功的操作,但是比不能下单的体验要好。
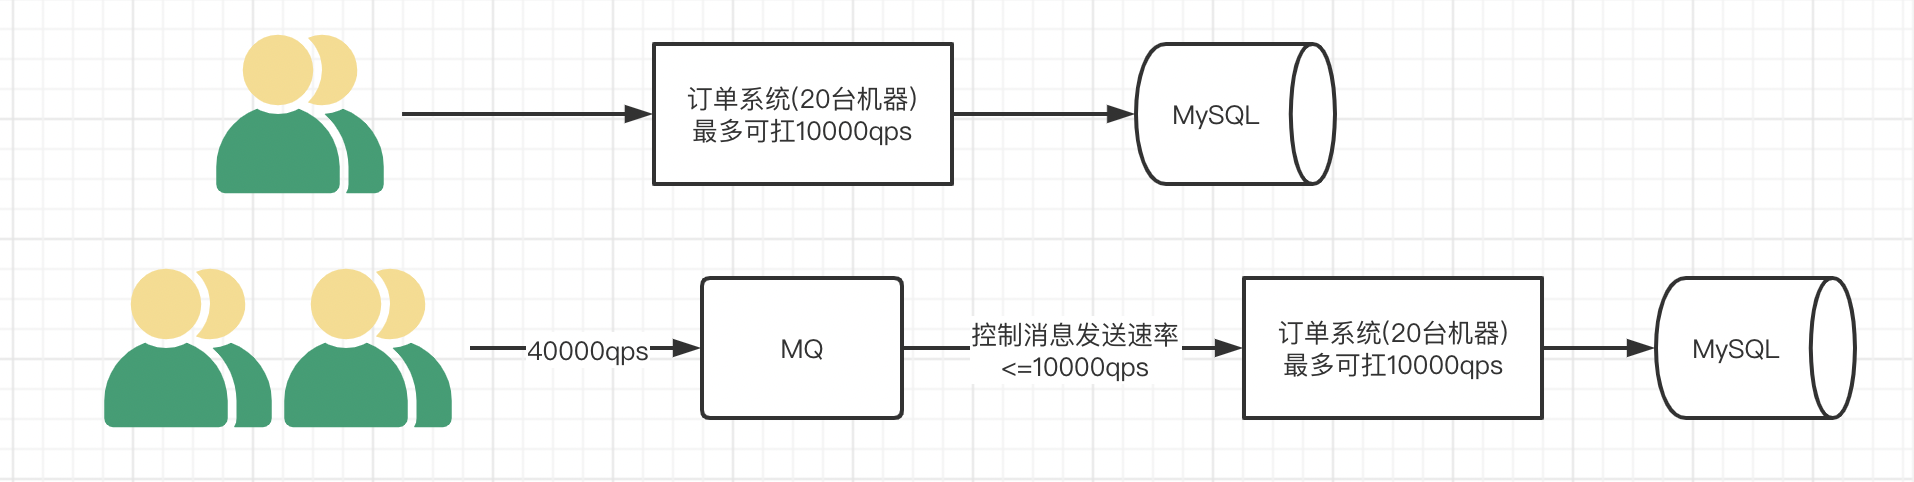
image-20211202204728303
2️⃣ 应用解耦
以电商应用为例,应用中有订单系统、库存系统、物流系统、支付系统。用户创建订单后,如果耦合调用库存系统、物流系统、支付系统,任何一个子系统出了故障,都会造成下单操作异常。当转变成基于消息队列的方式后,系统间调用的问题会减少很多,比如物流系统因为发生故障,需要几分钟来修复。在这几分钟的时间里,物流系统要处理的内存被缓存在消息队列中,用户的下单操作可以正常完成。当物流系统恢复后,继续处理订单信息即可,中单用户感受不到物流系统的故障,提升系统的可用性。
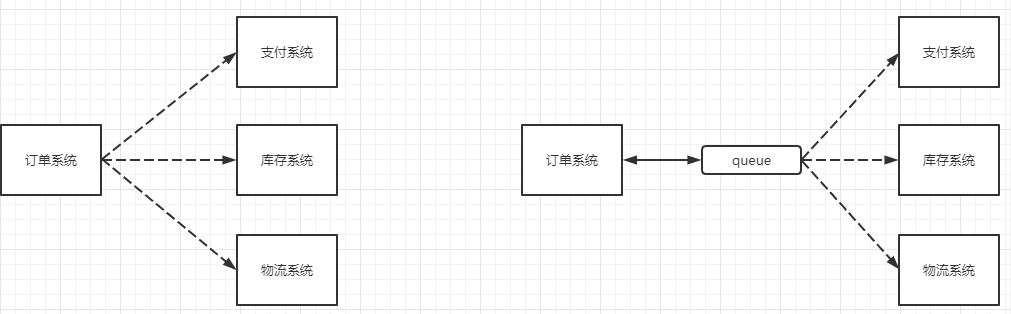
image-20211202202348810
3️⃣ 异步处理
有些服务间调用是异步的,例如 A 调用 B,B 需要花费很长时间执行,但是 A 需要知道 B 什么时候可以执行完,以前一般有两种方式,A 过一段时间去调用 B 的查询 api 查询。或者 A 提供一个 callback api, B 执行完之后调用 api 通知 A 服务。这两种方式都不是很优雅,使用消息队列,可以很方便解决这个问题,A 调用 B 服务后,只需要监听 B 处理完成的消息,当 B 处理完成后,会发送一条消息给 MQ,MQ 会将此消息转发给 A 服务。这样 A 服务既不用循环调用 B 的查询 api,也不用提供 callback api。同样B 服务也不用做这些操作。A 服务还能及时的得到异步处理成功的消息。

image-20211202202511197
4️⃣ 分布式事务
以订单服务为例,传统的方式为单体应用,支付、修改订单状态、创建物流订单三个步骤集成在一个服务中,因此这三个步骤可以放在一个jdbc事务中,要么全成功,要么全失败。而在微服务的环境下,会将三个步骤拆分成三个服务,例如:支付服务,订单服务,物流服务。三者各司其职,相互之间进行服务间调用,但这会带来分布式事务的问题,因为三个步骤操作的不是同一个数据库,导致无法使用jdbc事务管理以达到一致性。而 MQ 能够很好的帮我们解决分布式事务的问题,有一个比较容易理解的方案,就是二次提交。基于MQ的特点,MQ作为二次提交的中间节点,负责存储请求数据,在失败的情况可以进行多次尝试,或者基于MQ中的队列数据进行回滚操作,是一个既能保证性能,又能保证业务一致性的方案,如下图所示:
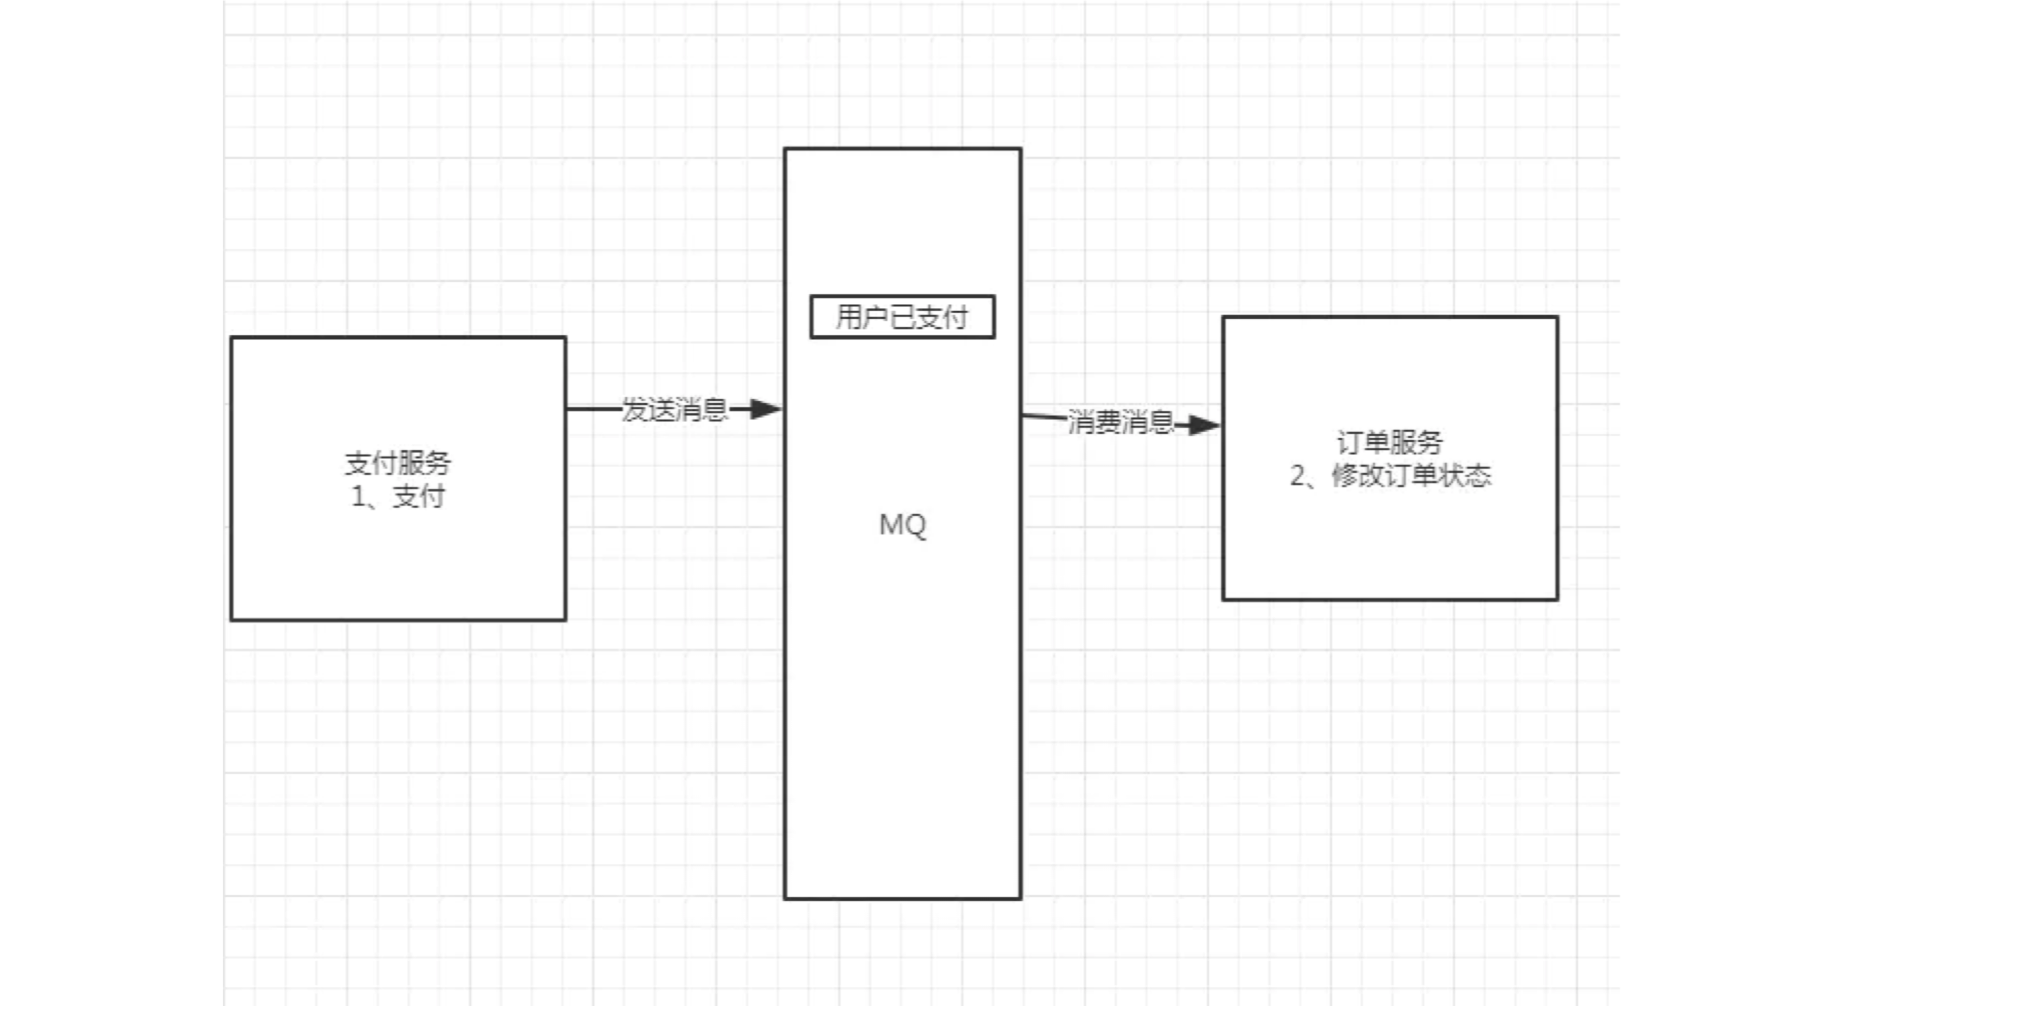
image-20211202203020022
5️⃣ 数据分发
MQ 具有发布订阅机制,不仅仅是简单的上游和下游一对一的关系,还有支持一对多或者广播的模式,并且都可以根据规则选择分发的对象。这样一份上游数据,众多下游系统中,可以根据规则选择是否接收这些数据,能达到很高的拓展性。
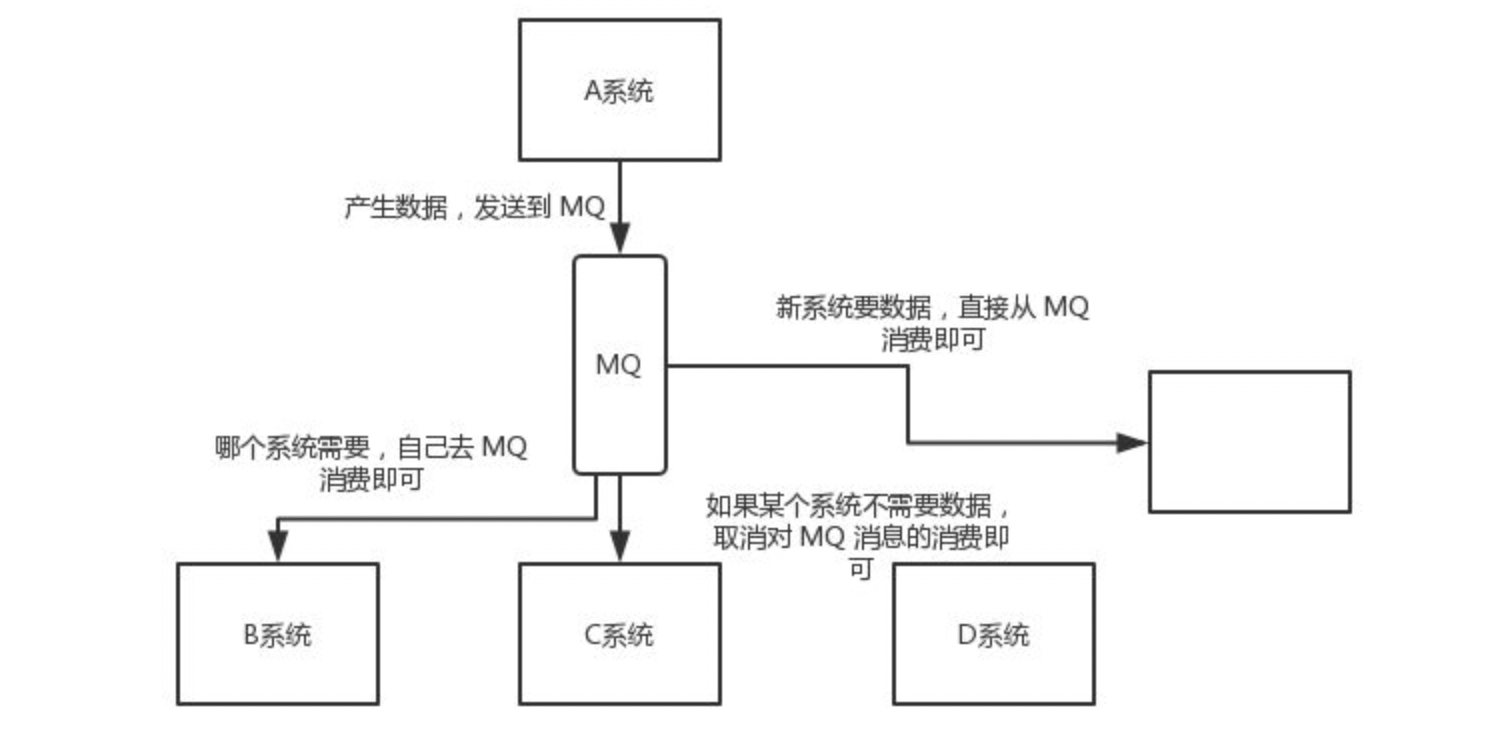
image-20211202204818011
常用的MQ
1️⃣ ActiveMQ
优点:单机吞吐量万级,时效性 ms 级,可用性高,基于主从架构实现高可用性,消息可靠性较低的概率丢失数据缺点:官方社区现在对 ActiveMQ 5.x 维护越来越少,高吞吐量场景较少使用。
2️⃣ Kafka
大数据的杀手锏,谈到大数据领域内的消息传输,则绕不开 Kafka,这款为大数据而生的消息中间件,以其百万级 TPS 的吞吐量名声大噪,迅速成为大数据领域的宠儿,在数据采集、传输、存储的过程中发挥着举足轻重的作用。目前已经被 LinkedIn,Uber, Twitter, Netflix 等大公司所采纳。
优点:性能卓越,吞吐量高,单机写入 TPS 约在百万条/秒,时效性 ms 级,可用性非常高;其次 kafka 是分布式的,一个数据多个副本,少数机器宕机,不会丢失数据导致服务不可用,消费者采用 Pull 方式获取消息,消息有序,通过控制能够保证所有消息被消费且仅被消费一次。此外 kafka 有优秀的第三方 Kafka Web 管理界面 Kafka-Manager,在日志领域比较成熟,被多家公司和多个开源项目使用;最后 kafka 在功能支持方便面它功能较为简单,主要支持简单的 MQ 功能,在大数据领域的实时计算以及日志采集被大规模使用。缺点:Kafka 单机超过 64 个队列/分区,Load 会发生明显的飙高现象,队列越多,load 越高,发送消息响应时间变长,使用短轮询方式,实时性取决于轮询间隔时间,消费失败不支持重试;支持消息顺序,但是一台代理宕机后,就会产生消息乱序,社区更新较慢;选用场景:Kafka 主要特点是基于Pull 的模式来处理消息消费,追求高吞吐量,一开始的目的就是用于日志收集和传输,适合产生大量数据的互联网服务的数据收集业务。大型公司建议可以选用,如果有日志采集功能,肯定是首选 kafka 了。
3️⃣ RocketMQ
RocketMQ 出自阿里巴巴的开源产品,用 Java 语言实现,在设计时参考了 Kafka,并做出了自己的一些改进。被阿里巴巴广泛应用在订单,交易,充值,流计算,消息推送,日志流式处理,binglog 分发等场景。
优点:单机吞吐量十万级,可用性非常高,采用分布式架构,消息可以做到 0 丢失,MQ 功能较为完善,扩展性好,支持 10 亿级别的消息堆积,不会因为堆积导致性能下降,采用 java 语言实现。缺点:支持的客户端语言不多,目前是 java 及 c++,其中 c++不成熟;社区活跃度一般,没有在MQ核心中去实现 JMS 等接口,有些系统要迁移需要修改大量代码。选用场景:天生为金融互联网领域而生,对于可靠性要求很高的场景,尤其是电商里面的订单扣款,以及业务削峰,在大量交易涌入时,后端可能无法及时处理的情况。RoketMQ 在稳定性上可能更值得信赖,这些业务场景在阿里双 11 已经经历了多次考验,如果你的业务有上述并发场景,建议可以选择 RocketMQ。
4️⃣ RabbitMQ
2007 年发布,是一个在AMQP(高级消息队列协议)基础上完成的,可复用的企业消息系统,是当前最主流的消息中间件之一。
优点:由于 erlang 语言的高并发特性,性能较好;吞吐量到万级,MQ 功能比较完备、健壮、稳定、易用、跨平台、支持多种语言如Python、Ruby、.NET、Java、JMS、C、PHP、ActionScript、XMPP、STOMP等,支持 AJAX 文档齐全;开源提供的管理界面非常棒,用起来很好用,社区活跃度高;更新频率相当高。缺点:商业版需要收费,学习成本较高。选用场景:结合 erlang 语言本身的并发优势,性能好时效性微秒级,社区活跃度也比较高,管理界面用起来十分方便,如果你的数据量没有那么大,中小型公司优先选择功能比较完备的 RabbitMQ。
1.2、消息队列协议
什么是协议
协议:是在TCP/IP协议基础之上构建的种约定成的规范和机制,目的是让客户端进行沟通和通讯。并且这种协议下规范必须具有持久性,高可用,高可靠的性能。
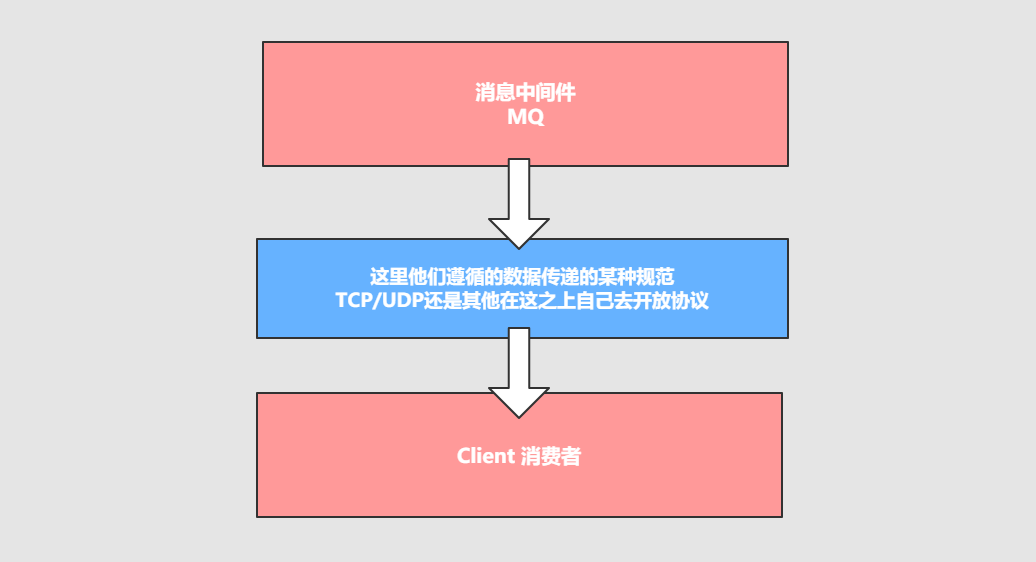
为什么不直接采用TCP/IP协议去传递消息?因为TCP/IP协议太过于简单,并不能承载消息的内容和载体,因此在此之上增加一些内容,给消息的传递分发高可用提供基础。
img
我们知道消息中间件负责数据的传递,存储,和分发消费三个部分,数据的存储和分发的过程中肯定要遵循某种约定成俗的规范,是采用底层的TCP/IP,UDP协议还是在这基础上自己构建等,而这些约定成俗的规范就称之为:协议。
所谓协议是指:
- 计算机底层操作系统和应用程序通讯时共同遵守的组约定,只有遵循共同的约定和规范,系统和底层操作系统之间才能相互交流。
- 和一般的网络应用程序的不同,它主要负责数据的接受和传递,所以性能比较的高。
- 协议对数据格式和计算机之间交换数据都必须严格遵守规范。
网络协议的三要素
- 语法:语法是用户数据与控制信息的结构与格式,以及数据出现的顺序。
- 语义:语义是解控制信息每个部分的意义。它规定了需要发出何种控制信息以及完成的动作与做出什么样的响应。
- 时序:时序是对事件发生顺序的详细说明。
类比http请求协议
- 语法:htp规定了请求报文和响应报文的格式
- 语义:客户端主动发起请求称之为请求。(这是一种定义,同时你发起的是post/get请求)
- 时序:一个请求对应个响应。(定先有请求在有响应,这个是时序)
而消息中间件采用的并不是http协议,而常见的消息中间件协议有:OpenWire、AMQP、MQTT、Kafka、OpenMessage协议
面试题:为什么消息中间件不直接使用http协议呢? 因为http请求报文头和响应报文头是比较复杂的,包含了cookie、数据的加密解密、状态码、晌应码等附加的功能,但是对于个消息而言,我们并不需要这么复杂,也没有这个必要性,它其实就是负责数据传递,存储,分发就够,要追求的是高性能。尽量简洁,快速。 大部分情况下http大部分都是短链接,在实际的交互过程中,一个请求到响应很有可能会中断,中断以后就不会就行持久化,就会造成请求的丢失。这样就不利于消息中间件的业务场景,因为消息中间件可能是一个长期的获取消息的过程,出现问题和故障要对数据或消息就行持久化等,目的是为了保证消息和数据的高可靠和稳健的运行。
常用消息中间件协议
1.AMQP协议(Advanced Message Queuing Protocol—高级消息队列协议)
它由摩根大通集团联合其他公司共同设计。是一个提供统一消息服务的应用层标准高级消息队列协议,是应用层协议的一个开放标准,为面向消息的中间件设计。基于此协议的客户端与消息中间件可传递消息,并不受客户端/中间件不同产品,不同的开发语言等条件的限制。
特性:分布式事务支、消息的持久化支持、高性能和高可靠的消息处理优势
AMQP典型的实现者是RabbitMQ、ACTIVEMQ等,其中RabbitMQ由Erlang开发
img
2.MQTT协议(Message Queueing Telemetry Transport—消息队列遥测传输协议)
它是一种基于发布/订阅(publish/subscribe)模式的"轻量级"通讯协议,该协议构建于TCP/IP协议上,由IBM在1999年发布。
特点:轻量、结构简单、传输快、不支持事务、没有持久化设计
应用场景:适用于计算能力有限、低带宽、网络不稳定的场景
支持者:RabbitMQ、ACTIVEMQ(默认情况下关闭,需要打开)
img
3.OpenMessage协议
是近几年由阿里、雅虎和滴滴出行、 Stremalio等公司共同参与创立的分布式消息中间件、流处理等领域的应用开发标准。
特点:结构简单、解析速度快、支持事务和持久化设计
4.Kafka协议
基于TCP/IP的二进制协议。消息内部是通过长度来分割,由些基本数据类型组成。
特点:结构简单、解析速度快、无事务支持、有持久化设计
1.3、消息队列持久化
持久化简单来说就是将数据存入磁盘,而不是存在内存中随服务器重启断开而消失,使数据能够永久保存。
img
常见的持久化方式和对比:
ActiveMQ | RabbitMQ | Kafka | RocketMQ | |
|---|---|---|---|---|
文件存储 | 支持 | 支持 | 支持 | 支持 |
数据库 | 支持 | / | / | / |
1.4、消息的分发策略
img
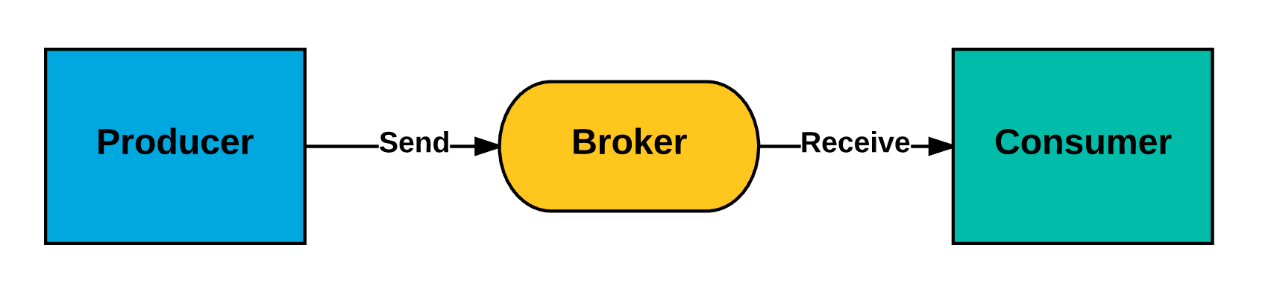
MQ消息队列有如下几个角色:
Producer:消息生产者。负责产生和发送消息到 BrokerBroker:消息处理中心。负责消息存储、确认、重试等,一般其中会包含多个 queueConsumer:消息消费者。负责从 Broker 中获取消息,并进行相应处理
生产者产生消息后,MQ进行存储,消费者如何获得消息呢?
一般的获取方式无外乎外推(push)或者(pull)两种方式,典型的git就有推拉机制,我们发送的http请求就是一种典型的拉取数据库数据返回的过程。而消息队列MQ是一种推送过程,而这些推机制会适用到很多的业务场景,也有很多对应的推机制策略
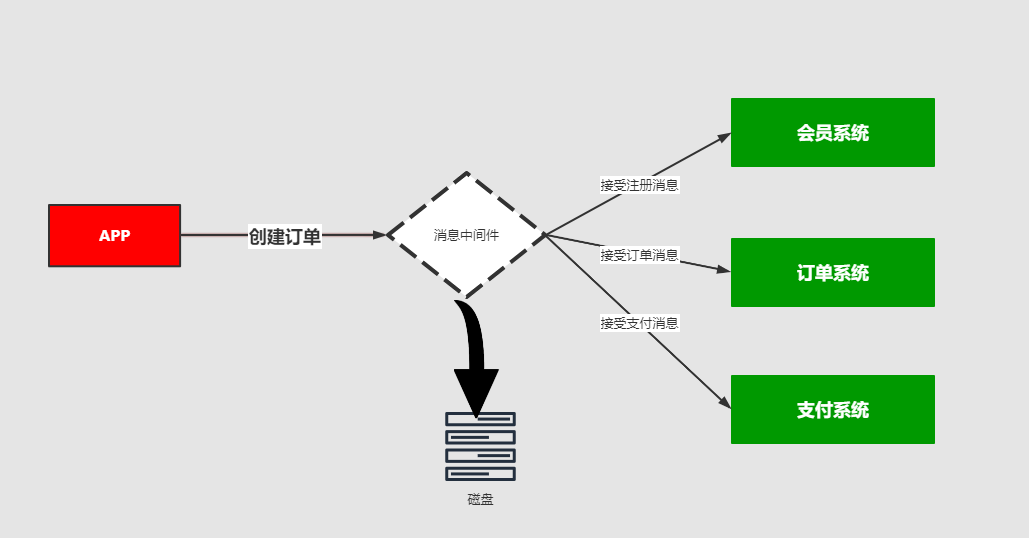
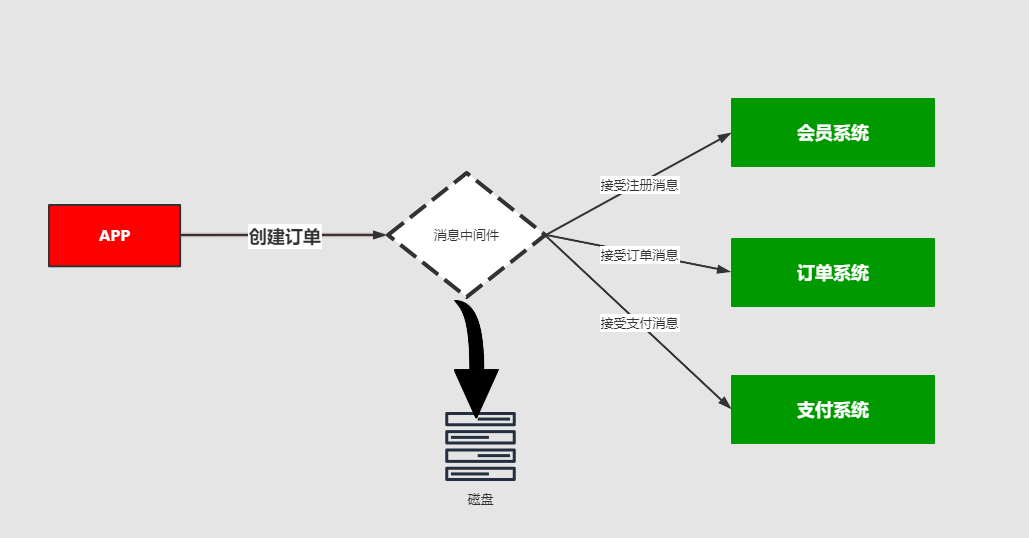
场景分析一
img
比如我在APP上下了一个订单,我们的系统和服务很多,我们如何得知这个消息被那个系统或者那些服务或者系统进行消费,此时就需要一个消费策略,或称为消费的方法论。
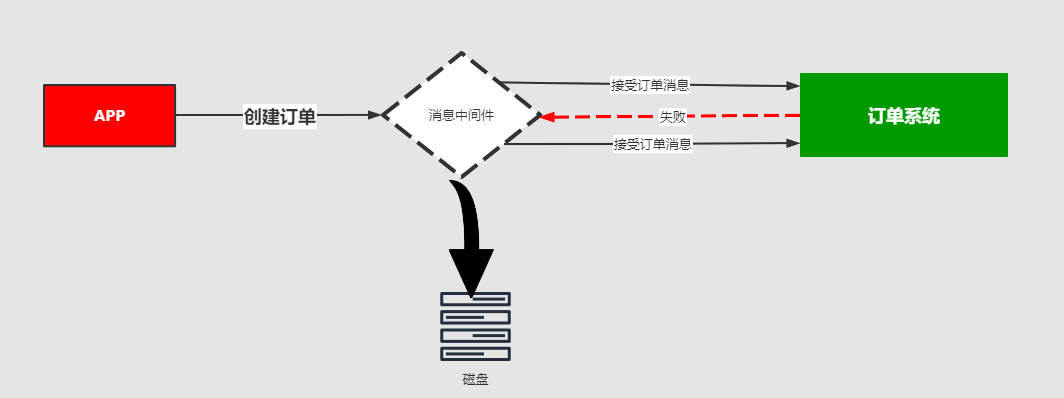
场景分析二
img
在发送消息的过程中可能会出现异常,或者网络的抖动,故障等等因为造成消息的无法消费,比如用户在下订单,消费MQ接受,订单系统出现故障,导致用户支付失败,那么这个时候就需要消息中间件就必须支持消息重试机制策略。也就是支持:出现问题和故障的情况下,消息不丢失还可以进行重发
📄 消息分发策略的机制和对比
ActiveMQ | RabbitMQ | Kafka | RocketMQ | |
|---|---|---|---|---|
发布订阅 | 支持 | 支持 | 支持 | 支持 |
轮询分发 | 支持 | 支持 | 支持 | / |
公平分发 | / | 支持 | 支持 | / |
重发 | 支持 | 支持 | / | 支持 |
消息拉取 | / | 支持 | 支持 | 支持 |
1.5、消息队列的高可用和高可靠
所谓高可用:是指产品在规定的条件和规定的时刻或时间内处于可执行规定功能状态的能力。 当业务量增加时,请求也过大,一台消息中间件服务器的会触及硬件(CPU、内存、磁盘)的极限,一台消息服务器你已经无法满足业务的需求,所以消息中间件必须支持集群部署,来达到高可用的目的。
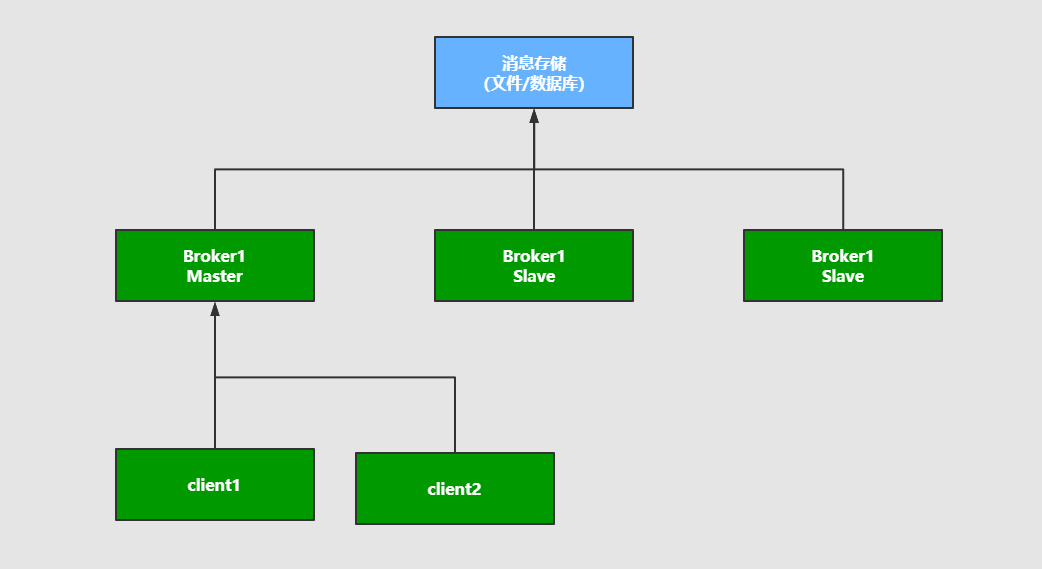
1️⃣ Master-slave主从共享数据的部署方式
img
将多个消息服务器Broker连接共享一块消息存储空间,其中Master节点负责消息的写入。客户端会将消息写入到Master节点,一旦Master挂掉,slave节点继续服务,从而形成高可用。
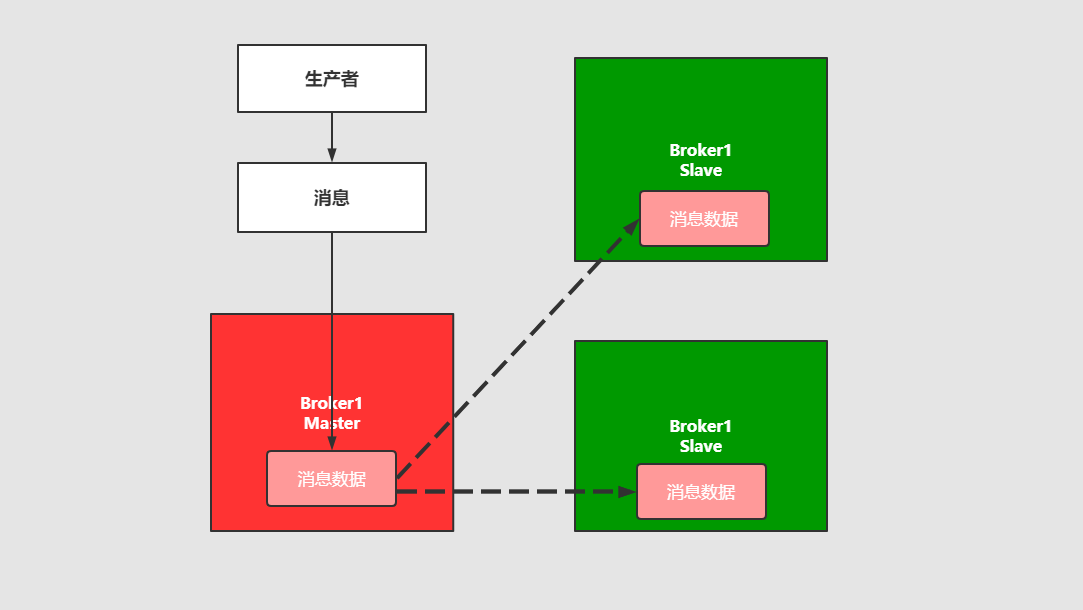
2️⃣ Master-slave主从同步部署方式
img
该模式写入消息同样在Master节点上,但是主结点会同步数据到slave节点形成副本,和zookeeper或者redis主从机制很类似。这样可以达到负载均衡的效果,如果消费者有多个,就可以到不同的节点进行消费,但是消息的拷贝和同步会占用很大的贷款和网络资源。在rabbitMQ中会有使用
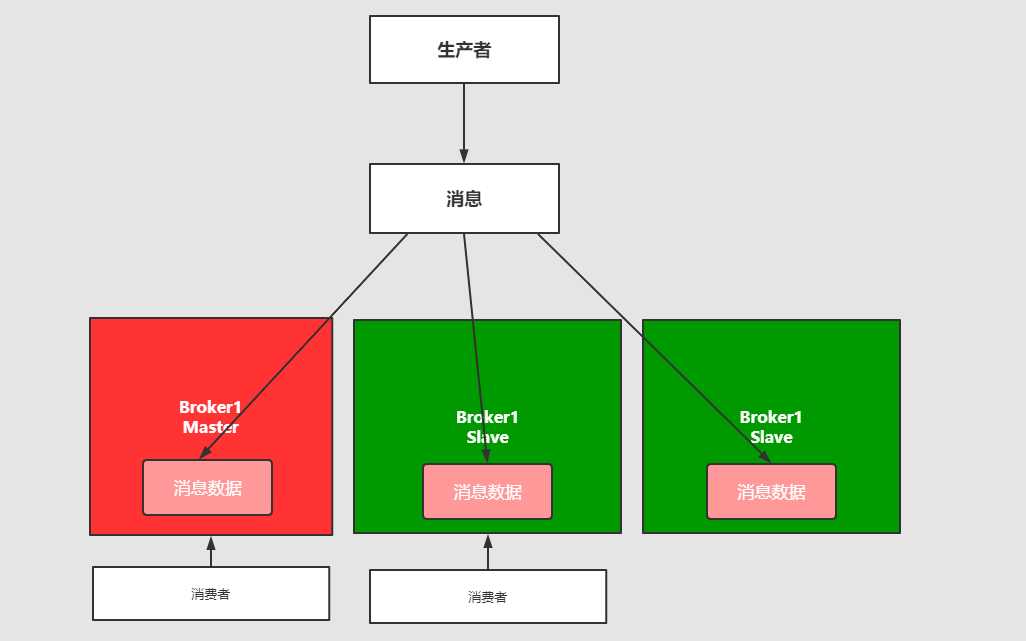
3️⃣ 多主集群同步部署模式
img
和上述方式区别不大,但是该方式任意节点都可以进行写入。
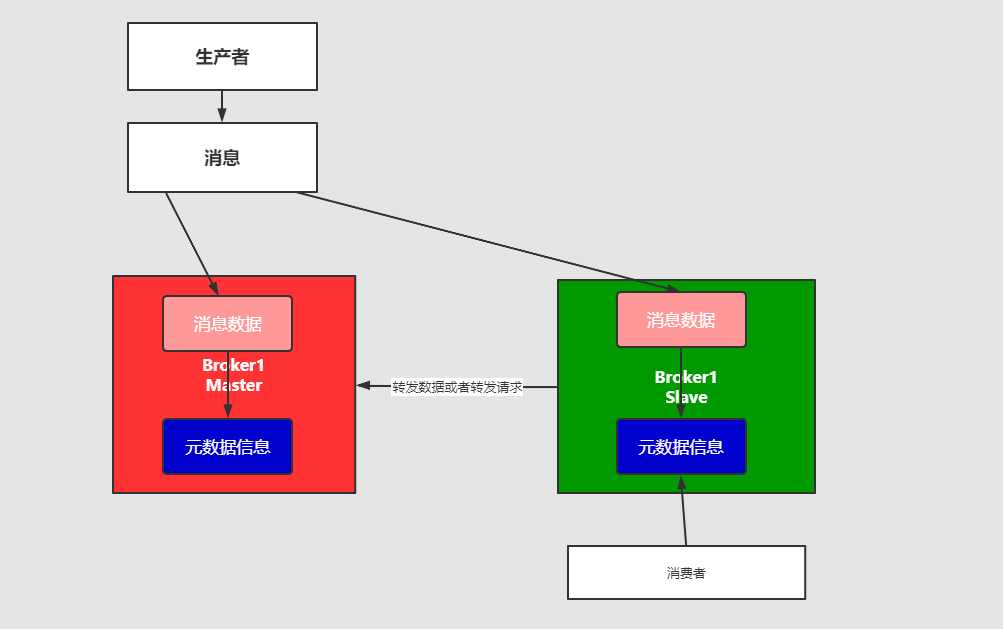
4️⃣ 多主集群转发部署模式
img
如果插入的数据是Broker1,元数据信息会存储数据的相关描述和记录存放的位置(队列),它会对描述信息,也就是元数据进行同步;
如果消费者在Broker2中进行消费,发现自己没有对应的消息,就会在自己的元数据信息中去查询,如果查询到了直接返回。如果没有查询到就会将该消息的信息携带在请求中转发到其他节点去询问,直到找到所需的信息为止。
场景:比如买火车票或者黄牛买演唱会门票,比如第一个黄牛没有顾客说要买的演唱会门票,但是他会去联系其他的黄牛询问,如果有就返回
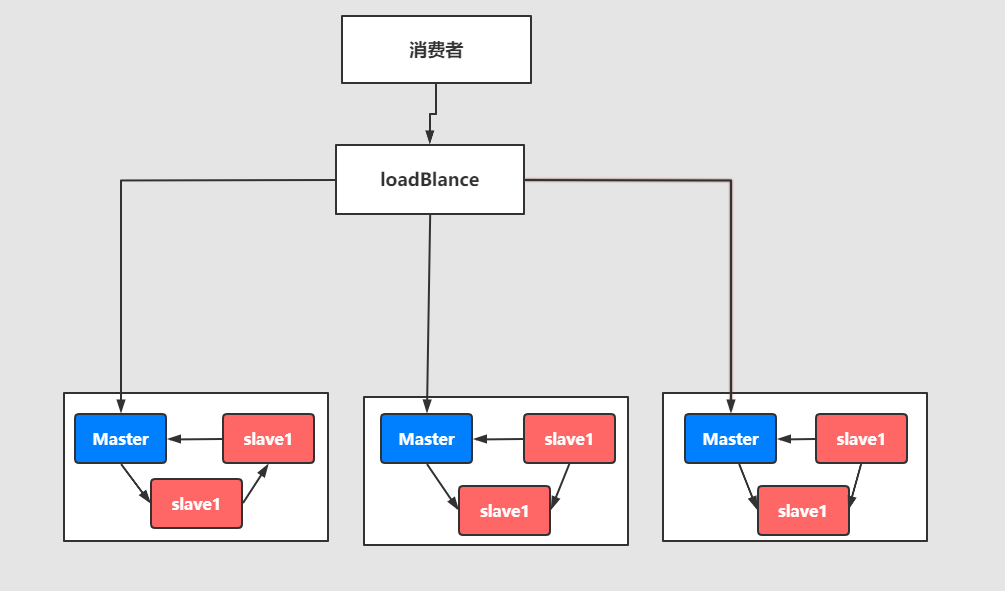
5️⃣ Master-slave与Breoker-cluster组合的方案
img
实现多主多从的热备机制来完成消息的高可用以及数据的热备机制,在生产规模达到定的阶段的时候,这种使用的频率比较高。
这些集群模式最终目的都是为保证:消息服务器不会挂掉,出现了故障依然可以抱着消息服务继续使用。反正终归三句话:
- 要么消息共享
- 要么消息同步
- 要么元数据兴享
二、RabbitMQ安装启动
关于RabbitMQ的安装:RabbitMQ超详细安装教程
三、RabbitMQ快速入门
3.1、RabbitMQ的概念
RabbitMQ 是一个消息中间件:它接受并转发消息。你可以把它当做一个快递站点,当你要发送一个包裹时,你把你的包裹放到快递站,快递员最终会把你的快递送到收件人那里,按照这种逻辑 RabbitMQ 是一个快递站,一个快递员帮你传递快件。RabbitMQ 与快递站的主要区别在于:它不处理快件而是接收,存储和转发消息数据。
3.2、AMQP协议
RabbitMQ是一种遵循AMQP协议的分布式消息中间件。AMQP 全称 “Advanced Message Queuing Protocol”,高级消息队列协议。它是应用层协议的一个开发标准,为面向消息的中间件设计。
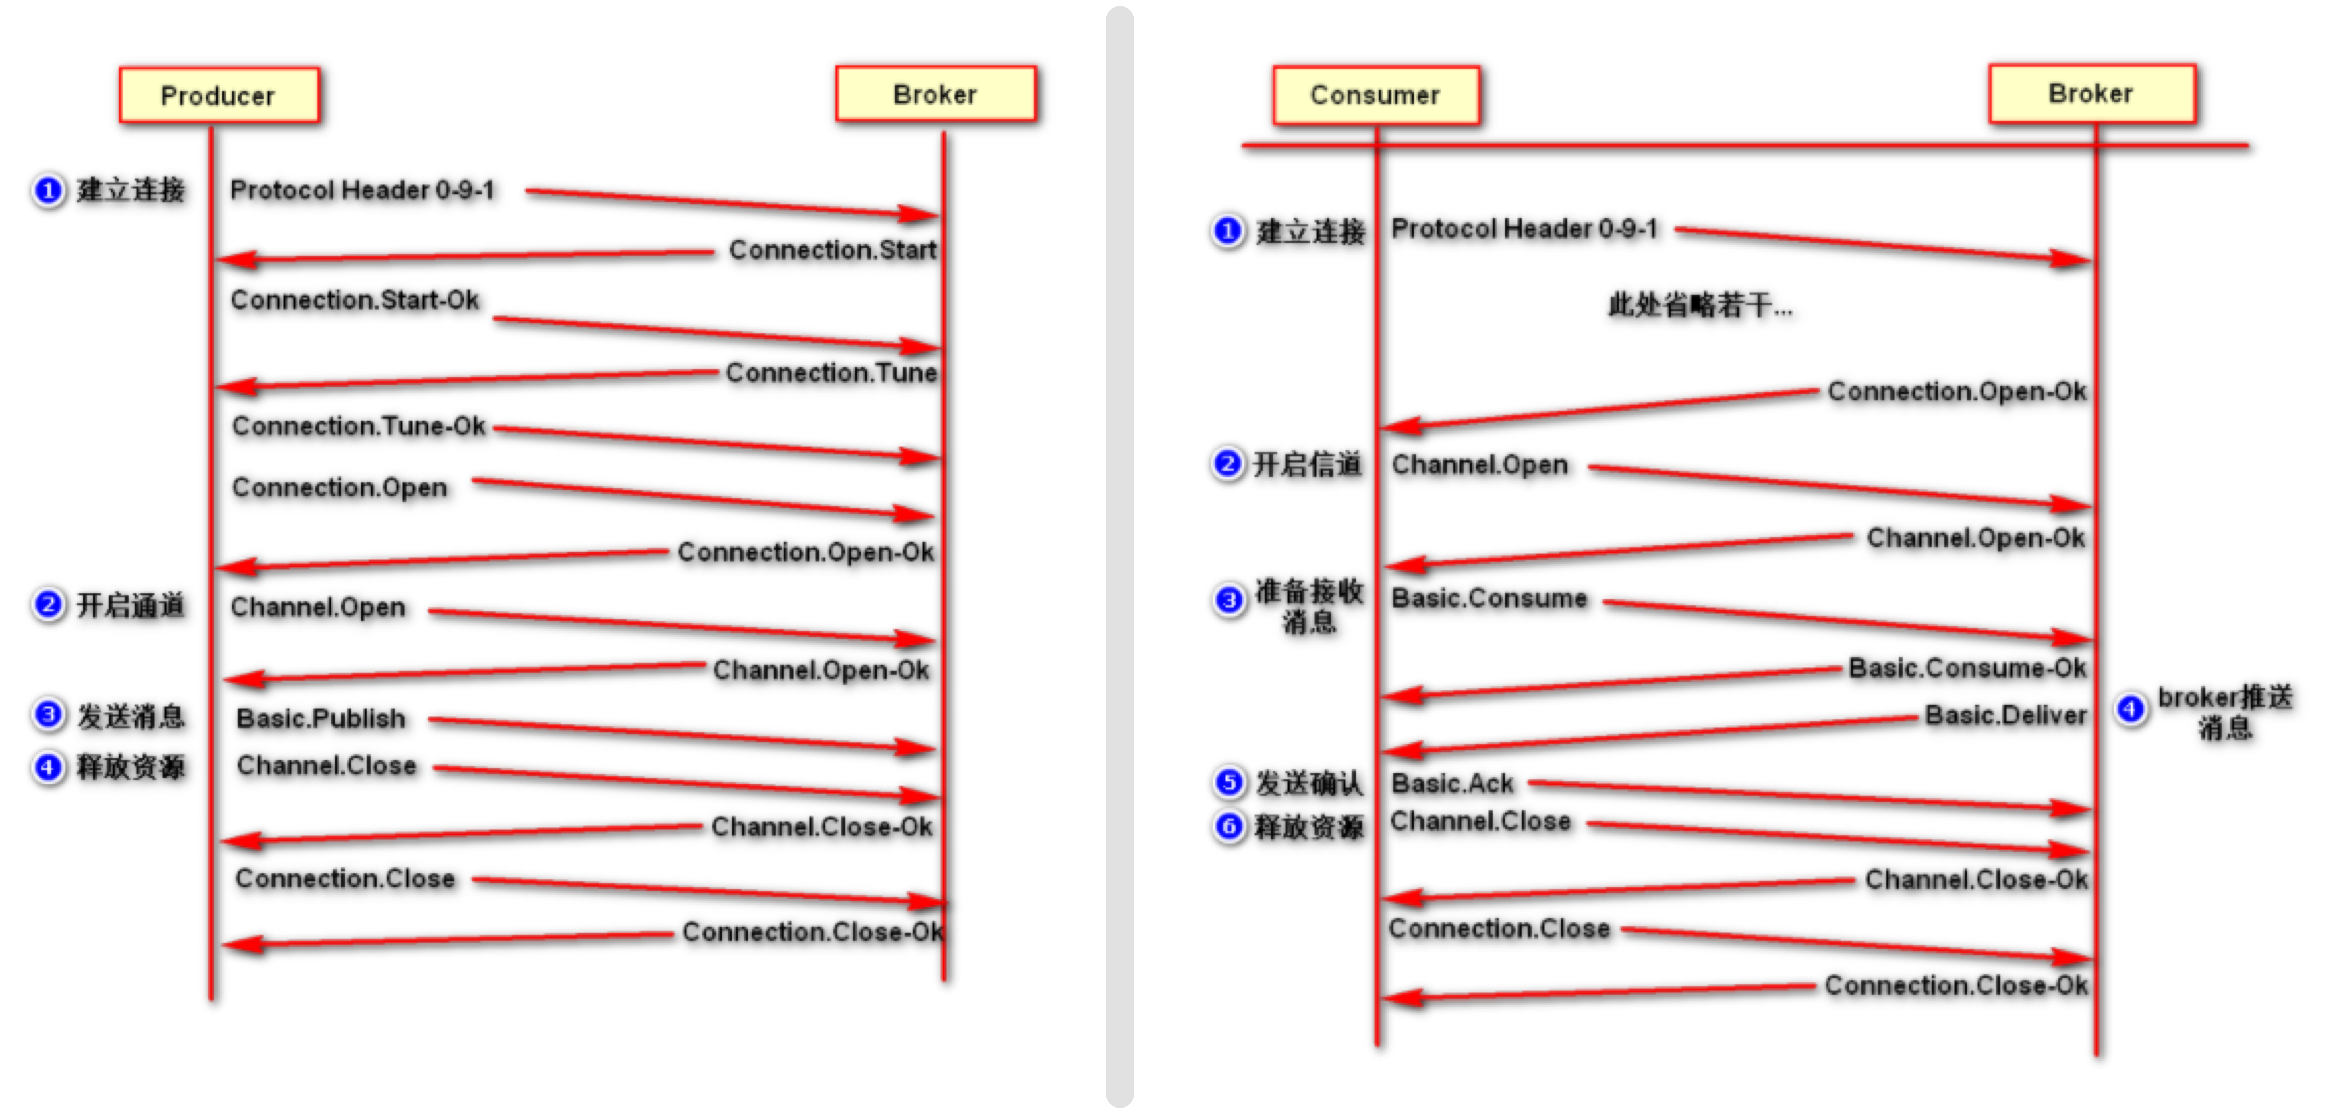
image-20211119144549525
3.3、RabbitMQ架构组成
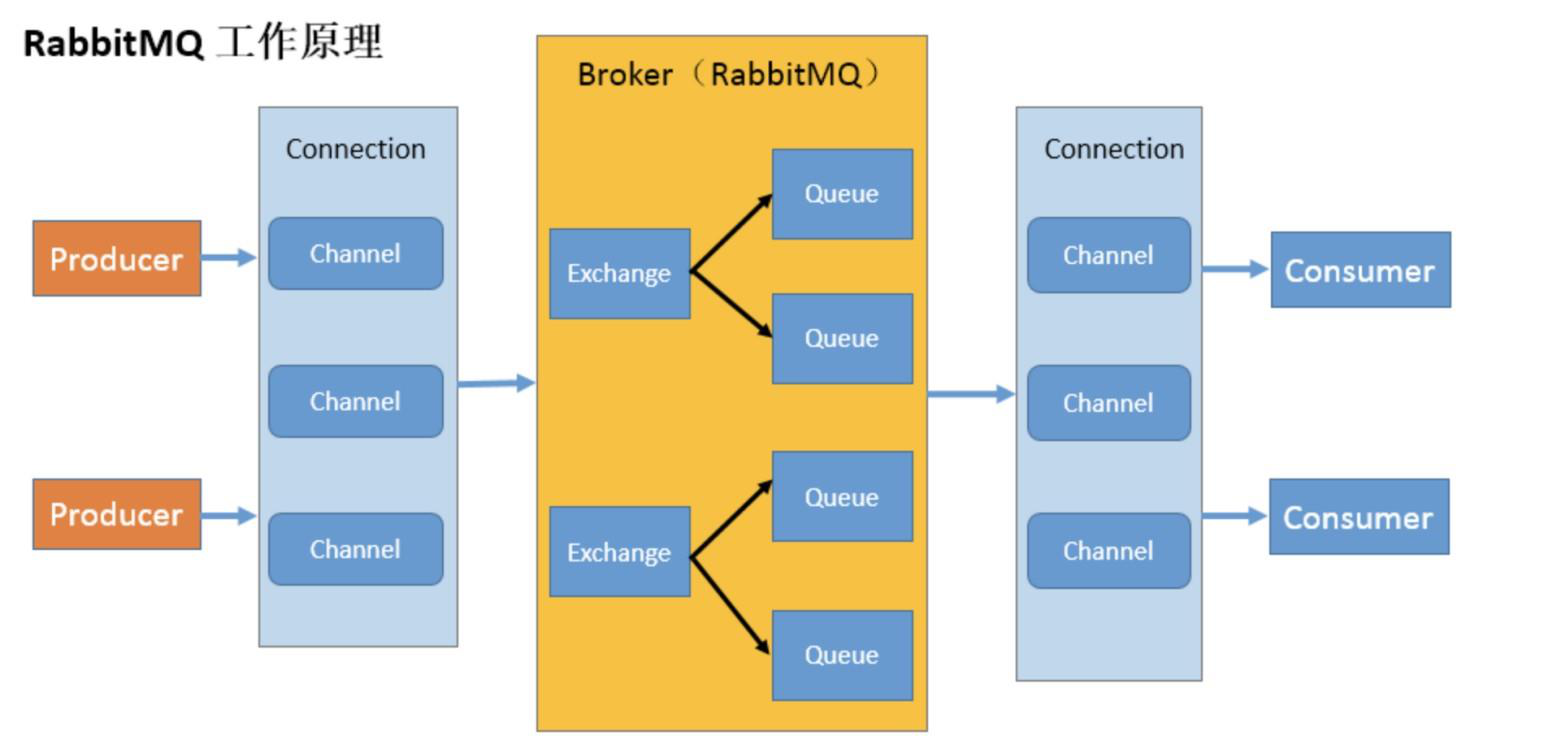
image-20211202211149794
Broker:就是 RabbitMQ 服务,用于接收和分发消息,接受客户端的连接,实现 AMQP 实体服务。Virtual host:出于多租户和安全因素设计的,把 AMQP 的基本组件划分到一个虚拟的分组中,类似于网络中的 namespace 概
念。当多个不同的用户使用同一个 RabbitMQ server 提供的服务时,可以划分出多个 vhost,每个用户在自己的 vhost 创建 exchange 或 queue 等。
Connection:连接,生产者/消费者与 Broker 之间的 TCP 网络连接。Channel:网络信道,如果每一次访问 RabbitMQ 都建立一个 Connection,在消息量大的时候建立连接的开销将是巨大的,效率也
较低。Channel 是在 connection 内部建立的逻辑连接,如果应用程序支持多线程,通常每个 thread 创建单独的 channel 进行通讯,AMQP method 包含了 channel id 帮助客户端和 message broker 识别 channel,所以 channel 之间是完全隔离的。Channel 作为轻量级的Connection 极大减少了操作系统建立 TCP connection 的开销。
Message:消息,服务与应用程序之间传送的数据,由Properties和body组成,Properties可是对消息进行修饰,比如消息的优先
级,延迟等高级特性,Body则就是消息体的内容。
Virtual Host:虚拟节点,用于进行逻辑隔离,最上层的消息路由,一个虚拟主机理由可以有若干个Exhange和Queue,同一个虚
拟主机里面不能有相同名字的Exchange
Exchange:交换机,是 message 到达 broker 的第一站,用于根据分发规则、匹配查询表中的 routing key,分发消息到 queue 中
去,不具备消息存储的功能。常用的类型有:direct、topic、fanout。
Bindings:exchange 和 queue 之间的虚拟连接,binding 中可以包含 routing key,Binding 信息被保存到 exchange 中的查询表
中,用于 message 的分发依据。
Routing key:是一个路由规则,虚拟机可以用它来确定如何路由一个特定消息Queue:消息队列,保存消息并将它们转发给消费者进行消费。
3.4、四大核心概念
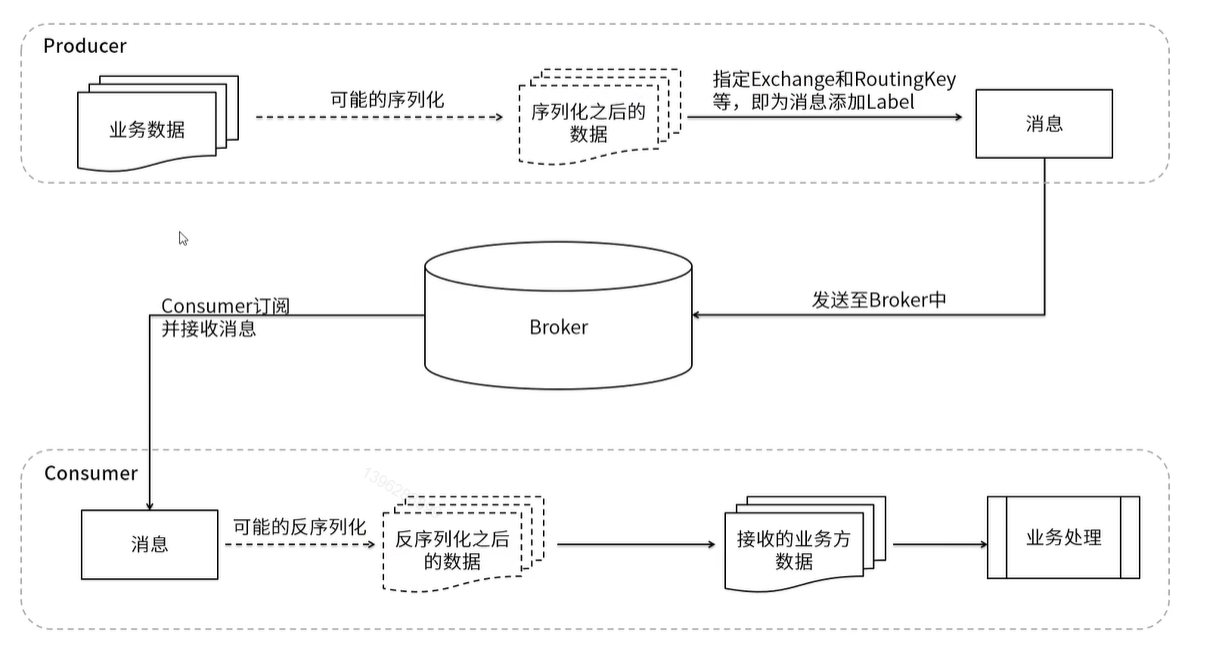
- 生产者:产生数据发送消息的程序是生产者。
- 交换机:交换机是 RabbitMQ 非常重要的一个部件,一方面它接收来自生产者的消息,另一方面它将消息推送到队列中。交换机必须确切知道如何处理它接收到的消息,是将这些消息推送到特定队列还是推送到多个队列,亦或者是把消息丢弃,这个是由交换机类型决定的。
- 队列:队列是 RabbitMQ 内部使用的一种数据结构,尽管消息流经 RabbitMQ 和应用程序,但它们只能存储在队列中。队列仅受主机的内存和磁盘限制的约束,本质上是一个大的消息缓冲区。许多生产者可以将消息发送到一个队列,许多消费者可以尝试从一个队列接收数据。
- 消费者:消费与接收具有相似的含义。消费者大多时候是一个等待接收消息的程序。请注意生产者,消费者和消息中间件很多时候并不在同一机器上。同一个应用程序既可以是生产者又是可以是消费者。
img
3.5、RabbitMQ角色分类
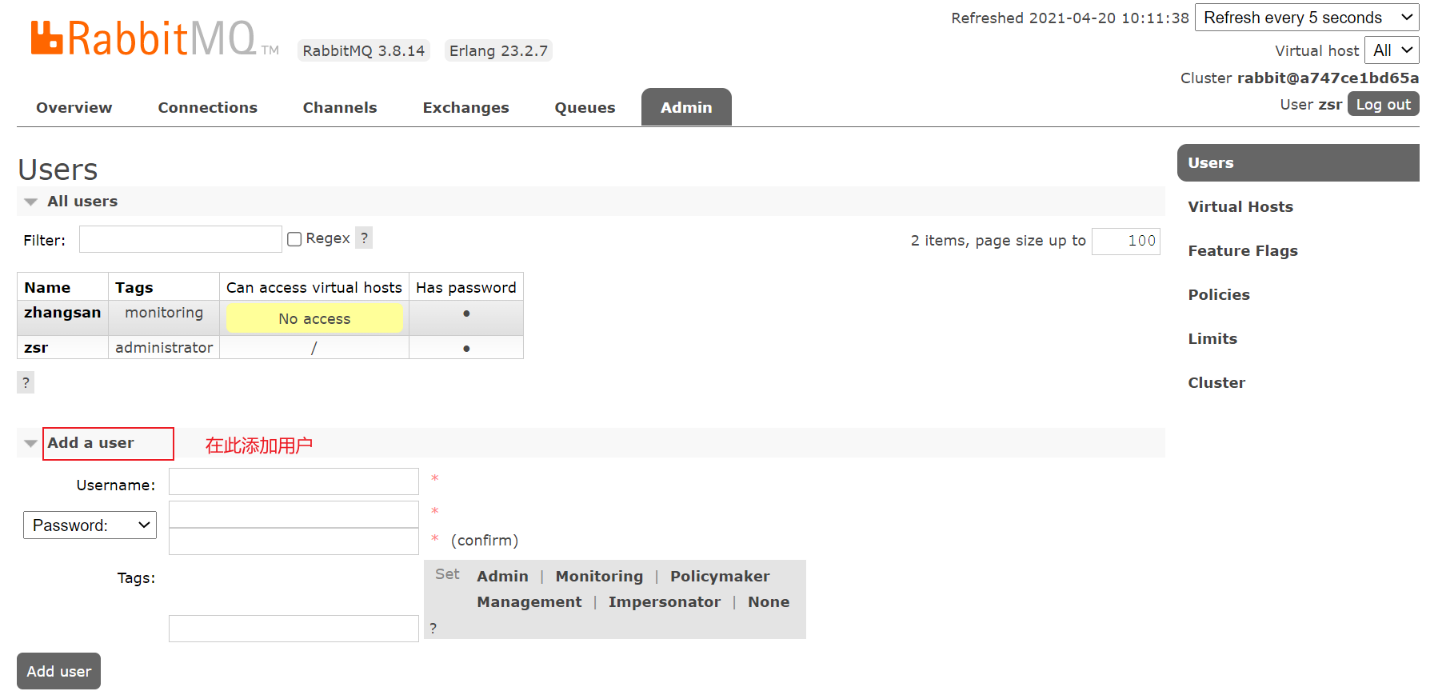
image-20210420101202131
none:不能访问 management pluginmanagement:查看自己相关节点信息- 列出自己可以通过AMQP登入的虚拟机
- 查看自己的虚拟机节点virtual hosts的queues,exchanges和bindings信息
- 查看和关闭自己的channels和connections
- 查看有关自己的虚拟机节点virtual hosts的统计信息。包括其他用户在这个节点virtual hosts中的活动信息
Policymaker - 包含management所有权跟
- 查看和创建和删除自己的virtual hosts所属的policies和parameters信息Monitoring
- 包含management所有权限
- 罗列出所有的virtual hosts,包括不能登录的virtual hosts
- 查看其他用户的connections和channels信息
- 查看节点级别的数据如clustering和memory使用情况
- 查看所有的virtual hosts的全局统计信息。
Administrator - 最高权限
- 可以创建和删除 virtual hosts
- 可以查看,创建和删除users
- 查看创建permissions
- 关闭所有用户的connections
3.6、RabbitMQ消息模式
官网:RabbitMQ Tutorials — RabbitMQ RabbitMQ提供6种模式,分别是 Hello World、Work Queues、Publish/Subscribe、Routing、Topics、RPC。本文详细讲述了前5种,并给出代码实现和思路。其中 Publish/Subscribe、Routing、Topics 三种模式可以统一归为 Exchange 模式,只是创建时交换机的类型不一样,分别是 fanout、direct、topic 三种交换机类型。
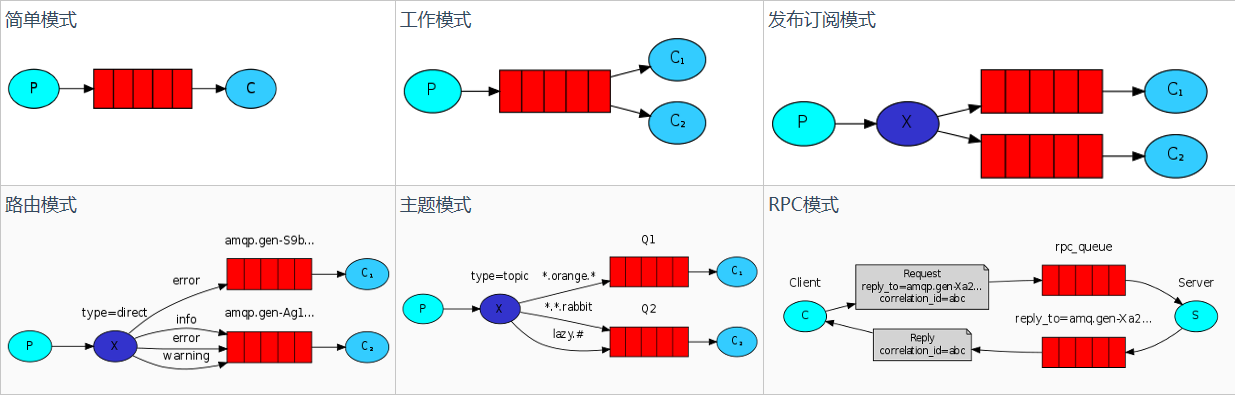
image-20210506152342994
注意:简单模式和工作模式虽然途中没有画出交换机,但是都会有一个默认的交换机,类型为direct
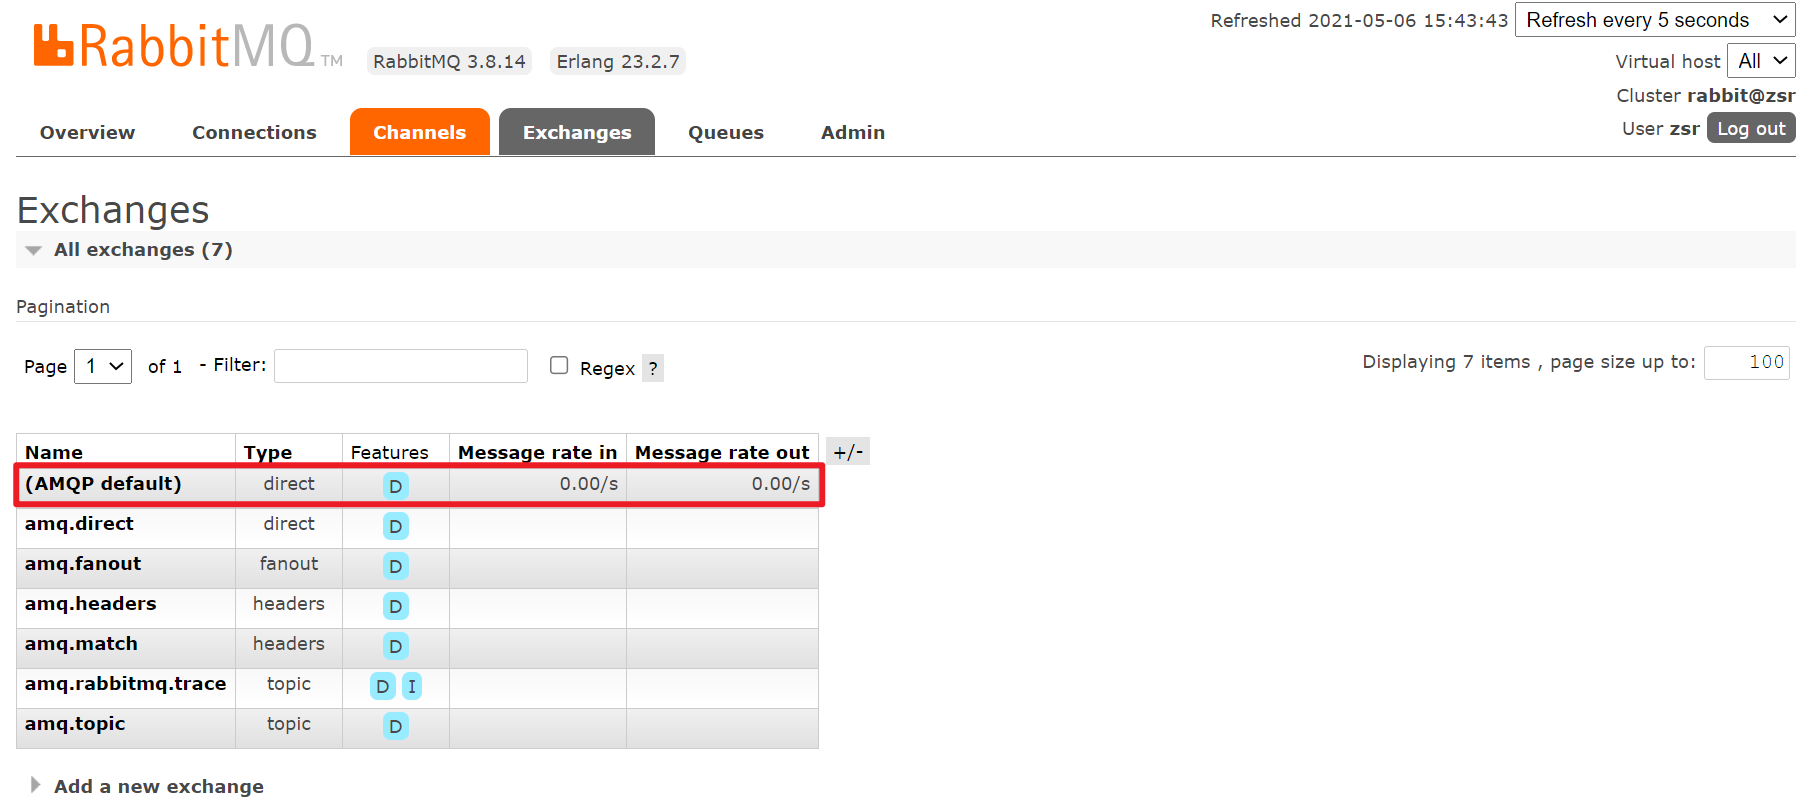
image-20210506154358468
简单模式
外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-9epHx9Dm-1677898686432)(D:\学习\笔记软件\Typora笔记软件\企业级开发\images\image-20230304094726351.png)
一个生产者,一个消费者,一个队列,采用默认交换机。可以理解为生产者P发送消息到队列Q,一个消费者C接收。
工作模式
外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-cKKCOfxm-1677898686433)(D:\学习\笔记软件\Typora笔记软件\企业级开发\images\image-20230304094804527.png)
一个生产者,多个消费者,一个队列,采用默认交换机。可以理解为生产者P发送消息到队列Q,可以由多个消费者C1、C2进行接收。
发布/订阅模式(fanout)
外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-0lg3aING-1677898686434)(D:\学习\笔记软件\Typora笔记软件\企业级开发\images\image-20230304094838873.png)
功能:一个生产者、一个 fanout 类型的交换机、多个队列、多个消费者。一个生产者发送的消息会被多个消费者获取。其中 fanout 类型就是发布订阅模式,只有订阅该生产者的消费者会收到消息。
接下来通过web界面的方式模拟发布订阅模式,首先新建一个fanout类型的交换机
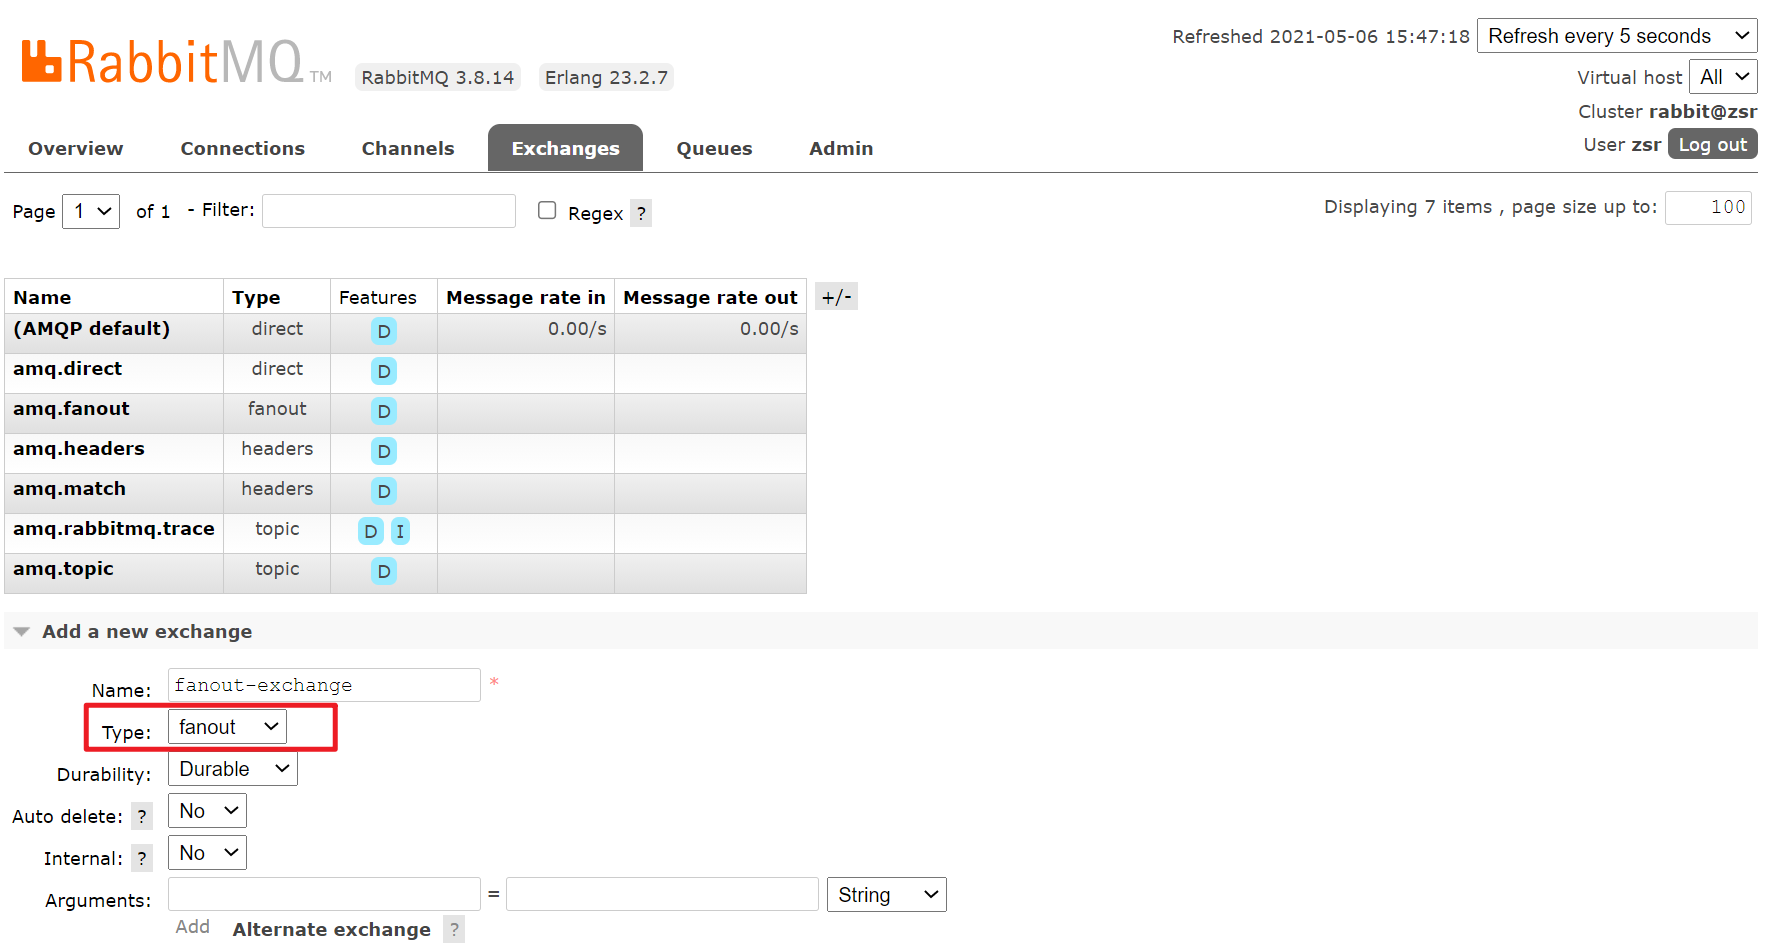
image-20210506154735938
image-20210506154735938
然后声明两个队列queue1、queue2
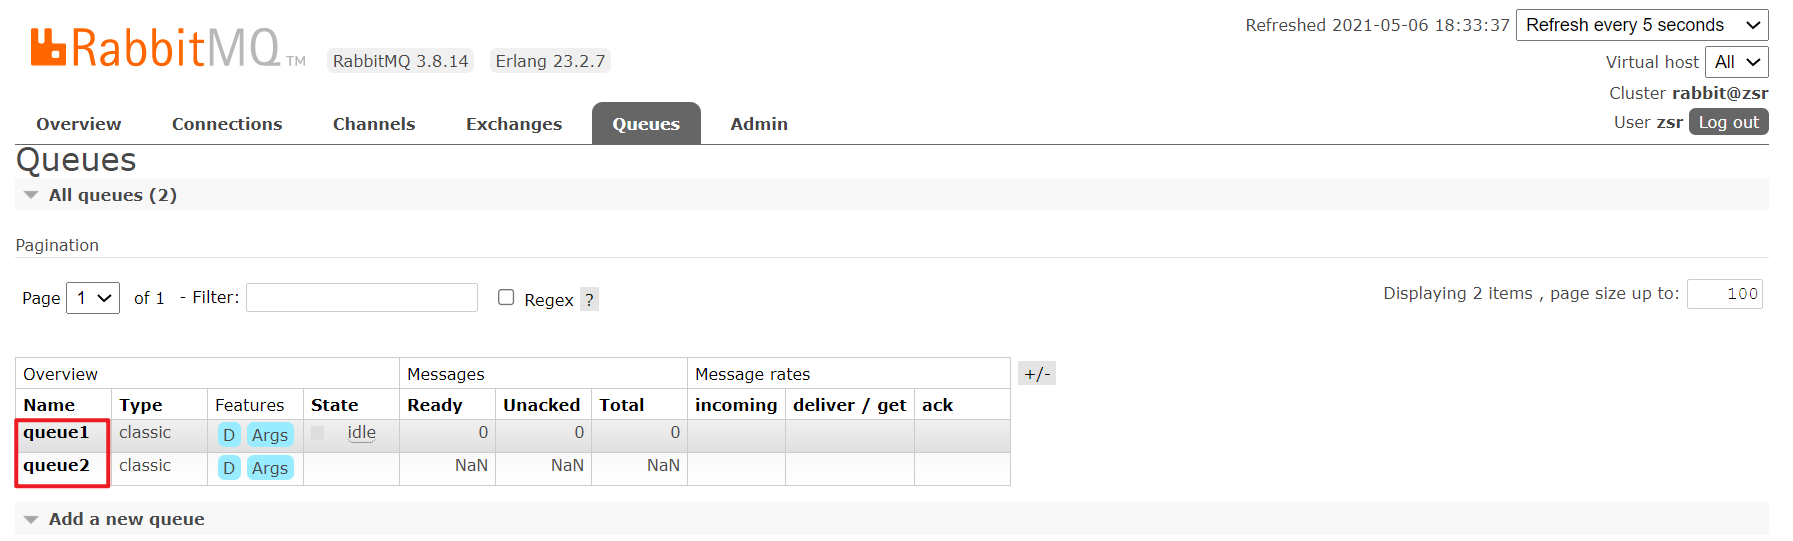
image-20210506183356243
然后将队列与交换机进行绑定
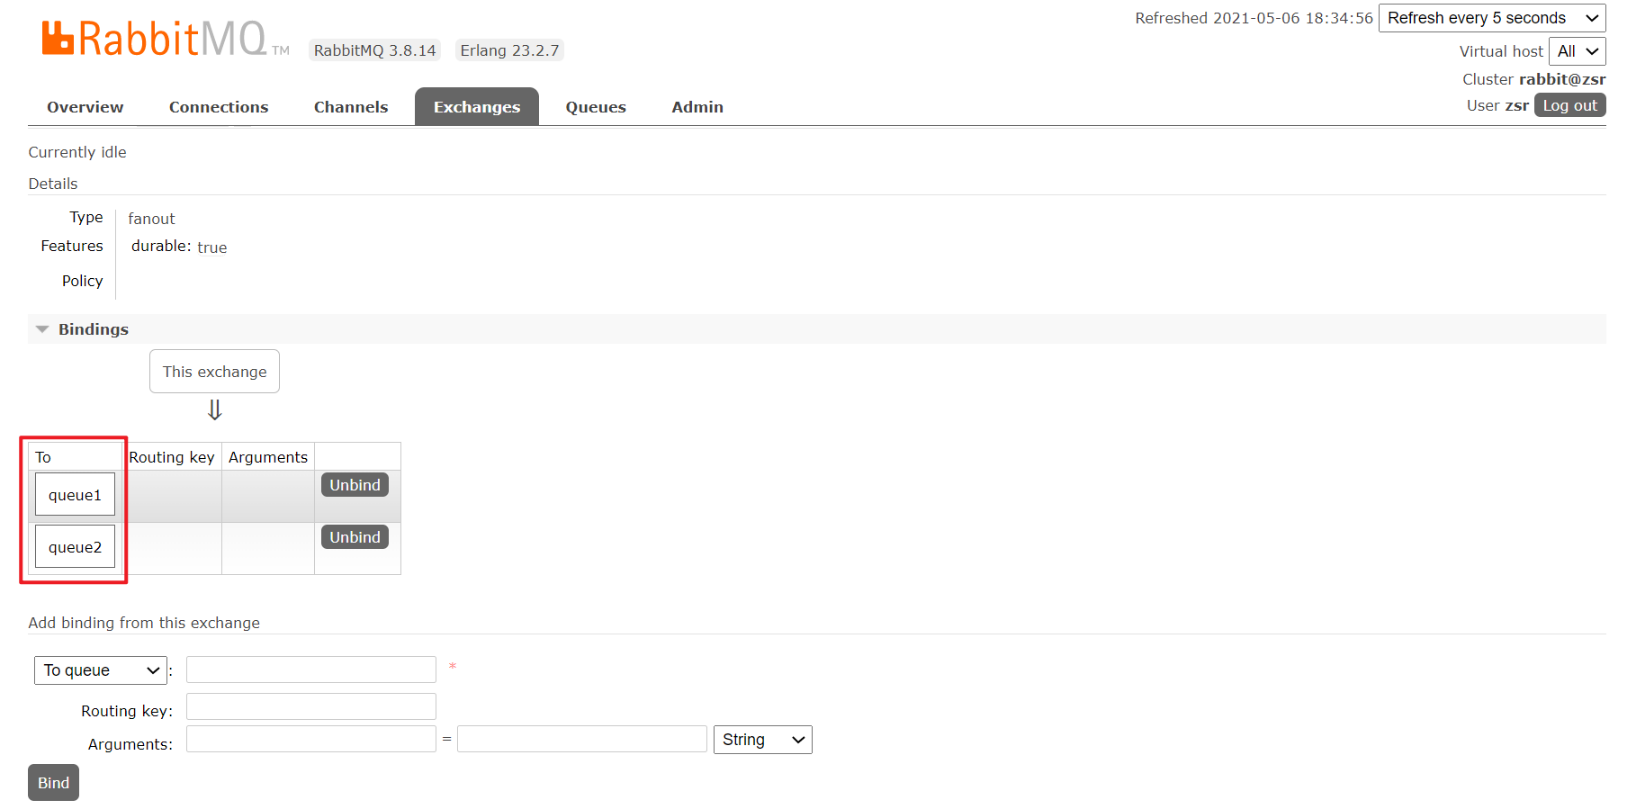
image-20210506183511301
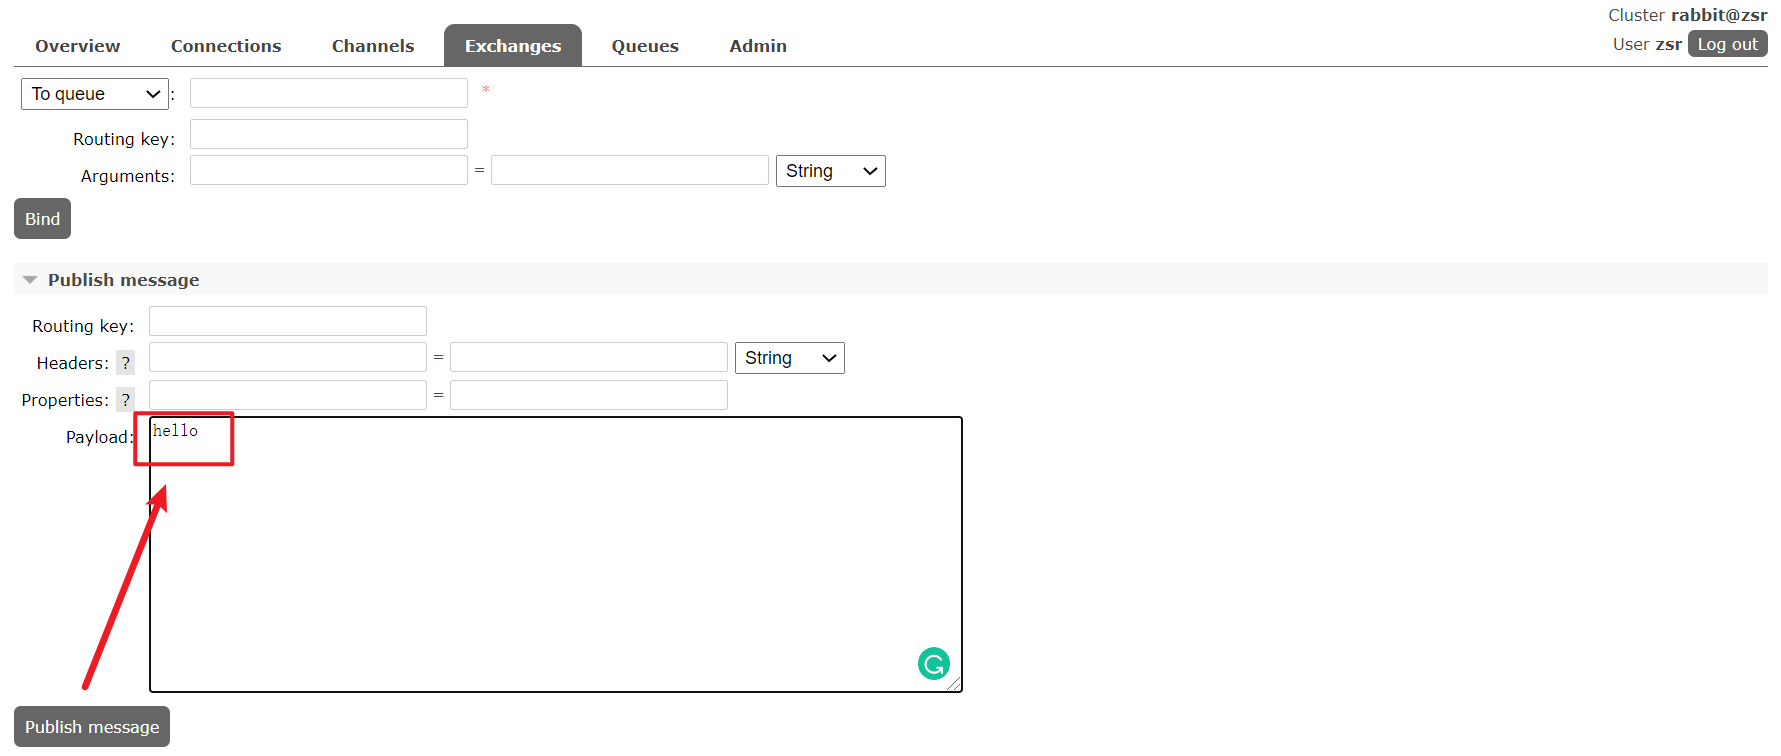
image-20210506183703971
然后在两个队列中都可以看到收到的消息
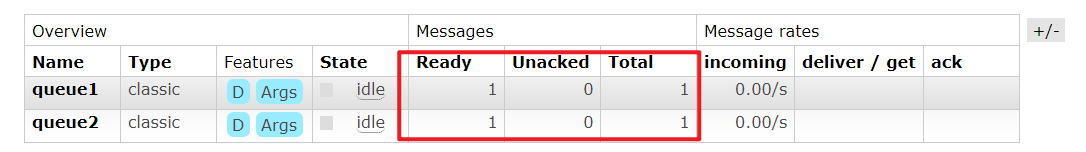
image-20210506183805667
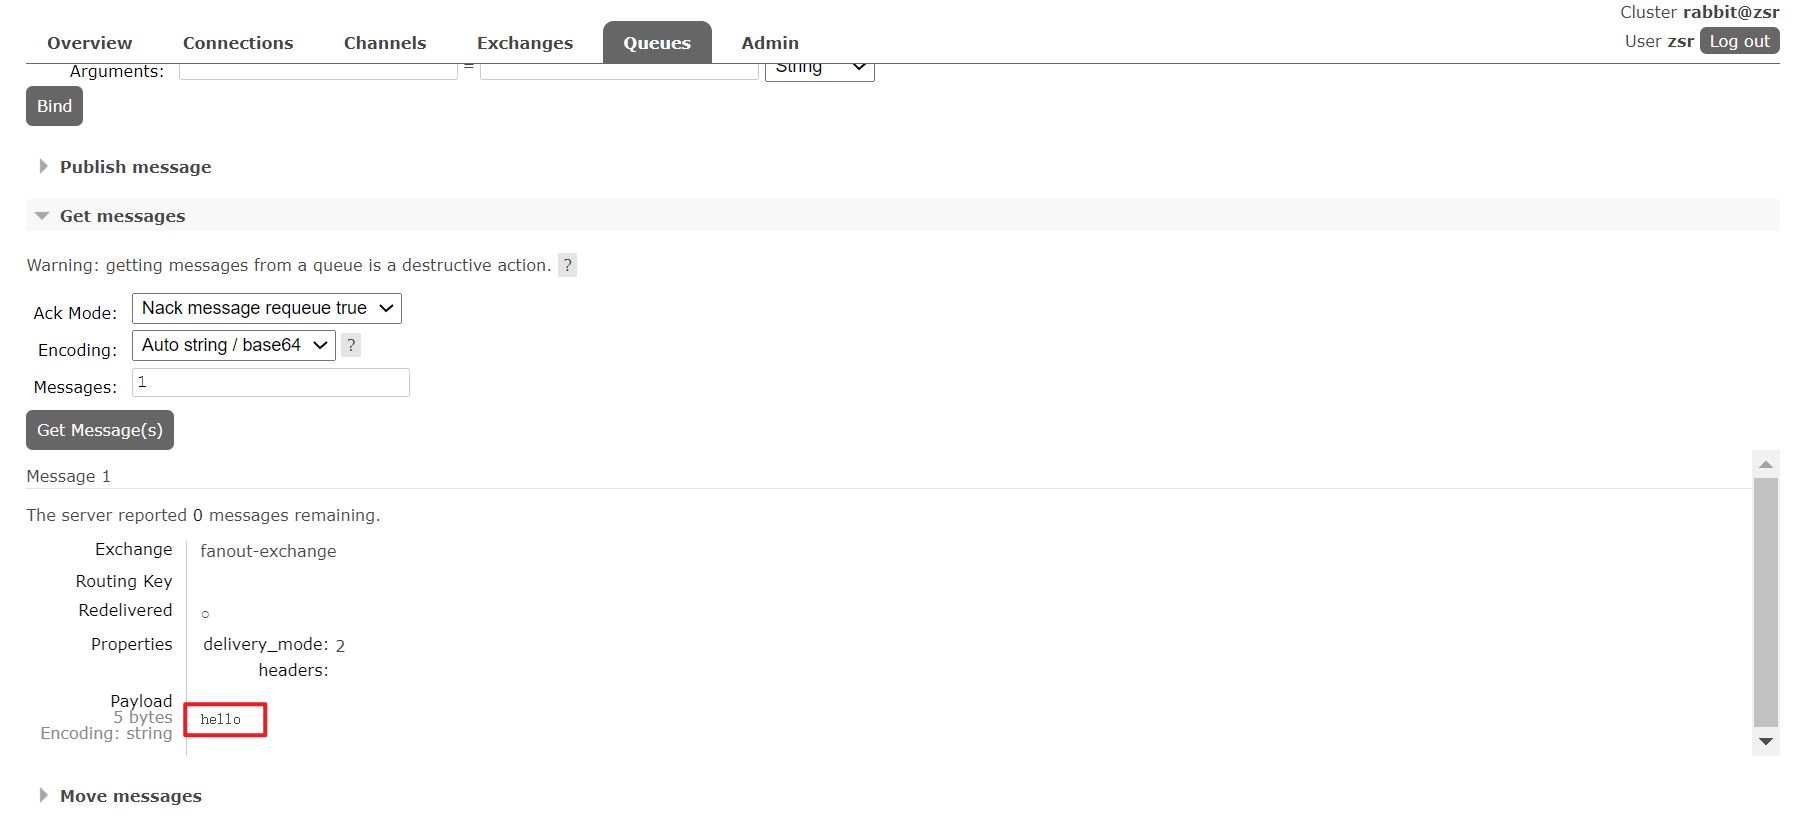
image-20210506183825678
路由模式(direct)
外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-t9d6xdis-1677898686435)(D:\学习\笔记软件\Typora笔记软件\企业级开发\images\image-20230304095040342.png)
功能:一个生产者,一个 direct 类型的交换机,多个队列,交换机与队列之间通过 routing-key 进行关联绑定,多个消费者。生产者发送消息到交换机并且要指定routing-key,然后消息根据这交换机与队列之间的 routing-key 绑定规则进行路由被指定消费者消费。
接下来通过web界面的方式模拟发布订阅模式,首先新建一个direct类型的交换机
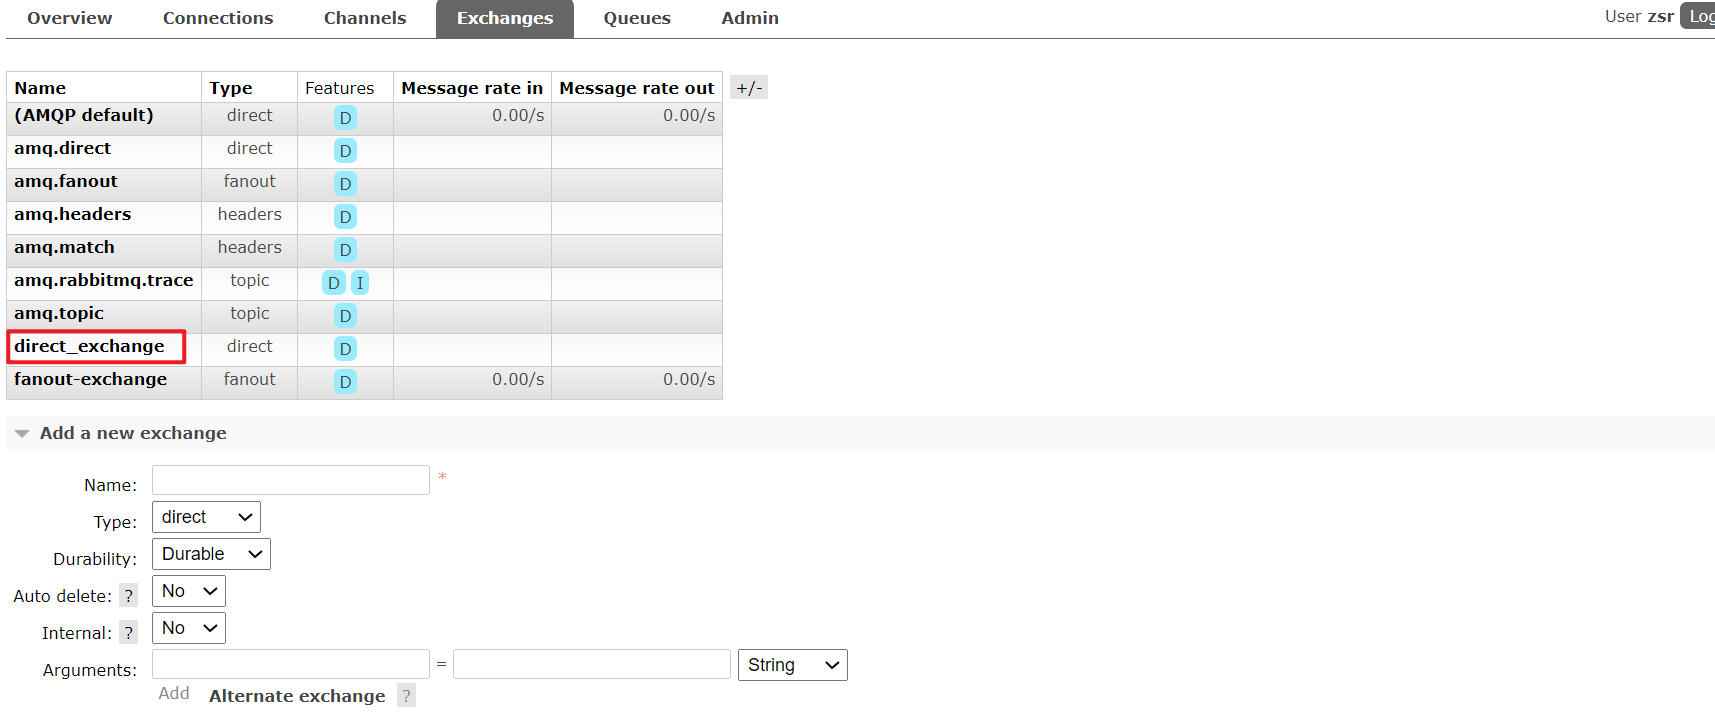
image-20210506184428360
image-20210506184428360
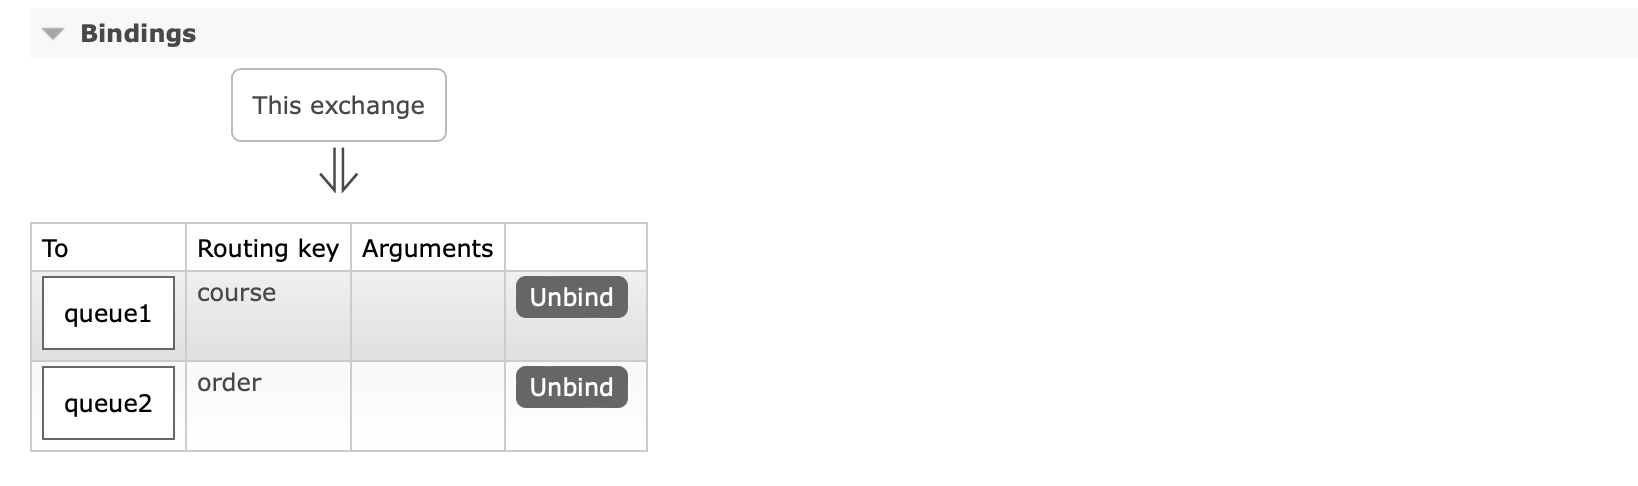
image-20211202213458983
然后我们往交换机中发送一条消息,指定一个 routing-key
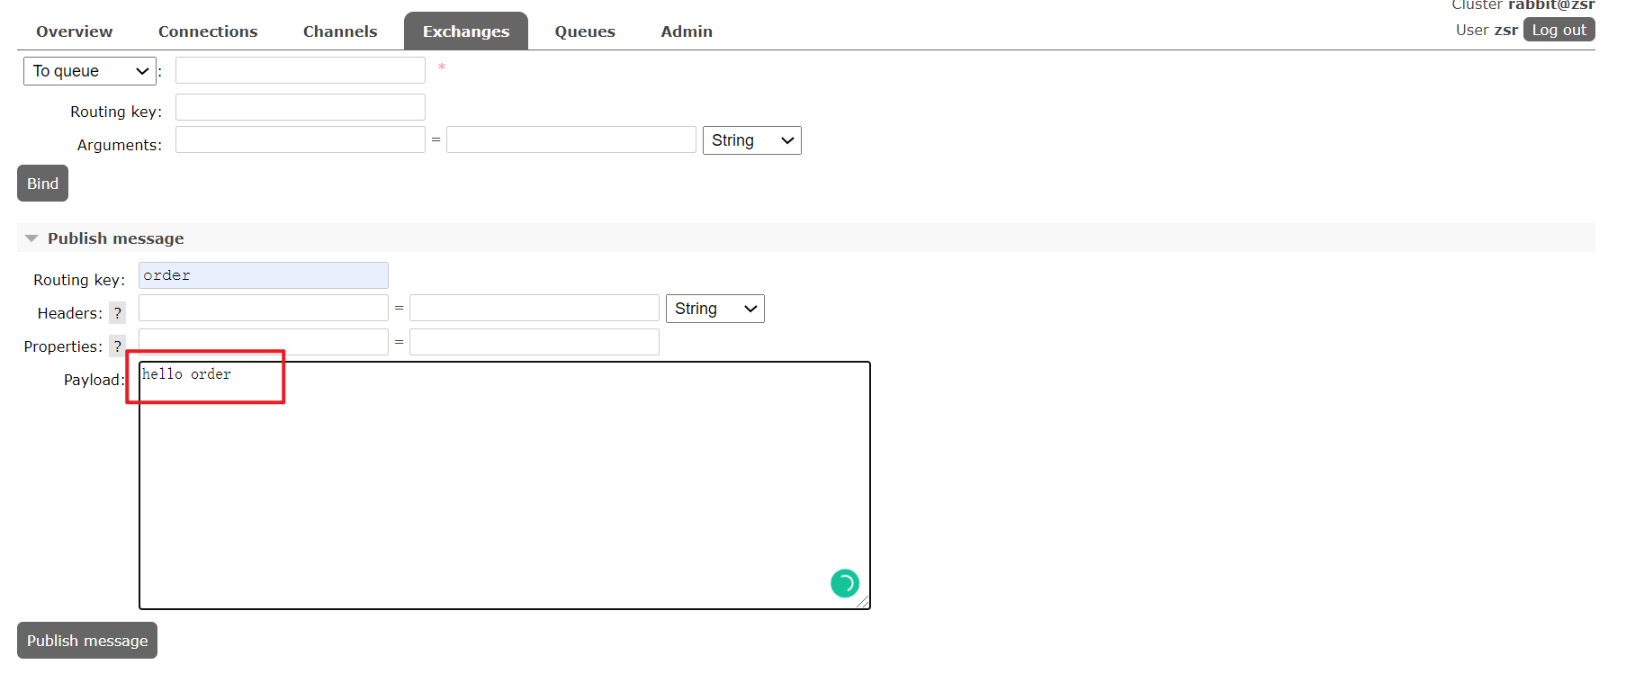
image-20210506184802728
可以看到只有对应 routing-key 的 queue2 收到了消息
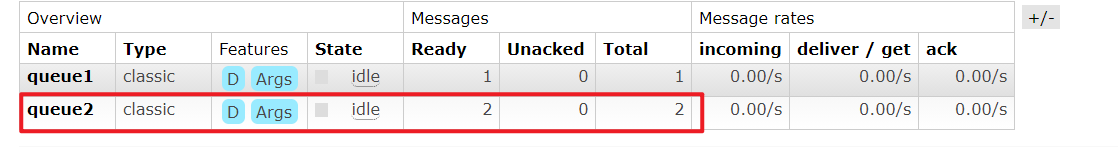
image-20210506184857519
主题模式(topic)
外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-xK79yqGA-1677898686435)(D:\学习\笔记软件\Typora笔记软件\企业级开发\images\image-20230304095241130.png)
说明:一个生产者,一个 topic 类型的交换机,多个队列,交换机与队列之间通过 routing-key 进行关联绑定,多个消费者。生产者发送消息到交换机并且要指定 routing-key,然后消息根据这交换机与队列之间的 routing-key 绑定规则进行路由被指定消费者消费。与路由模式不同是 routing-key 有指定的队则,可以更加的通用,满足更过的场景。routing-key 的规则如下:
#:匹配一个或者多个词,例如lazy.#可以匹配 lazy.xxx 或者 lazy.xxx.xxx*:只能匹配一个词,例如lazy.*只能匹配 lazy.xxx
接下来通过web界面的方式模拟发布订阅模式,首先新建一个topic类型的交换机
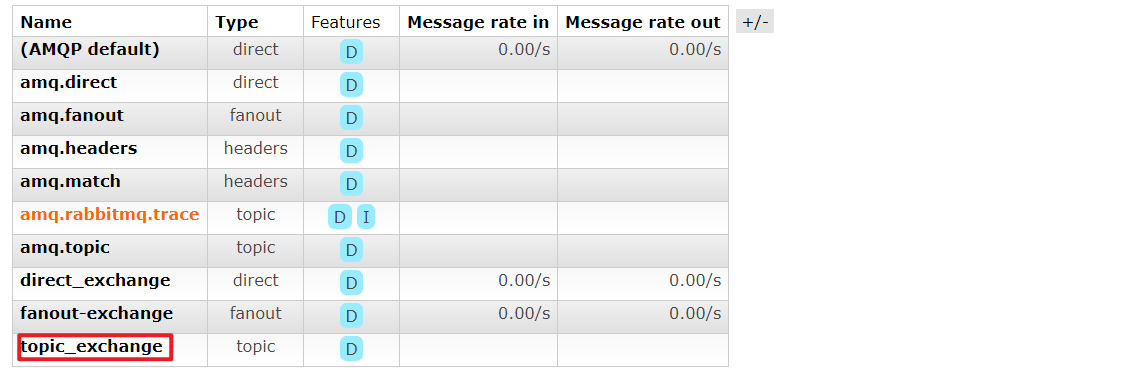
image-20210506185323289
然后绑定队列,设置路由key
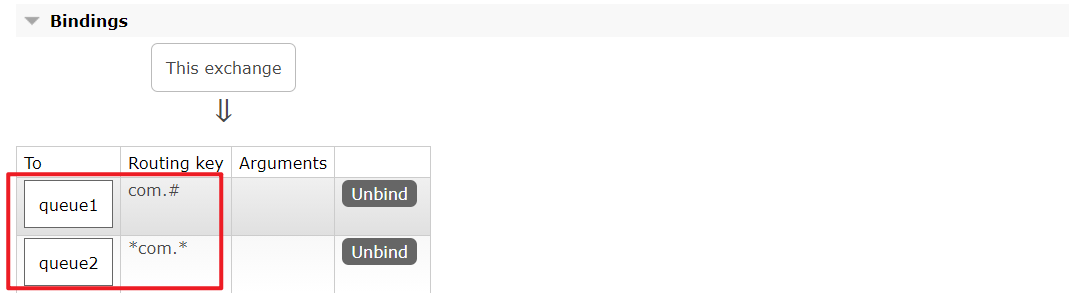
image-20210506185530995
然后我们向交换机中投递一条消息,指定一个路由key
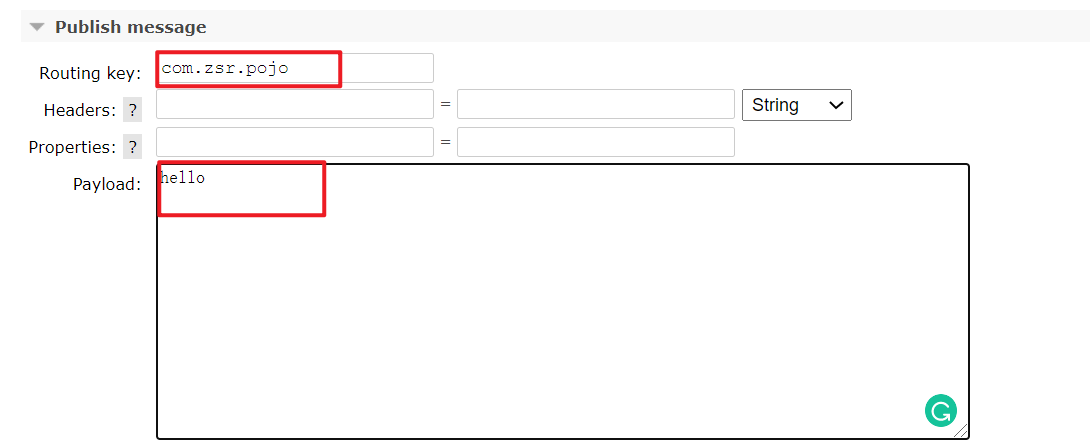
image-20210506185626745
可以看到只有满足路由key条件的queue1收到了消息
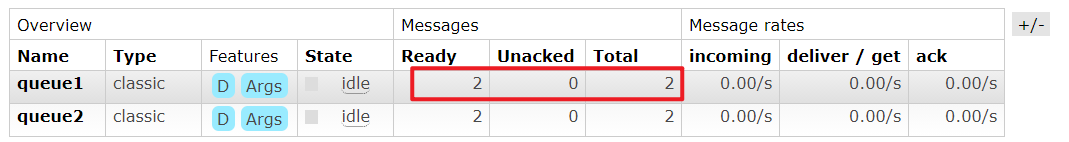
image-20210506185649213
参数模式
作用:可以携带参数,根据参数进行过滤
下来通过web界面的方式模拟发布订阅模式,首先新建一个headers类型的交换机
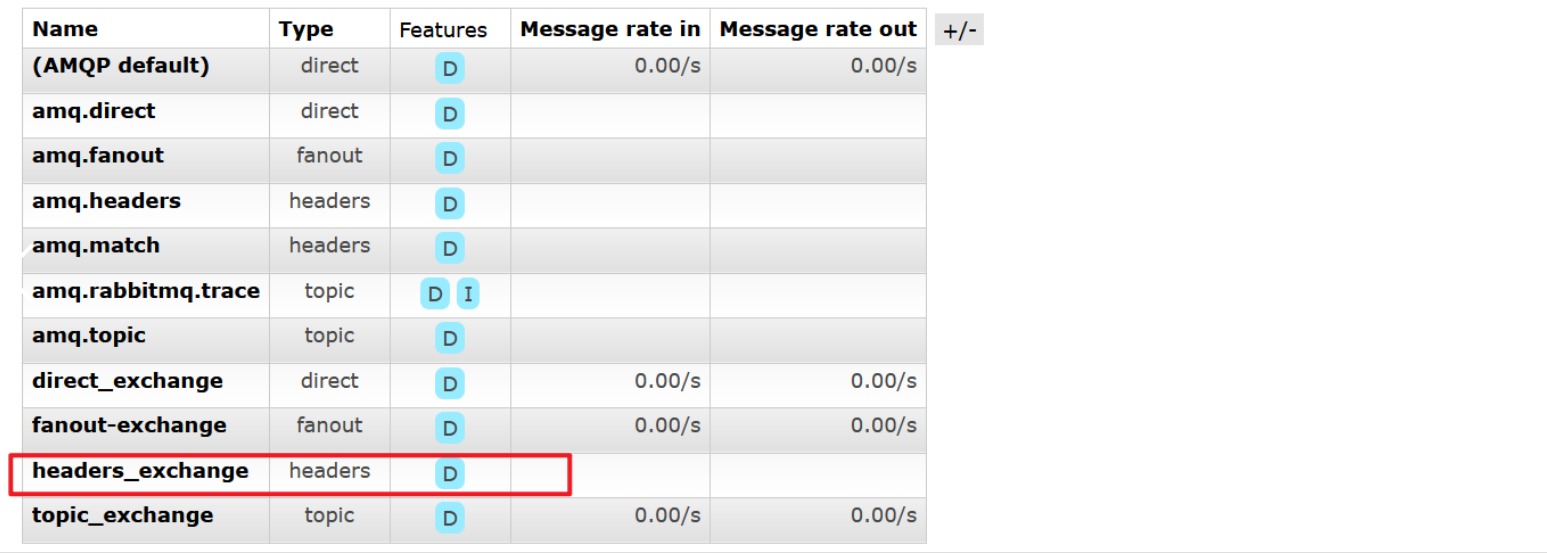
image-20210507211120145
然后绑定队列,设置相关参数

image-20210507211223522
然后我们向交换机中投递一条消息,指定参数
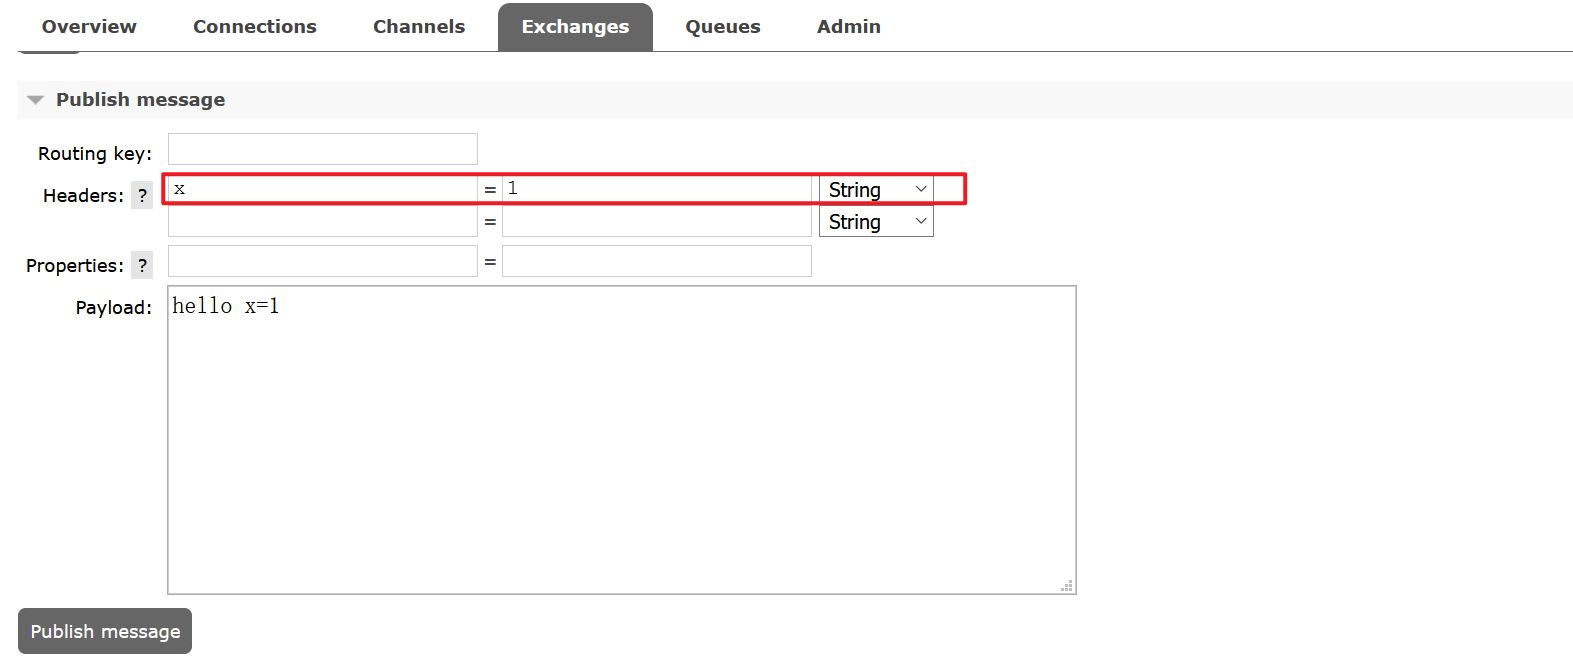
image-20210507211342271
可以看到只有满足参数x条件的queue1收到了消息
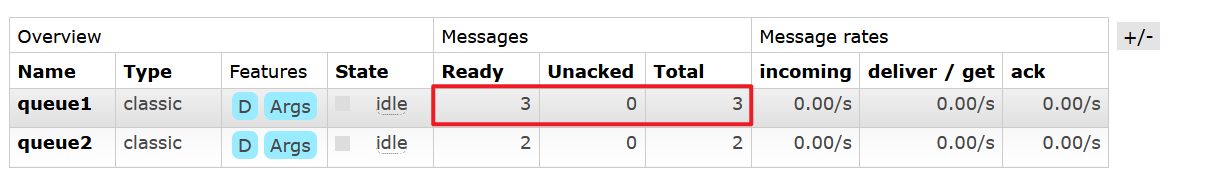
image-20210507211403675
四、简单模式——Hello Word
RabbitMQ 中最简单的
Hello World模式。也就是一个生产者、一个消费者、一个队列;生产者P发送消息到队列Q,一个消费者C接收消息。
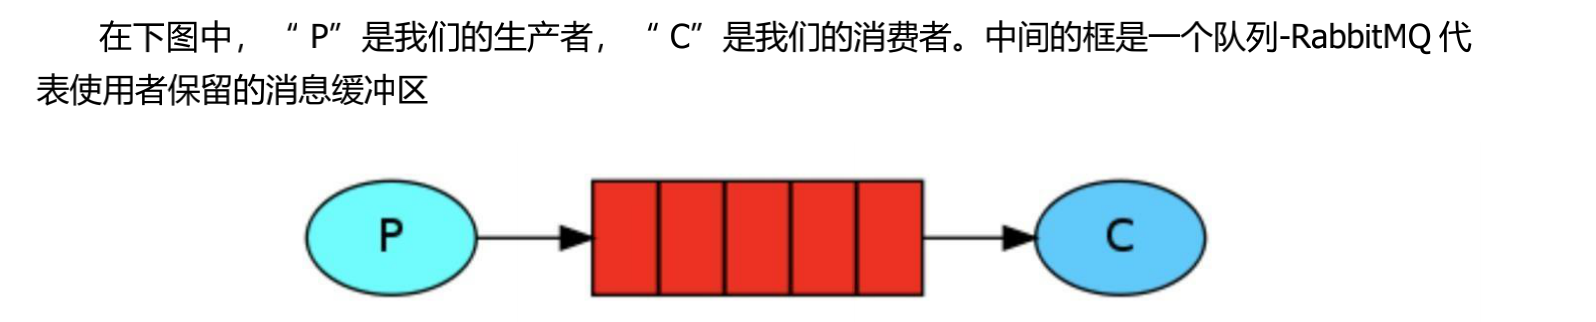
image-20211125221123994
接下来我们来用 Java 代码实现一下 Hello World简单模式,首先创建一个空项目,然后添加一个 maven 模块
4.1、导入rabbitmq依赖
首先我们导入 RabbitMQ 的依赖,并且指定 JDK 的编译版本。
<!--指定 jdk 编译版本-->
<build>
  <plugins>
    <plugin>
      <groupId>org.apache.maven.plugins</groupId>
      <artifactId>maven-compiler-plugin</artifactId>
      <configuration>
        <source>8</source>
        <target>8</target>
      </configuration>
    </plugin>
  </plugins>
</build>
<dependencies>
  <!--rabbitmq 依赖客户端-->
  <dependency>
    <groupId>com.rabbitmq</groupId>
    <artifactId>amqp-client</artifactId>
    <version>5.8.0</version>
  </dependency>
  <!--操作文件流的一个依赖-->
  <dependency>
    <groupId>commons-io</groupId>
    <artifactId>commons-io</artifactId>
    <version>2.6</version>
  </dependency>
</dependencies>
4.2、编写消息生产者
步骤:
- 创建连接工厂 ConnectionFactory
- 通过连接工厂创建连接 Connection
- 通过连接获取通道 Channel
- 通过通道声明队列 Queue
- 发送消息到队列 Queue 中
package mode1_Simple;

import com.rabbitmq.client.Channel;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;

public class Producer {
  	// 队列名称
    public static String QUEUE_NAME = "hello";

    public static void main(String[] args) throws Exception {
        // 创建一个连接工厂
        ConnectionFactory factory = new ConnectionFactory();
        factory.setHost("82.156.9.173");
        factory.setUsername("zsr");
        factory.setPassword("123456");
        // 创建一个connection
        Connection connection = factory.newConnection();
        // 创建一个channel
        Channel channel = connection.createChannel();
        /**
         * 创建一个队列
         * 1.队列名称
         * 2.队列里面的消息是否持久化(默认为false,代表消息存储在内存中)
         * 3.该队列是否只供一个消费者进行消费,是否进行共享(true表示可以多个消费者消费)
         * 4.表示最后一个消费者断开连接以后,该队列是否自动删除(true表示自动删除)
         * 5.其他参数
         */
        channel.queueDeclare(QUEUE_NAME, false, false, false, null);
        /**
         * 发送一个消息
         * 1.发送到那个交换机(空代表默认交换机)
         * 2.路由key
         * 3.其他的参数信息
         * 4.发送消息的消息体
         */
        String message = "hello";
        channel.basicPublish("", QUEUE_NAME, null, message.getBytes());
        System.out.println("消息发送完毕");
    }
}
4.3、编写消息消费者
步骤:
- 创建连接工厂 ConnectionFactory
- 通过连接工厂创建连接 Connection
- 通过连接获取通道 Channel
- 通过通道接收消息
package mode1_Simple;

import com.rabbitmq.client.*;

public class Consumer {
  	// 队列名称
    public static String QUEUE_NAME = "hello";

    public static void main(String[] args) throws Exception {
        // 创建一个连接工厂
        ConnectionFactory factory = new ConnectionFactory();
        factory.setHost("82.156.9.173");
        factory.setUsername("zsr");
        factory.setPassword("123456");
        // 创建一个connection
        Connection connection = factory.newConnection();
        // 创建一个channel
        Channel channel = connection.createChannel();
        /**
         * 消费者消费消息
         * 1.消费的队列名称
         * 2.消费成功之后是否要自动应答(true代表自动应答,false代表手动应答)
         * 3.消费者消费消息的回调(函数式接口)
         * 4.消费者取消消费的回调(函数式接口)
         */
        // 消费消息的回调
        DeliverCallback deliverCallback = (consumerTag, message) -> {
            System.out.println("成功消费消息,内容为:" + new String(message.getBody()));
        };
        // 取消消费的回调
        CancelCallback cancelCallback = (consumerTag) -> {
            System.out.println("消息消费被中断");
        };
        channel.basicConsume(QUEUE_NAME, true, deliverCallback, cancelCallback);
    }
}
4.4、测试
运行程序,观察消息在rabbitmq-server服务中的过程
首先启动生产者,可以看到创建了一个队列hello,并发送了一条消息,还未被消费
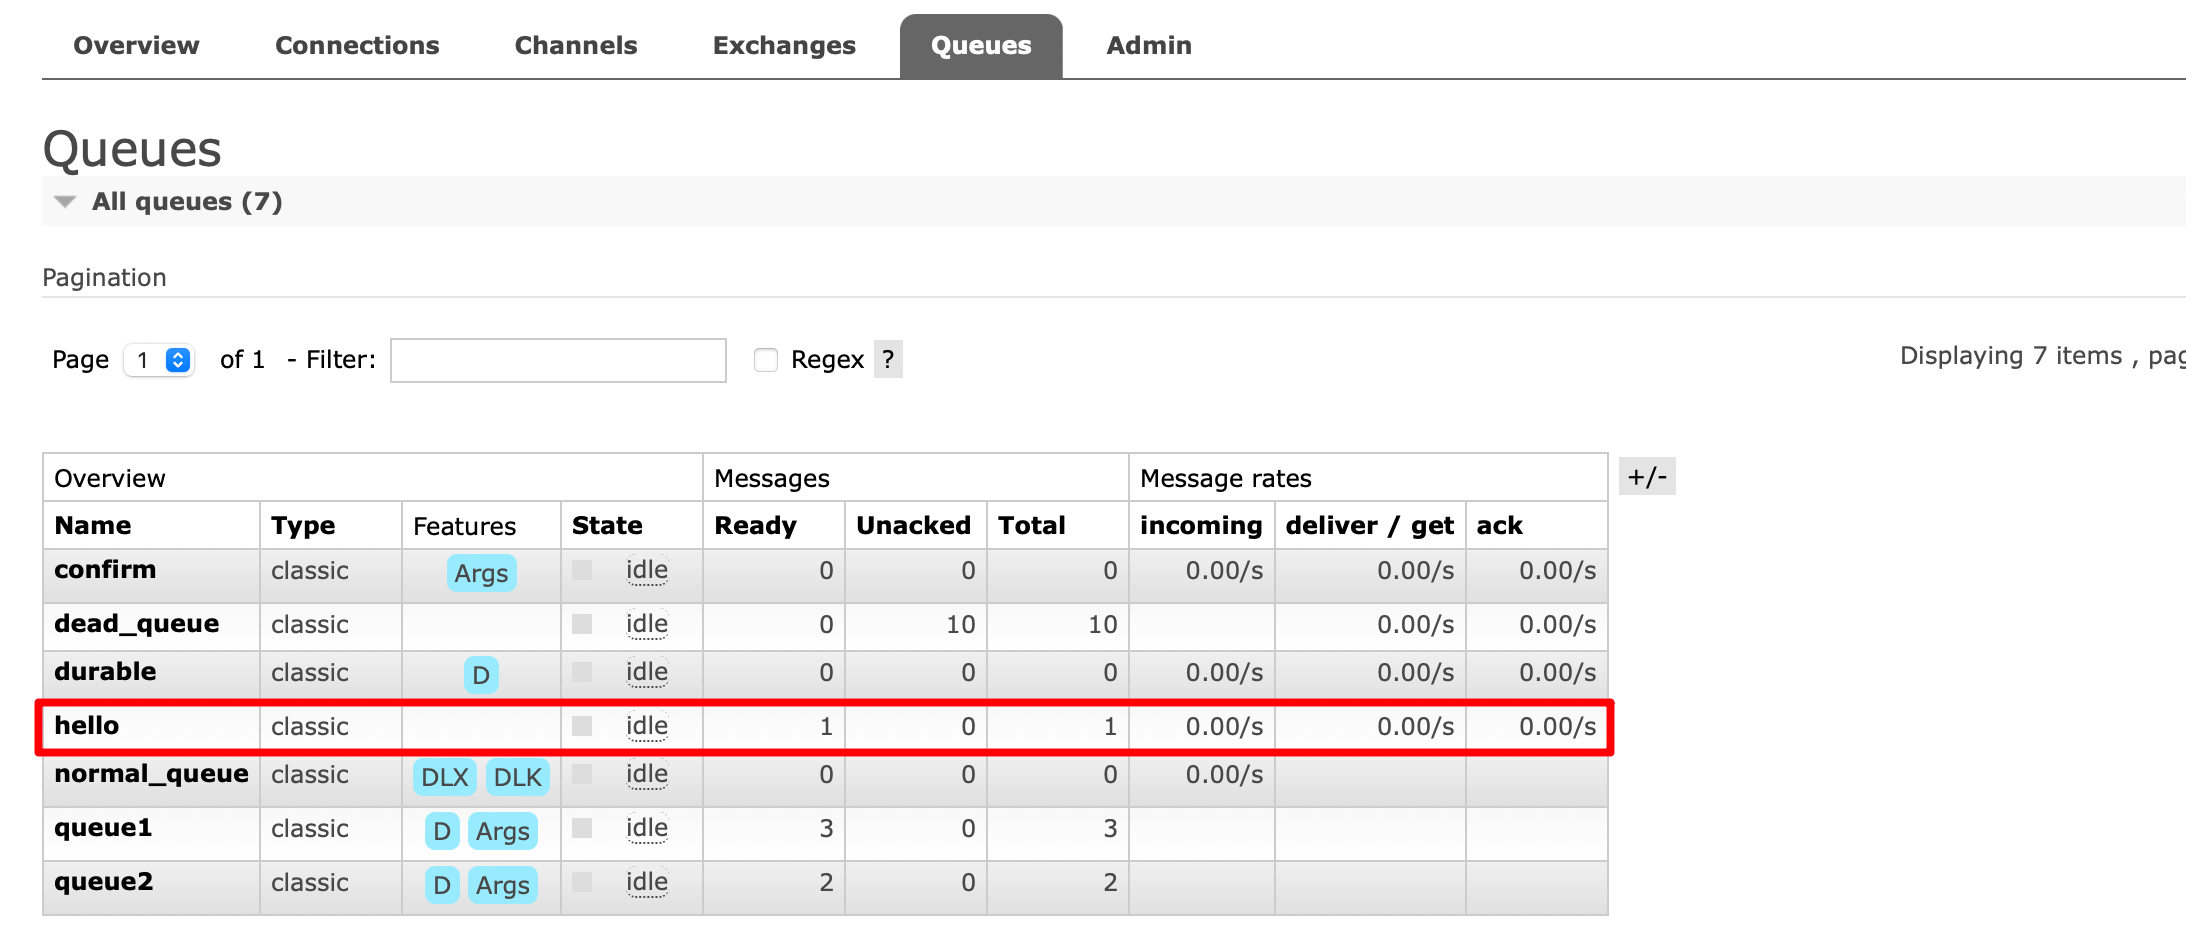
image-20211125222902844
然后再启动消费者,可以看到控制台打印收到的消息,同时可以看到消息已经被消费
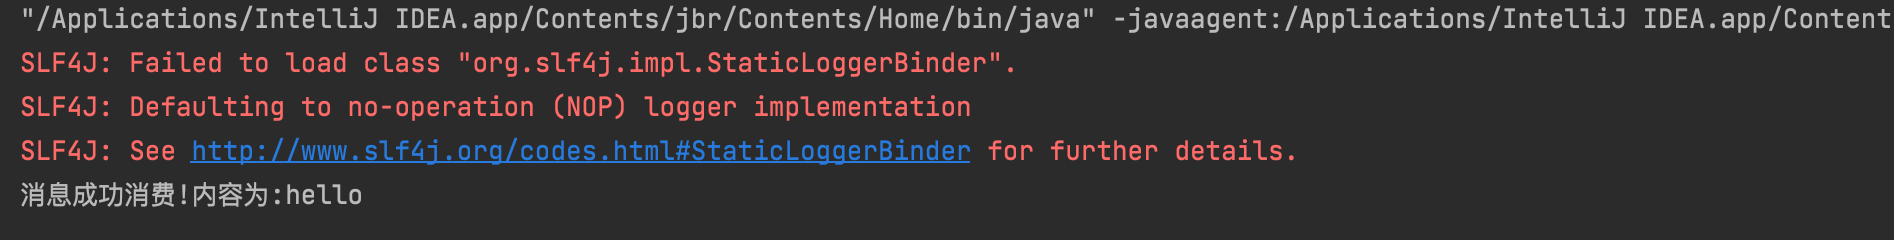
image-20211125222934140
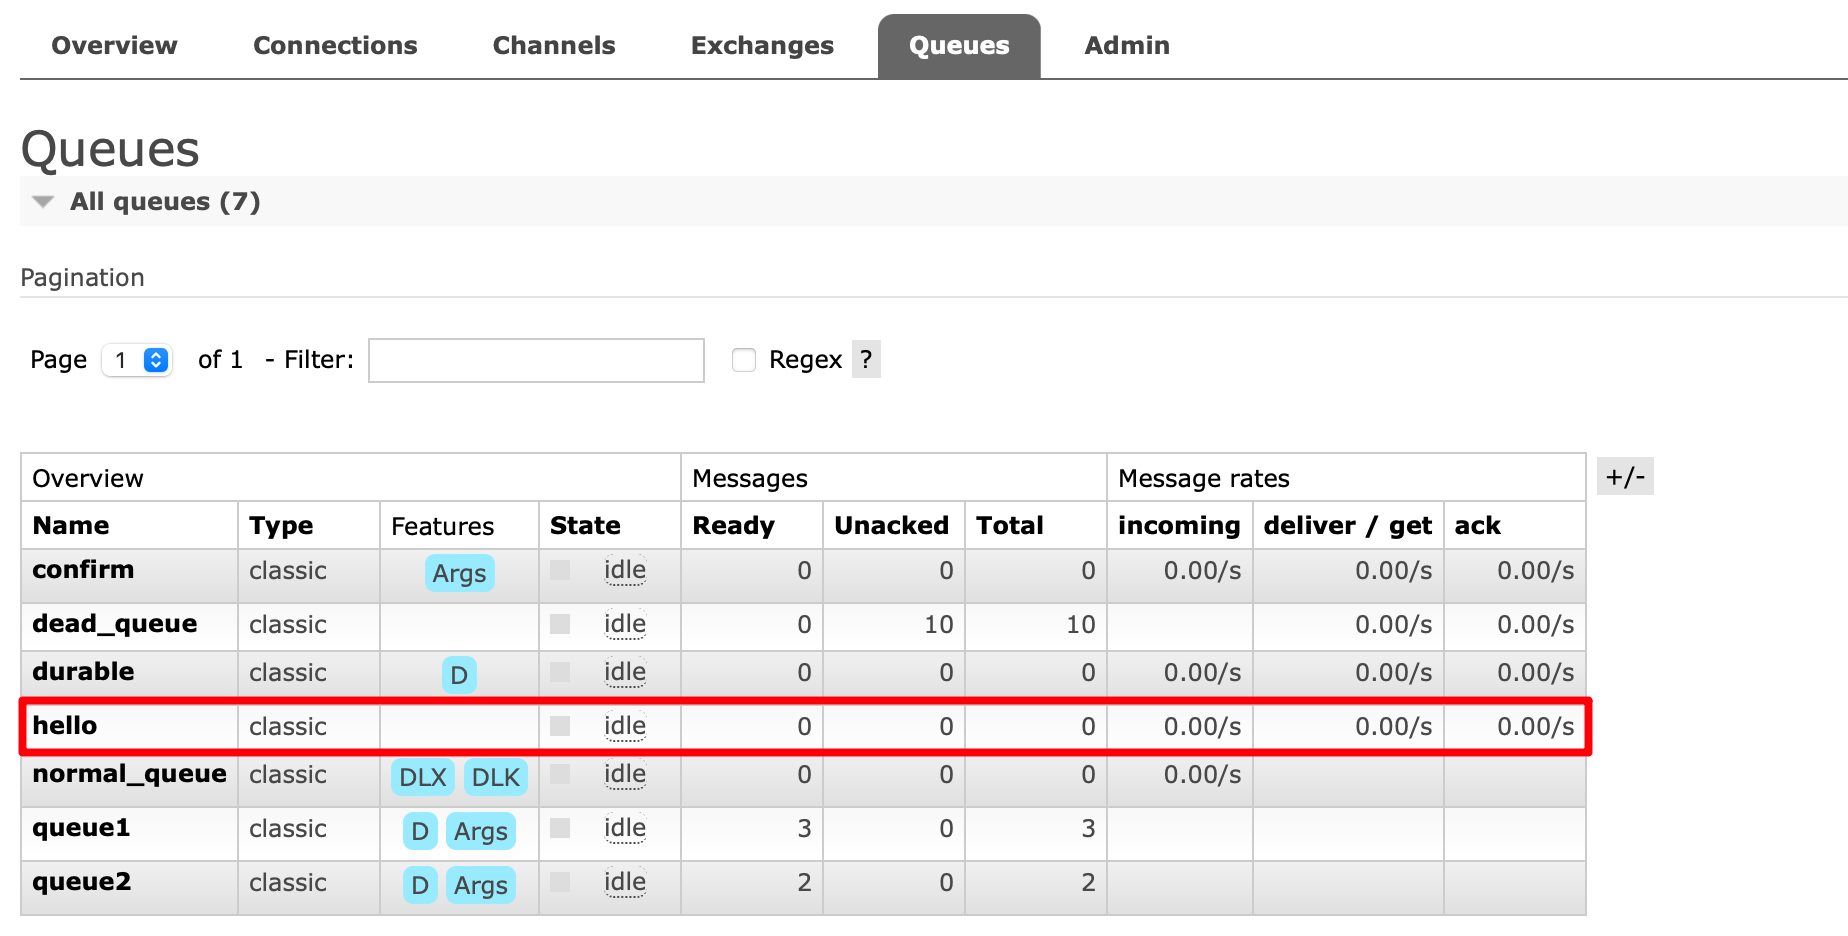
image-20211125223008723
此外,这里的hello队列是一个非持久化队列,所以如果rabbitmq服务重启,该队列会消失
4.5、代码优化—抽取工具类
上述消息生产者和消费者获取创建ConnectionFactory,获取Connection和Channel的过程是一样的,我们可以封装成一个工具类RabbitMqUtils。
package utils;

import com.rabbitmq.client.Channel;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;

public class RabbitMqUtils {
    // 获得RabbitMQ连接的channel
    public static Channel getChannel() throws Exception {
        // 创建一个连接工厂
        ConnectionFactory factory = new ConnectionFactory();
        factory.setHost("82.156.9.173");
        factory.setUsername("zsr");
        factory.setPassword("123456");
        // 创建一个connection
        Connection connection = factory.newConnection();
        // 创建一个channel
        Channel channel = connection.createChannel();
        return channel;
    }
}
然后我们就可以优化一下消费者和生产者的代码:
消费者:
package mode1_Simple;

import com.rabbitmq.client.*;

public class Consumer {
    public static String QUEUE_NAME = "hello";

    public static void main(String[] args) throws Exception {
        Channel channel = utils.RabbitMqUtils.getChannel();
        /**
         * 消费者消费消息
         * 1.消费的队列名称
         * 2.消费成功之后是否要自动应答(true代表自动应答,false代表手动应答)
         * 3.消费者消费消息的回调(函数式接口)
         * 4.消费者取消消费的回调(函数式接口)
         */
        // 消费消息的回调
        DeliverCallback deliverCallback = (consumerTag, message) -> {
            System.out.println("消息成功消费!内容为:" + new String(message.getBody()));
        };
        // 取消消费的回调
        CancelCallback cancelCallback = (consumerTag) -> {
            System.out.println("消息消费被中断");
        };
        channel.basicConsume(QUEUE_NAME, true, deliverCallback, cancelCallback);
    }
}生产者:
package mode1_Simple;

import com.rabbitmq.client.Channel;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;

public class Producer {
    public static String QUEUE_NAME = "hello";

    public static void main(String[] args) throws Exception {
        Channel channel = utils.RabbitMqUtils.getChannel();
        /**
         * 创建一个队列
         * 1.队列名称
         * 2.队列里面的消息是否持久化(默认为false,代表消息存储在内存中)
         * 3.该队列是否只供一个消费者进行消费,是否进行共享(true表示可以多个消费者消费)
         * 4.表示最后一个消费者断开连接以后,该队列是否自动删除(true表示自动删除)
         * 5.其他参数
         */
        channel.queueDeclare(QUEUE_NAME, false, false, false, null);
        /**
         * 发送一个消息
         * 1.发送到那个交换机(空代表默认交换机)
         * 2.路由key
         * 3.其他的参数信息
         * 4.发送消息的消息体
         */
        String message = "hello";
        channel.basicPublish("", QUEUE_NAME, null, message.getBytes());
        System.out.println("消息发送完毕");
    }
}
五、工作模式——Work Queues
Work Queues 是工作队列模式,也就是一个生产者、多个消费者、一个队列。
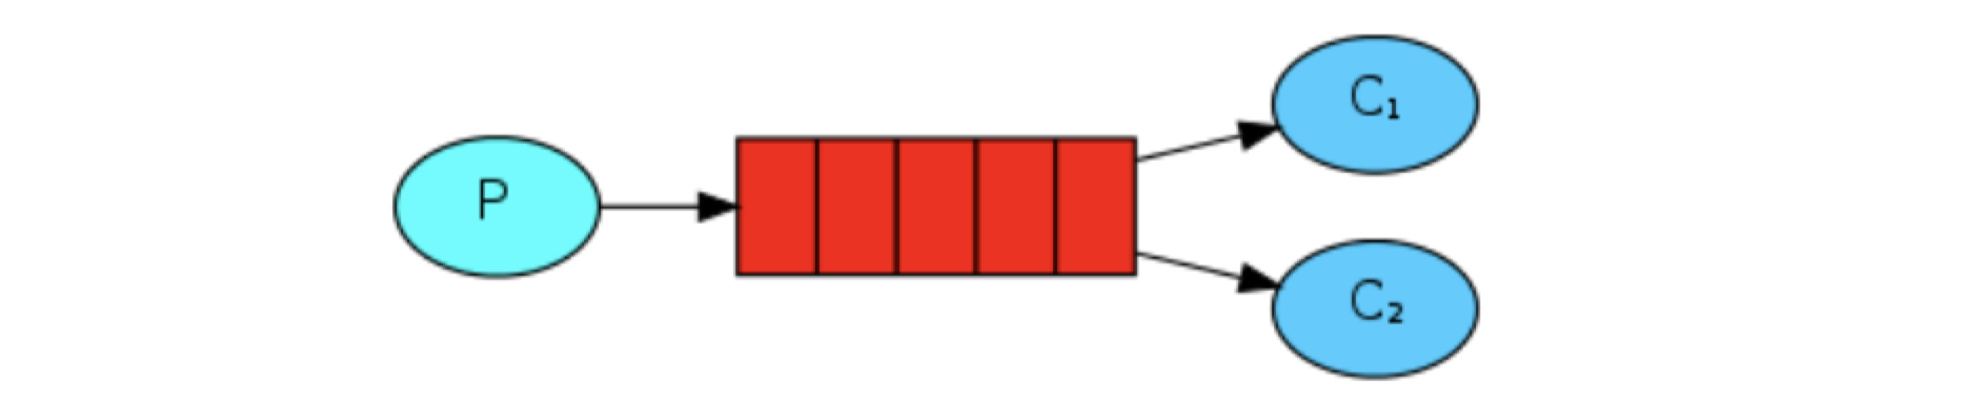
image-20211125223948667
它的主要思想是避免排队等待,避免一个消息处理时间过久而无法处理下一个的问题。因此相比简单模式可以有多个消费者,原理就是我们把任务封装为消息并将其发送到队列中,这多个消费者可以一起处理队列中的任务。
RabbitMQ 中的工作模式默认采用轮训的方式,也就是如果有两个消费者的话,消息逐一分给每个消费者进行消费。接下来我们来用 Java 代码实现一下 Work Queues工作模式,来测试其轮训消费的功能。
5.1、编写消息生产者
package mode2_WorkQueues.polling;

import com.rabbitmq.client.Channel;

import java.util.Scanner;

public class Producer {
    public static String QUEUE_NAME = "work";

    public static void main(String[] args) throws Exception {
        // 创建channel
        Channel channel = utils.RabbitMqUtils.getChannel();
        // 声明队列
        channel.queueDeclare(QUEUE_NAME, false, false, false, null);
        // 发送消息
        Scanner scanner = new Scanner(System.in);
        while (scanner.hasNext()) {
            String message = scanner.next();
            channel.basicPublish("", QUEUE_NAME, null, message.getBytes());
            System.out.println("消息发送完毕" + message);
        }
    }
}
5.2、编写消息消费者
消费者1:
package mode2_WorkQueues.polling;

import com.rabbitmq.client.CancelCallback;
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.DeliverCallback;

// 消费者1
public class Consumer01 {
    public static String QUEUE_NAME = "work";

    public static void main(String[] args) throws Exception {
        // 创建channel
        Channel channel = utils.RabbitMqUtils.getChannel();
        // 消费消息
        DeliverCallback deliverCallback = (consumerTag, message) -> {
            System.out.println("消息成功消费!内容为:" + new String(message.getBody()));
        };
        CancelCallback cancelCallback = (consumerTag) -> {
            System.out.println("消息消费被中断");
        };
        channel.basicConsume(QUEUE_NAME, true, deliverCallback, cancelCallback);
    }
}
消费者2:
package mode2_WorkQueues.polling;

import com.rabbitmq.client.CancelCallback;
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.DeliverCallback;

// 消费者2
public class Consumer02 {
    public static String QUEUE_NAME = "work";

    public static void main(String[] args) throws Exception {
        // 创建channel
        Channel channel = utils.RabbitMqUtils.getChannel();
        // 消费消息
        DeliverCallback deliverCallback = (consumerTag, message) -> {
            System.out.println("消息成功消费!内容为:" + new String(message.getBody()));
        };
        CancelCallback cancelCallback = (consumerTag) -> {
            System.out.println("消息消费被中断");
        };
        channel.basicConsume(QUEUE_NAME, true, deliverCallback, cancelCallback);
    }
}
5.3、测试
首先分别启动两个消费者,然后启动生产者,这里发送4条消息:
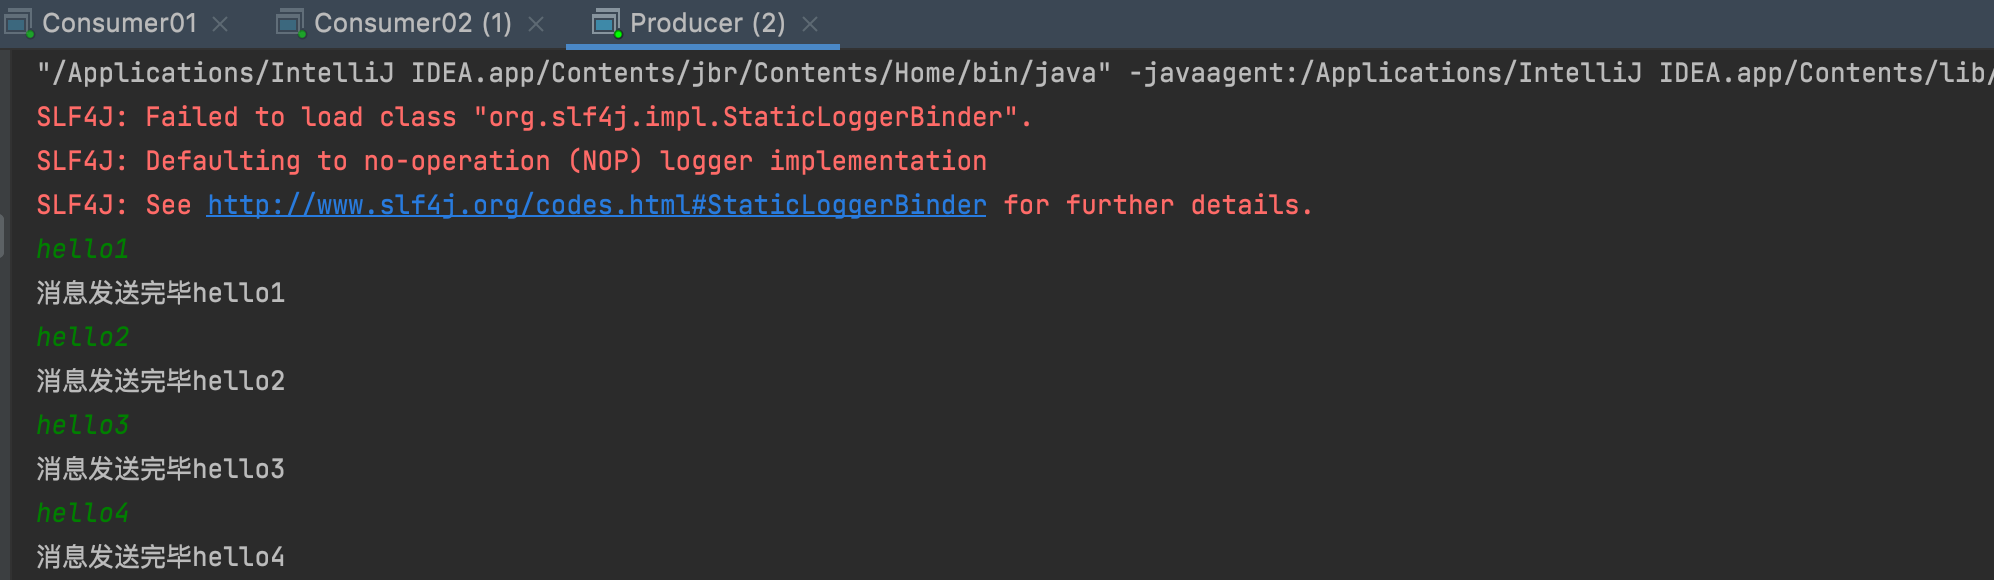
image-20211125224826318
根据结果可以看到,consumer01收到了1和3条消息,consumer01收到了2和4条消息:
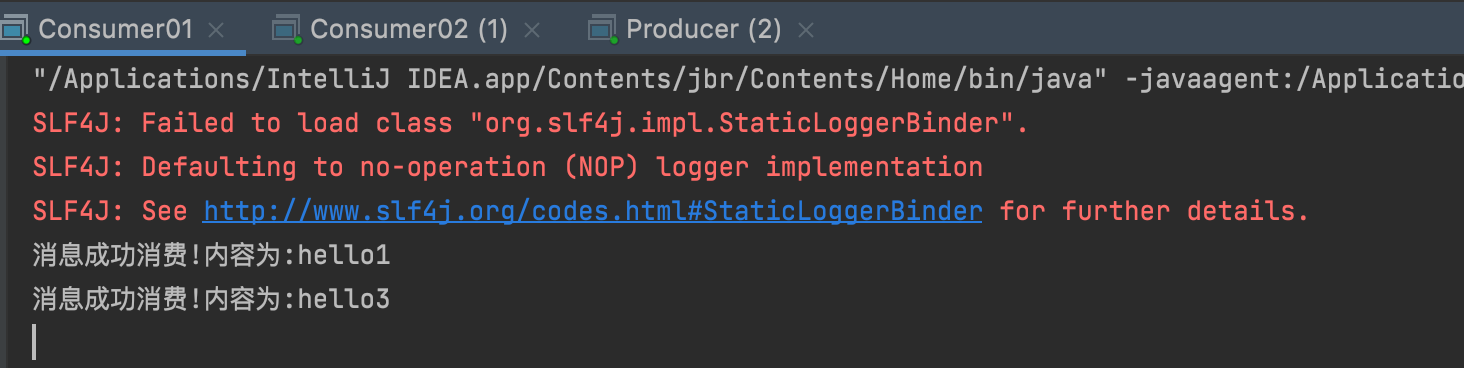
image-20211125224923270
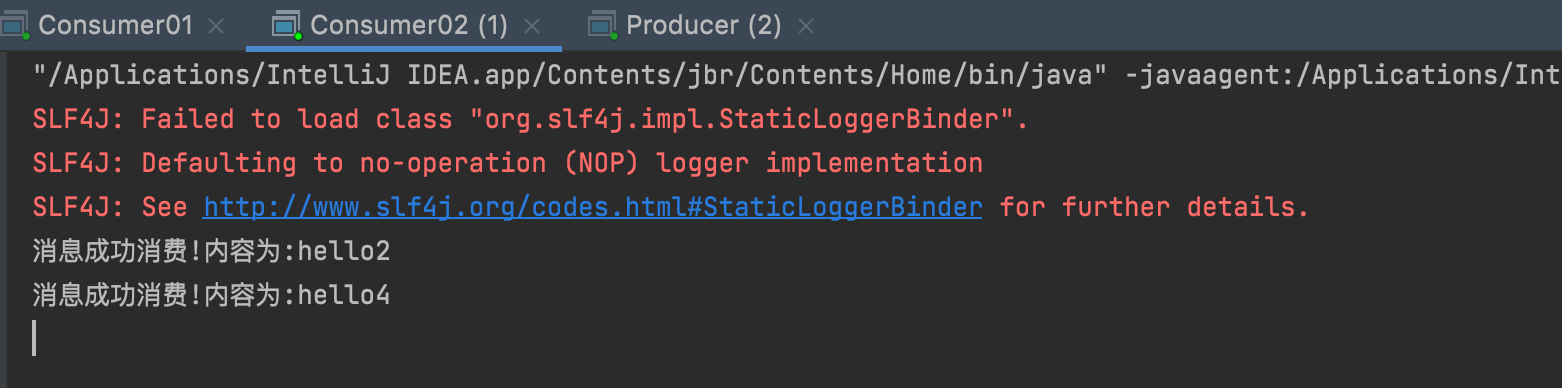
image-20211125224932855
也就是多个消费者是轮询消费生产者发送的消息。
六、RabbitMQ交换机
前面的两节中,我们通过演示了 Hello World、Work Queues 两种 RabbitMQ 的工作模式。接下来我们来看看剩下的三种模式:Publish/Subscribe、Routing、Topics,这三种模式可以统一归为 Exchange 模式,它们只是创建时交换机的类型不一样,分别是 fanout、direct、topic。 这节我们就来深入了解一下交换机 Exchange 以及它的几种工作模式。
6.1、Exchanges简介
RabbitMQ 消息传递模型的核心思想是:生产者生产的消息从不会直接发送到队列。实际上,通常生产者甚至都不知道这些消息传递传递到了哪些队列中。
相反,生产者只能将消息发送到交换机(exchange),交换机工作的内容非常简单,一方面它接收来自生产者的消息,另一方面将它们推入队列。交换机必须确切知道如何处理收到的消息。是应该把这些消息放到特定队列还是说把他们到许多队列中还是说应该丢弃它们。这就的由交换机的类型来决定。
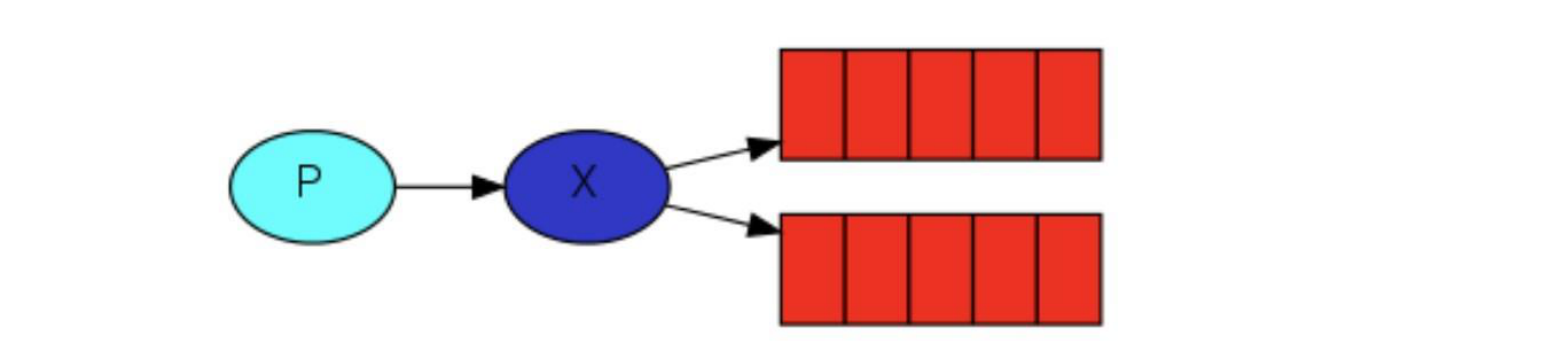
image-20211126152108121
Exchanges 的类型总共有四种:直接(direct)、主题(topic)、标题(headers)、扇出(fanout)
📦 无名exchange
在本文的前面部分我们对 exchange 一无所知,但仍然能够将消息发送到队列。这是因为我们使用的是默认交换机,我们通过空字符串(“”)进行标识。

image-20211126181609775
📄 临时队列
上文所有例子中我们都使用的是具有特定名称的队列,队列的名称我们来说至关重要,用于指定消费者去消费哪个队列的消息。每当我们连接到 RabbitMQ 时都需要一个全新的空队列,但很多时候我们可能不想指定队列名字,只想实验测试一下,此时我们可以创建一个具有随机名称的队列,一旦我们断开了消费者的连接,该队列将被自动删除。这就是临时队列。
// 创建一个临时队列
String queueName = channel.queueDeclare().getQueue();
创建出来之后长成这样:
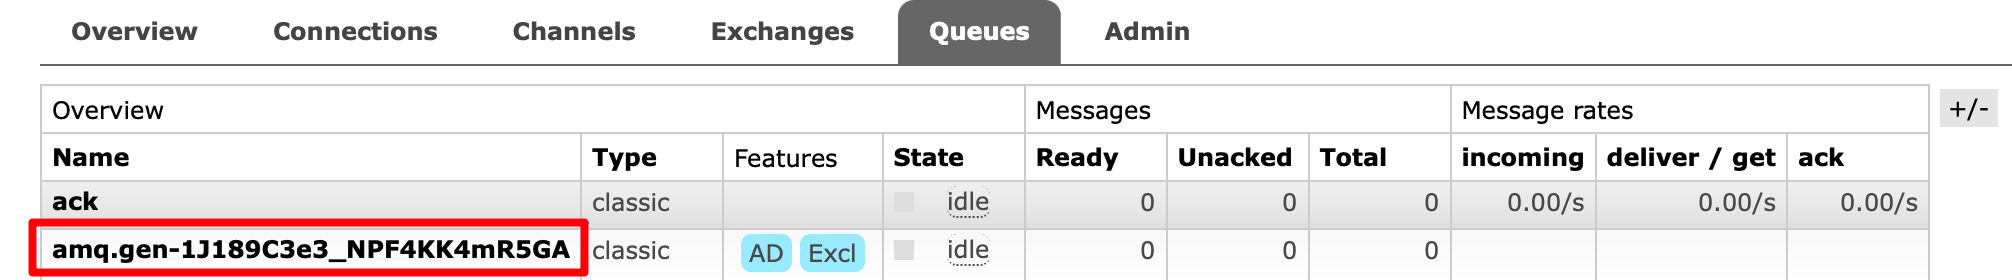
image-20211126182620695
🐼 绑定
我们提到,生产者发消息都是发给交换机,由交换机对消息进行路由到队列,那么交换机这么知道将消息发给哪个队列呢?这就是 routing-key 要做的事,它是 exchange 和 queue 之间的桥梁,告诉我们 exchange 和那个队列进行了绑定关系。比如说下面这张图告诉我们的就是 X 与 Q1 和 Q2 进行了绑定。
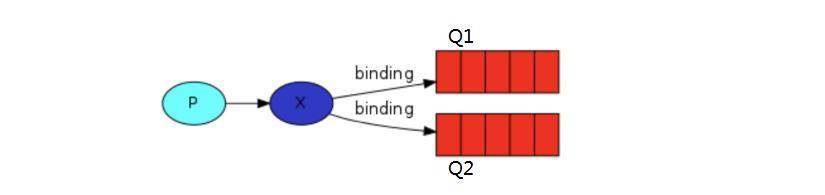
image-20211126190703303
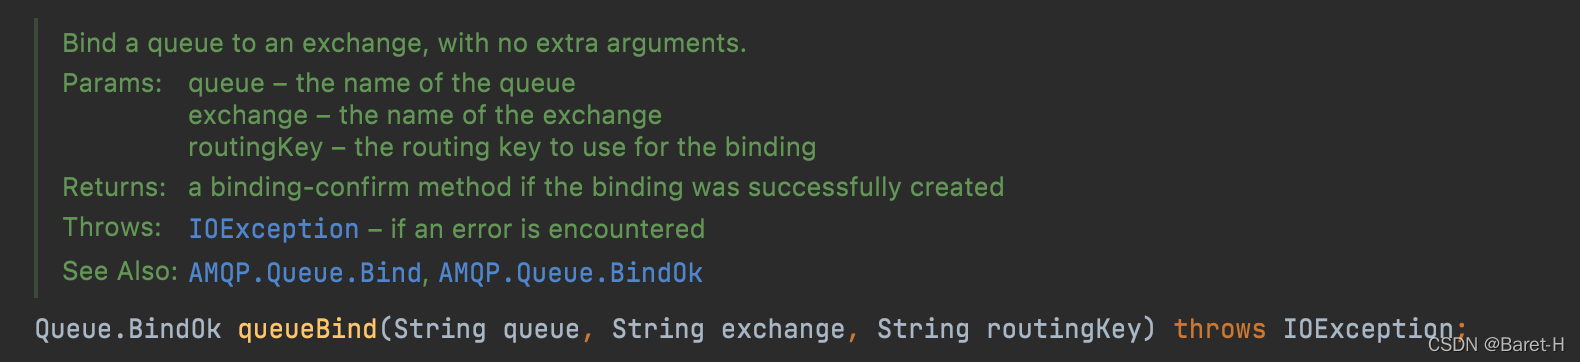
queueBind方法中的第三个参数就是设定routing-key的值,用于设定交换机和队列的绑定关系。
在这里插入图片描述
6.2、Fanout模式——RabbitMQ发布订阅模式
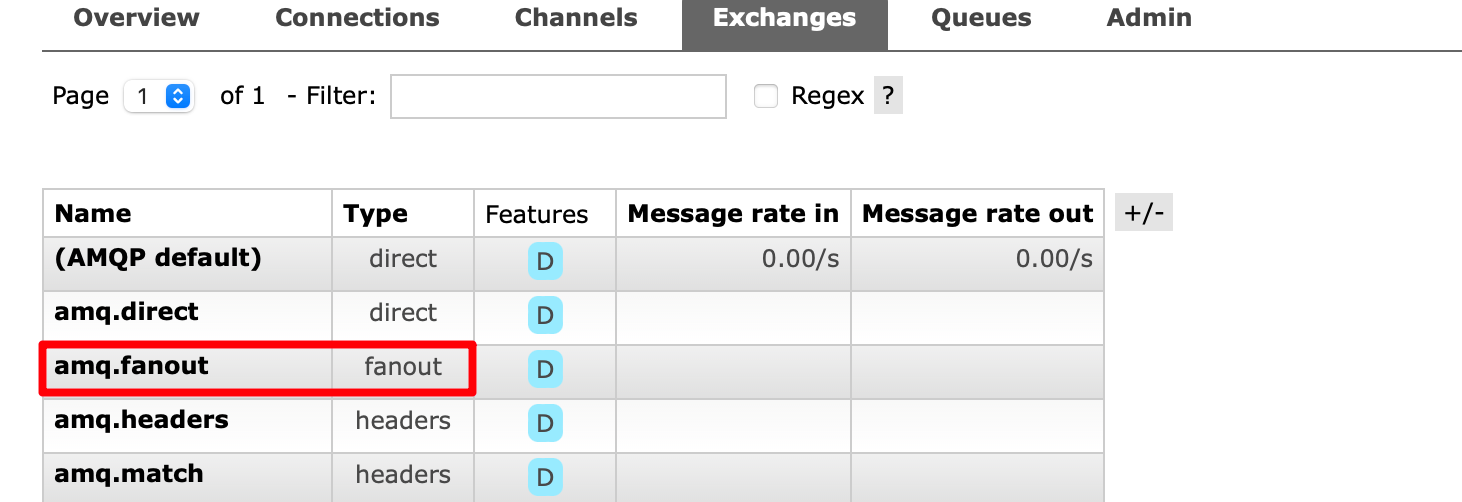
image-20211126183034319
接下来我们来通过代码实战,来看看 fanout 交换机的实现效果,我们要实现的示意图如下所示:
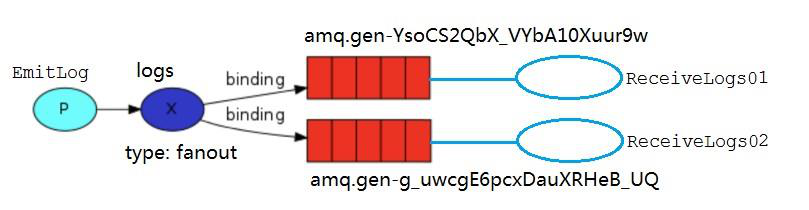
image-20211126183130247
有一个生产者,一个fanout模式的交换机绑定了两个临时队列,然后分别对应了两个消费者。
然后我们运行测试,当发送者发送我们指定当那些消息后:
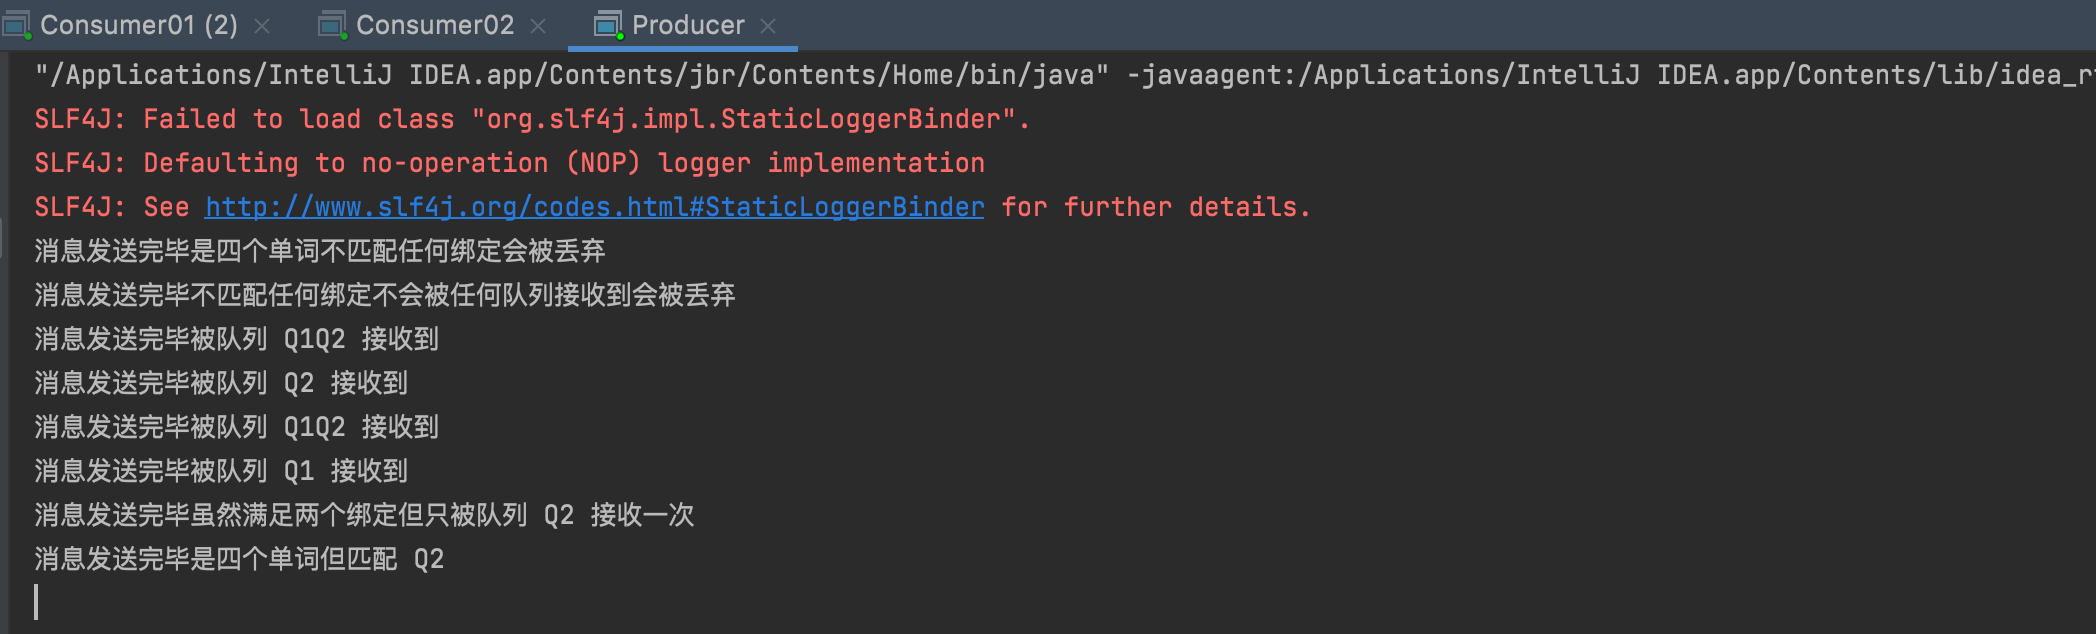
image-20211128135104715
我们来看两个消费者消费的消息,与我们上述假定的一致。
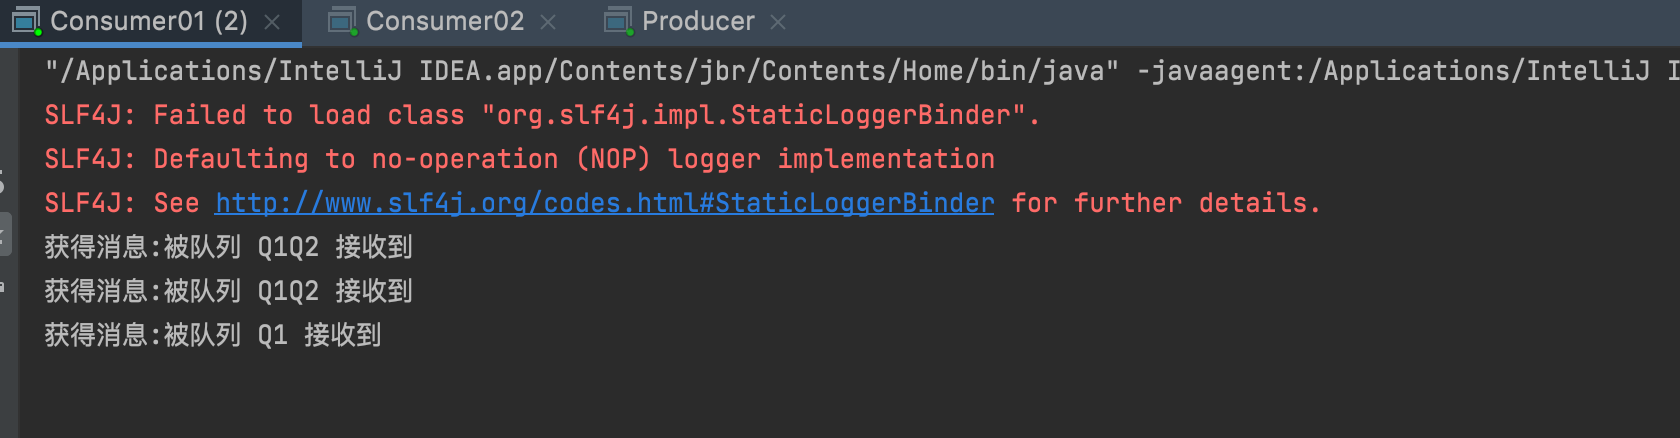
image-20211128135121960
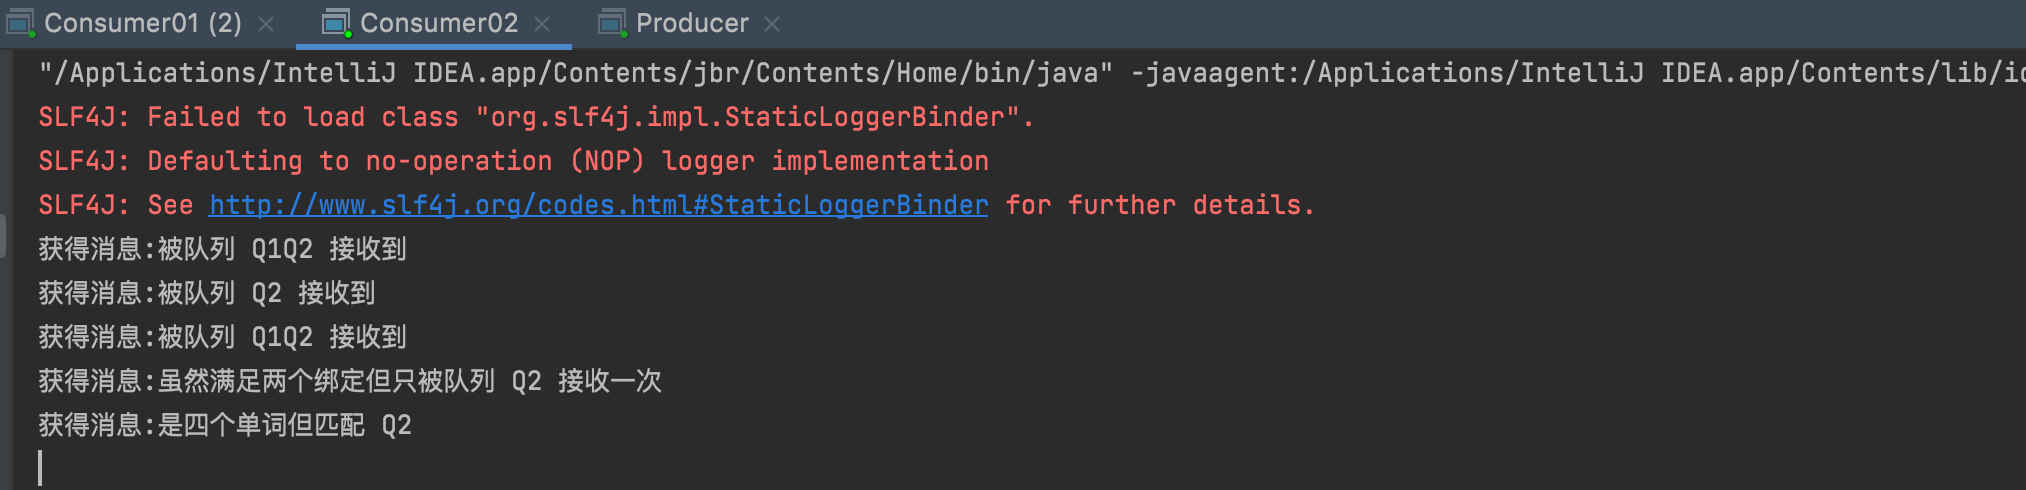
image-20211128135130283
七、RabbitMQ的一些机制
7.1、消息应答
默认情况下,RabbitMQ 一旦向消费者发送了一条消息后,便立即将该消息标记为删除。由于消费者处理一个消息可能需要一段时间,假如在处理消息中途消费者挂掉了,我们会丢失其正在处理的消息以及后续发送给该消费这的消息。 为了保证消息在发送过程中不丢失,RabbitMQ 引入消息应答机制,消息应答意思就是:消费者在接收消息并且处理完该消息之后,才告知 RabbitMQ 可以把该消息删除了。 RabbitMQ 中消息应答方式有两种:自动应答(默认)、手动应答
RabbitMQ 中消息应答通过以下方法来实现:
// 肯定确认
void basicAck(long deliveryTag, boolean multiple)

// 否定确认
void basicNack(long deliveryTag, boolean multiple, boolean requeue)
void basicReject(long deliveryTag, boolean requeue)其中:deliveryTag表示消息的标志,multiple表示是否为批量应答(ture 代表批量应答channel上未应答的消息,比如当前channel上有传送tag为5678的消息,如果应答时tag=8,则5~8的这些还未应答的消息都会被确认收到消息应答;如果为 false 则此时只会应答tag=8的消息,567的消息不会被应答)
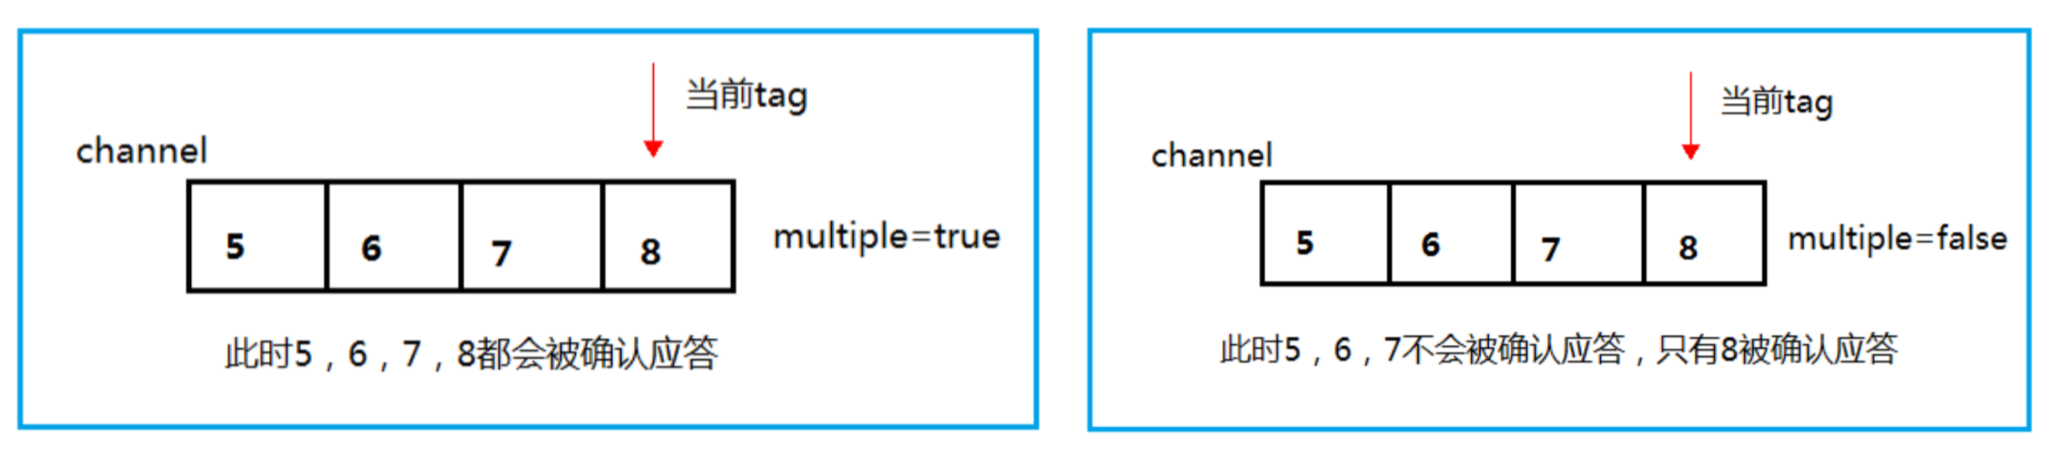
image-20211126000036651
自动应答
自动应答即消息发送后立即被认为已经传送成功,也就是RabbitMQ默认采用的消息应答方式。这种模式需要在高吞吐量和数据传输安全性方面做权衡,因为该模式下如果消息在被接收之前,消费者的 connection 或者 channel 关闭,消息就丢失了。此外,由于消费者没有对传递的消息数量进行限制,发送方可以传递过载的消息,可能会造成消费者这边由于接收太多消息来不及处理,导致这些消息的积压,使得内存耗尽,最终使得这些消费者线程被操作系统杀死。
所以这种模式仅适用在消费者可以高效并以某种速率能够处理这些消息的情况下使用。
手动应答
采用手动应答后的消息自动重新入队可以避免自动应答中消息丢失的情况。如果消费者由于某些原因失去连接(其通道已关闭,连接已关闭或 TCP 连接丢失),导致消息未发送 ACK 确认,RabbitMQ 将了解到消息未完全处理,并将对其重新排队。如果此时其他消费者可以处理,它将很快将其重新分发给另一个消费者。这样,即使某个消费者偶尔死亡,也可以确保不会丢失任何消息。
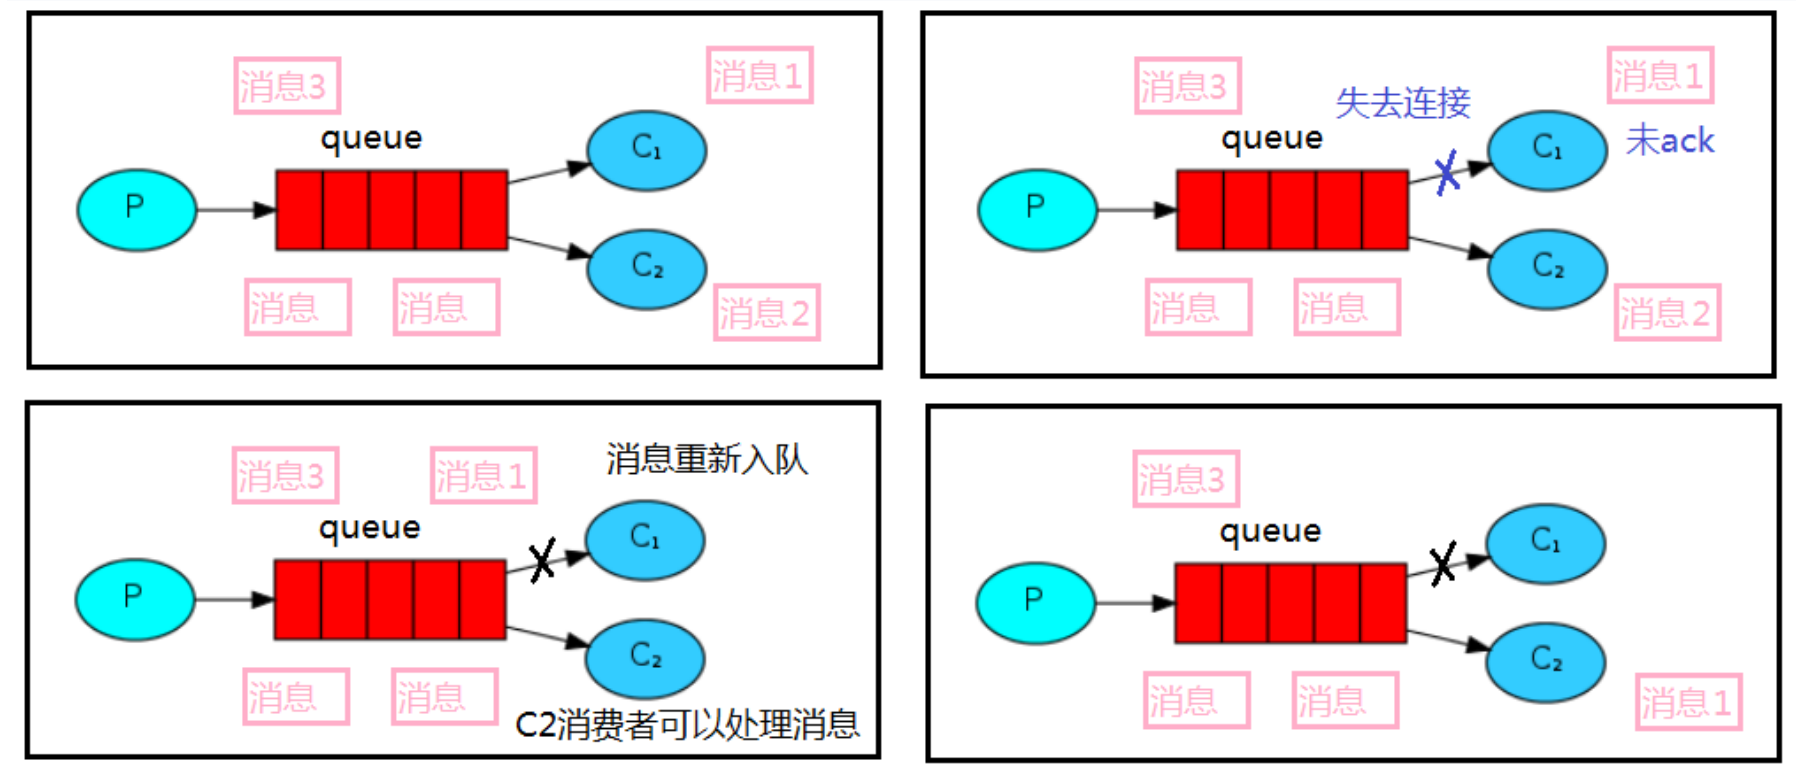
image-20211126000606506
我们来通过代码实现一下,只需要对上述 Work Queues 示例代码作出简单修改:
生产者:
package mode2_WorkQueues.ack;

import com.rabbitmq.client.Channel;

import java.util.Scanner;

public class Producer {
    public static String QUEUE_NAME = "ack";

    public static void main(String[] args) throws Exception {
        // 创建channel
        Channel channel = utils.RabbitMqUtils.getChannel();
      	// 声明队列
     		channel.queueDeclare(QUEUE_NAME, false, false, false, null);
        // 发送消息
        Scanner scanner = new Scanner(System.in);
        while (scanner.hasNext()) {
            String message = scanner.next();
            channel.basicPublish("", QUEUE_NAME, null, message.getBytes());
            System.out.println("消息发送完毕" + message);
        }
    }
}消费者1:其中消费消息的回调接口中我们模拟了接收消息的延迟为1s
package mode2_WorkQueues.ack;

import com.rabbitmq.client.CancelCallback;
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.DeliverCallback;

// 测试手动应答
public class Consumer01 {
    public static String QUEUE_NAME = "ack";

    public static void main(String[] args) throws Exception {
        // 创建channel
        Channel channel = utils.RabbitMqUtils.getChannel();
        System.out.println("consumer1收到消息时间较短");
        // 消费消息的回调
        DeliverCallback deliverCallback = (consumerTag, message) -> {
            // 模拟接受消息的延迟 1s
            try {
                Thread.sleep(1000 * 1);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            System.out.println("消息成功消费!内容为:" + new String(message.getBody()));
            // 手动应答:第一个参数表示消息标记tag、第二个参数false表示不进行批量应答
            channel.basicAck(message.getEnvelope().getDeliveryTag(), false);
        };
        // 取消消费的回调
        CancelCallback cancelCallback = (consumerTag) -> {
            System.out.println("消息消费被中断");
        };
      	// 消费消息(第2个参数修改为false表示手动应答)
        channel.basicConsume(QUEUE_NAME, false, deliverCallback, cancelCallback);
    }
}消费者2:其中消费消息的回调接口中我们模拟了接收消息的延迟为10s
package mode2_WorkQueues.ack;

import com.rabbitmq.client.CancelCallback;
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.DeliverCallback;

// 测试手动应答
public class Consumer02 {
    public static String QUEUE_NAME = "ack";

    public static void main(String[] args) throws Exception {
        // 创建channel
        Channel channel = utils.RabbitMqUtils.getChannel();
        System.out.println("consumer2收到消息时间较长");
      	// 消费消息的回调
        DeliverCallback deliverCallback = (consumerTag, message) -> {
            // 模拟接受消息的延迟 10s
            try {
                Thread.sleep(1000 * 10);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            System.out.println("消息成功消费!内容为:" + new String(message.getBody()));
            // 手动应答:第一个参数表示消息标记tag、第二个参数false表示不进行批量应答
            channel.basicAck(message.getEnvelope().getDeliveryTag(), false);
        };
      	// 取消消费的回调
        CancelCallback cancelCallback = (consumerTag) -> {
            System.out.println("消息消费被中断");
        };
        // 消费消息(第2个参数修改为false表示手动应答)
        channel.basicConsume(QUEUE_NAME, false, deliverCallback, cancelCallback);
    }
}测试:首先启动生产者producer,然后启动两个消费者consumer01和consumer02。然后通过producer发送4条消息:
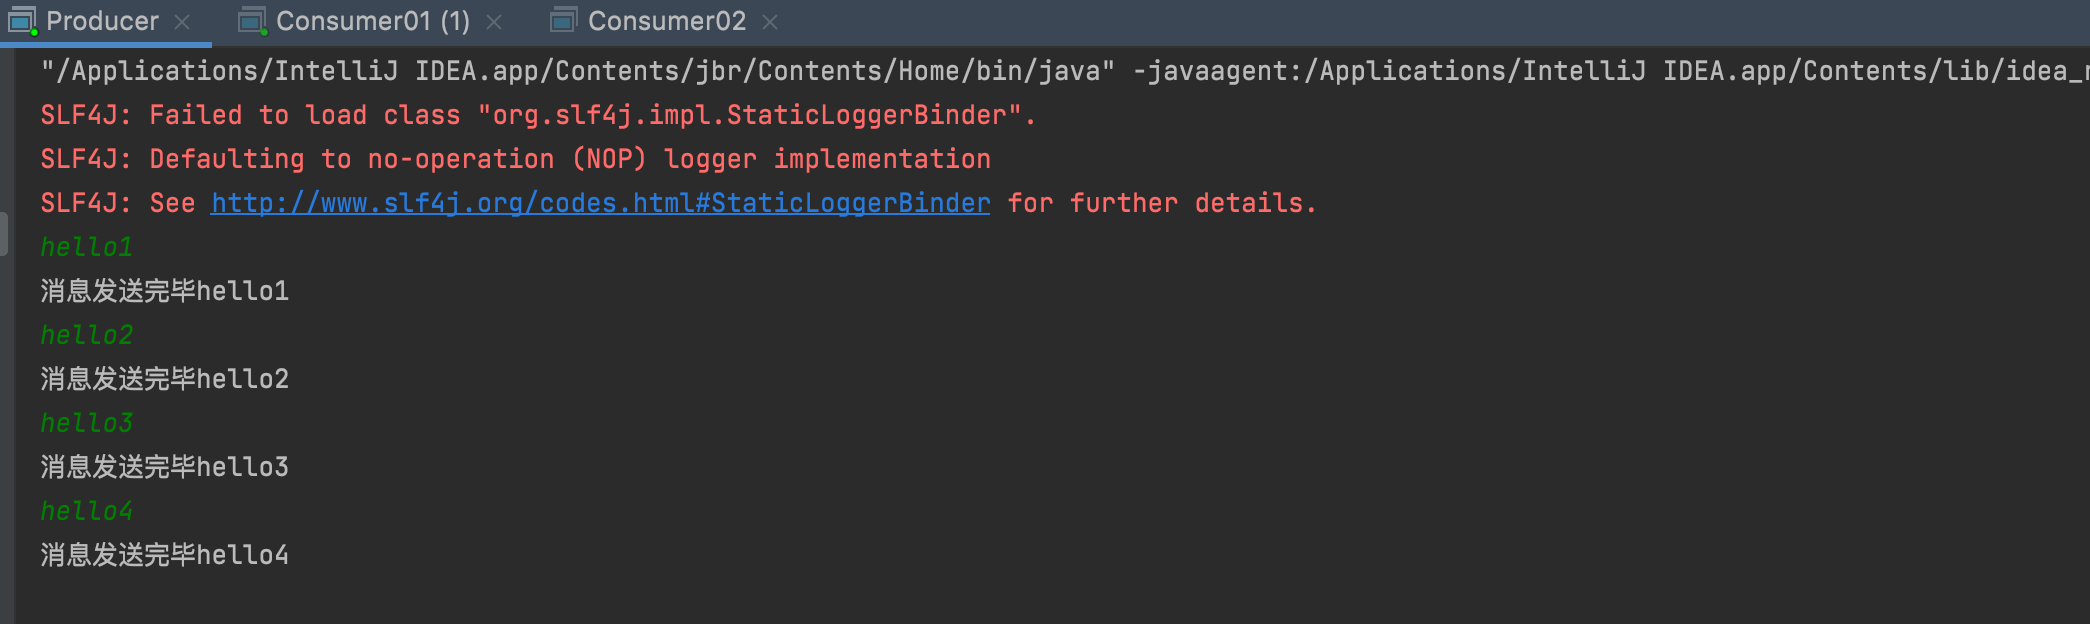
image-20211126002205916
由于consumer01消费时间只有1s,因此可以立马看到consumer01根据轮询的规则收到了1、3条消息
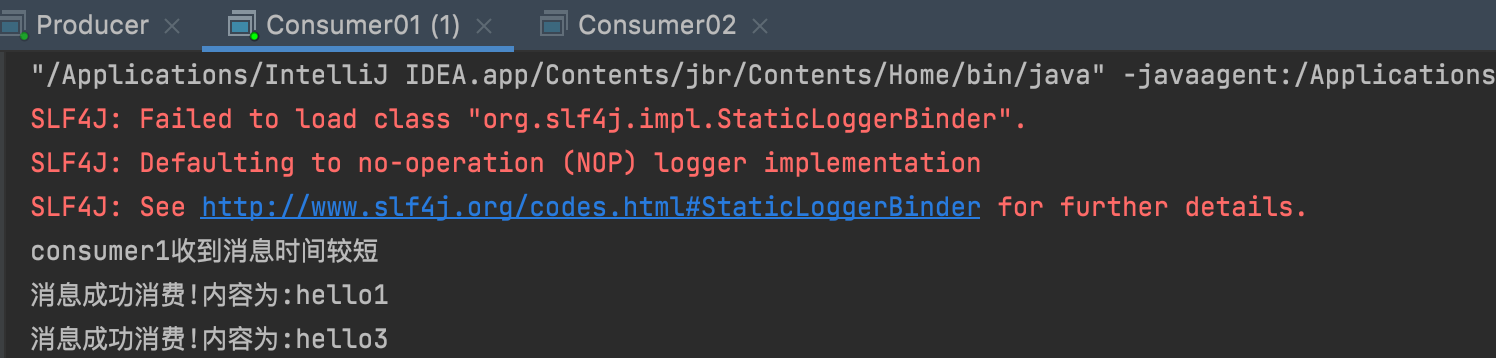
image-20211126002301330
按照默认的轮询机制,2、4条消息由consumer02来消费,10s后consumer2能正常收到。但此时如果我们停止Consumer02线程
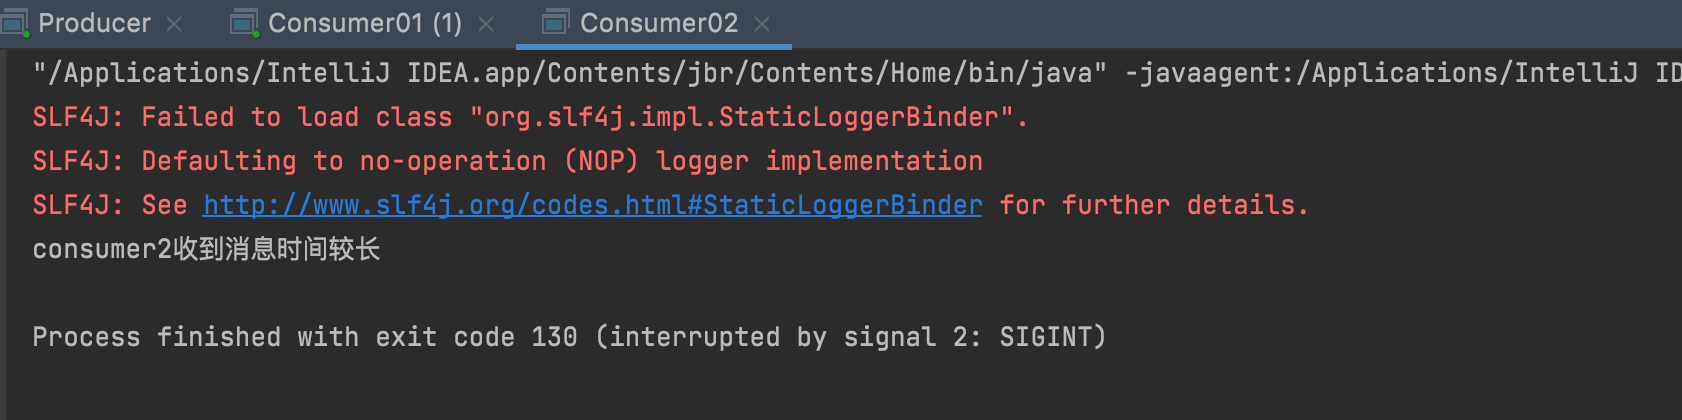
image-20211126002439823
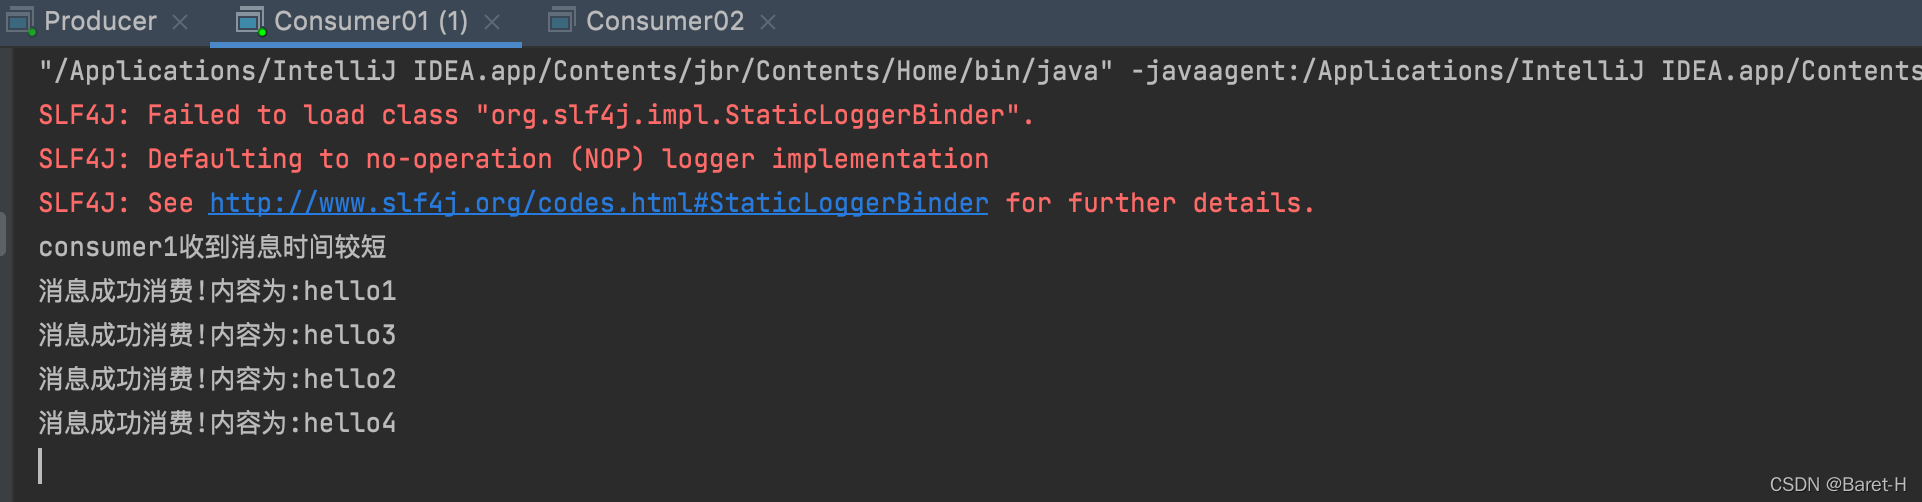
过一会再看consumer01,可以看到它消费了2、4条消息
在这里插入图片描述
这就是手动应答的消息重新入队机制,我们避免了consumer02停机而造成原本分配给它消息的丢失问题。
7.2、持久化
前面我们通过手动应答处理了消息丢失的情况,但是如何保障当 RabbitMQ 服务停掉以后消息生产者发送过来的消息不丢失。默认情况下 RabbitMQ 退出或由于某种原因崩溃时,它会清空队列和消息,除非告知它不要这样做。确保消息不会丢失需要做两件事:我们需要将队列和消息都标记为持久化。
队列持久化
之前我们创建的队列都是非持久化的,RabbitMQ 如果重启,该队列就会被删除掉,如果要队列实现持久化就需要在声明队列的时候把 durable 参数设置为 true

image-20211126004721380
需要注意的是如果之前声明的队列不是持久化的,需要把原先队列先删除,或者重新创建一个持久化的队列,不然就会错误:

image-20211126010546934
以下为控制台中持久化与非持久化队列的 UI 显示区:
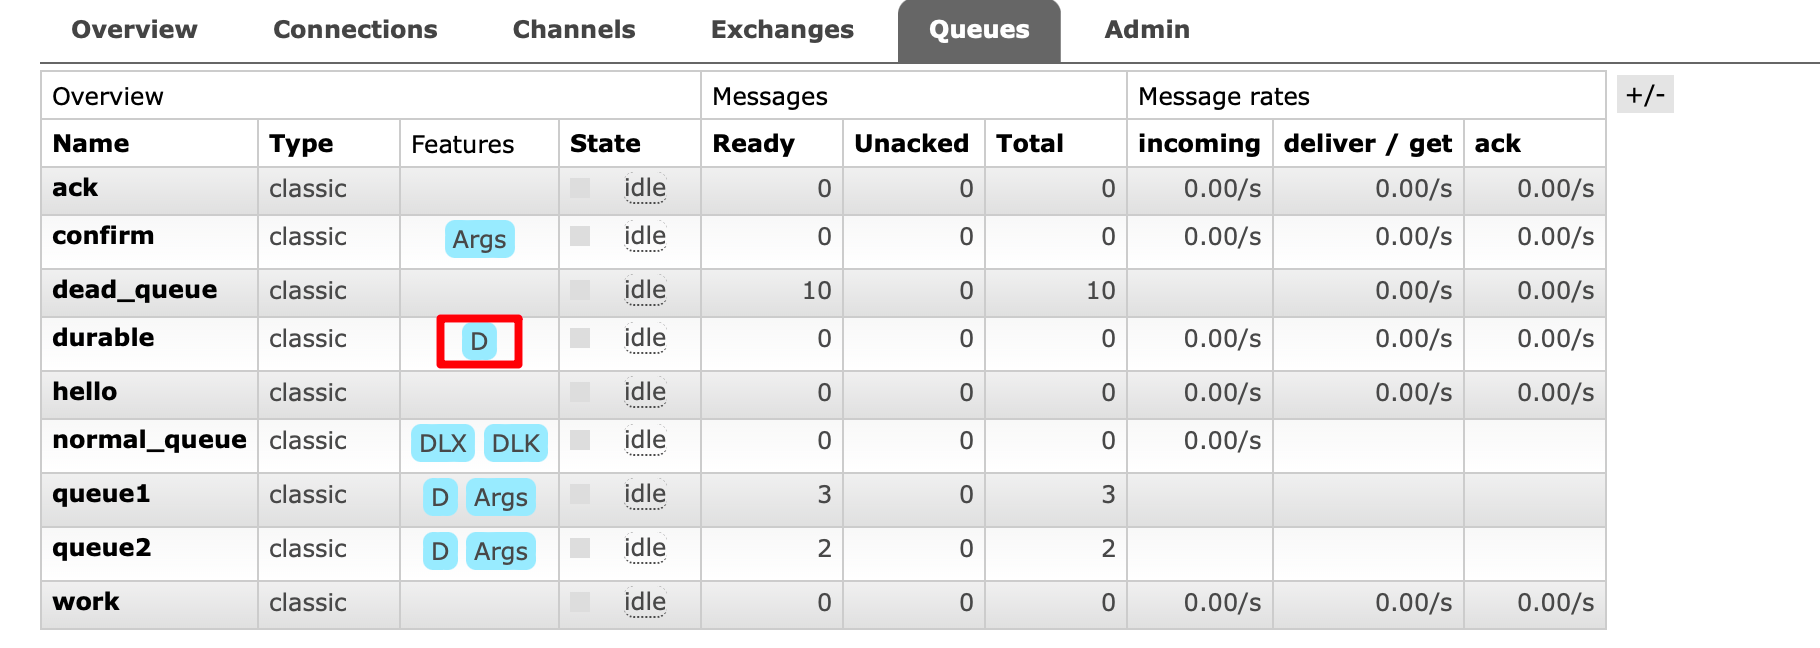
image-20211126004828772
消息持久化
要想让消息实现持久化需要在消息生产者修改代码,添加MessageProperties.PERSISTENT_TEXT_PLAIN 属性。
将消息标记为持久化并不能完全保证不会丢失消息。尽管它告诉 RabbitMQ 将消息保存到磁盘,但是这里依然存在当消息刚准备存储在磁盘的时候 但是还没有存储完,消息还在缓存的一个间隔点。此时并没有真正写入磁盘。持久性保证并不强,但是对于我们的简单任务队列而言,这已经绰绰有余了。如果需要更强有力的持久化策略,参考后边课件发布确认章节。
7.3、不公平分发
前面我们了解到 RabbitMQ 默认分发消息采用的轮训分发模式,但是在某种场景下这种策略并不是很好,比方说有两个消费者在处理任务,其中 consumer01 处理任务的速度非常快,而 consumer02 处理速度却很慢,此时如果我们还是采用轮训分发的化就会使处理速度快的 consumer01 很大一部分时间处于空闲状态,而 consumer02 一直在干活,这种分配方式在这种情况下其实就不太好,但是 RabbitMQ 并不知道这种情况它依然很公平的进行分发。
为了避免这种情况,我们可以设置参数 channel.basicQos(1),意思就是每个消费者只能处理完当前消息才能接受新的消息。

image-20211126010050393
设置之后示意图如下所示:
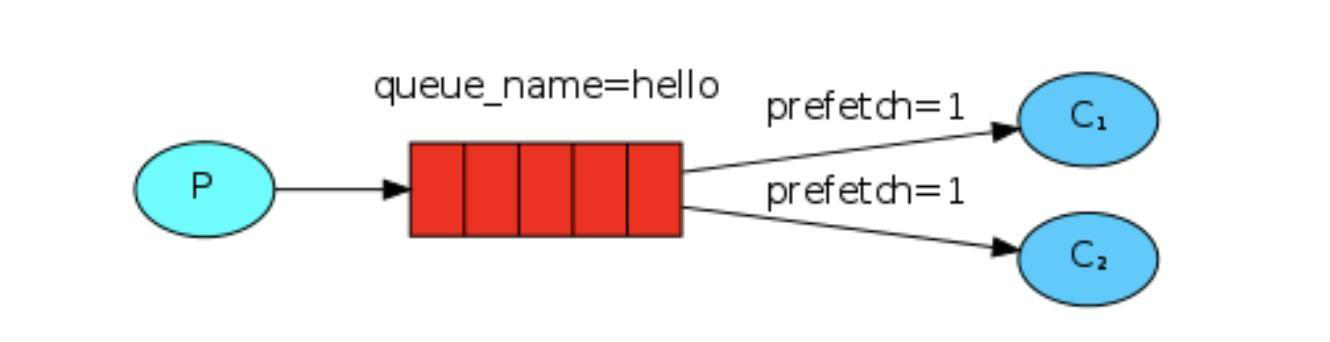
image-20211126010109656
可以理解如果当前消息我没有处理完的话或者还没有应答的话,新的消息就先别分配给我,我目前只能处理一个消息,然后 RabbitMQ 就会把该任务分配给没有那么忙的那个空闲消费者,当然如果所有的消费者都没有完成手上任务,队列还在不停的添加新任务,队列有可能就会遇到队列被撑满的情况,这个时候就只能添加新的消费者 或者改变其他存储任务的策略。
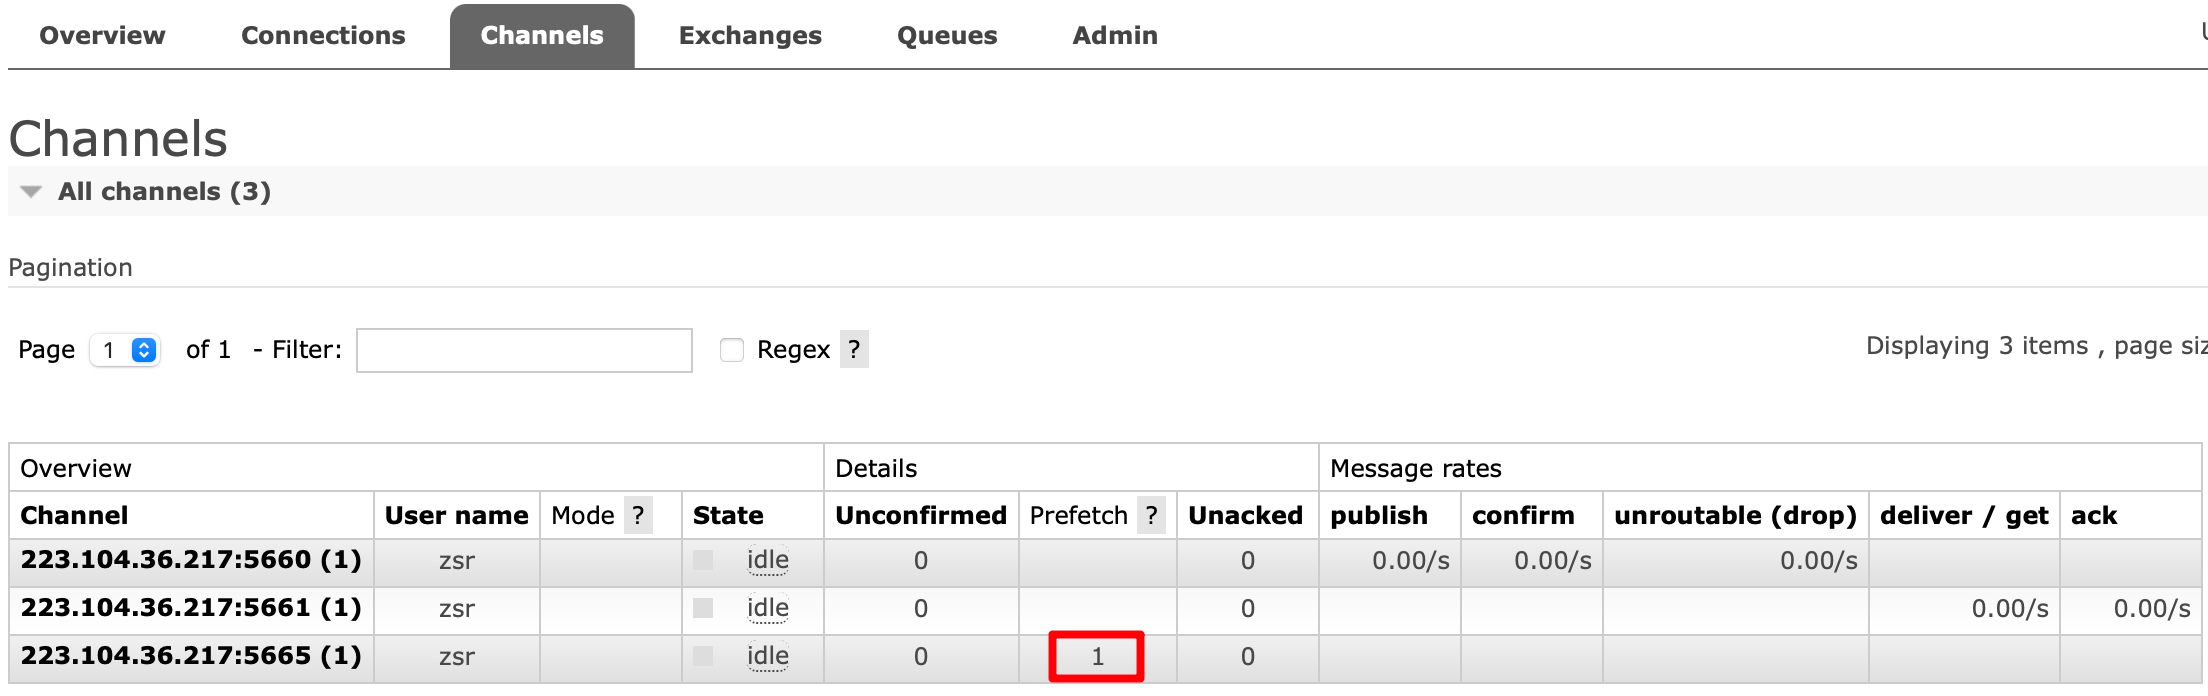
image-20211126010639449
7.4、预取值
本身消息的发送就是异步发送的,所以在任何时候,channel 上肯定不止只有一个消息另外来自消费者的手动确认本质上也是异步的。因此这里就存在一个未确认的消息缓冲区,因此希望开发人员能限制此缓冲区的大小,以避免缓冲区里面无限制的未确认消息问题。
这个时候就可以通过使用 basic.qos 方法设置“预取计数”值来完成。该值定义通道上允许的未确认消息的最大数量。一旦数量达到配置的数量,RabbitMQ 将停止在通道上传递更多消息,除非至少有一个未处理的消息被确认。假设在通道上有未确认的消息 5、6、7,8,并且通道的预取计数设置为 4,此时 RabbitMQ 将不会在该通道上再传递任何消息,除非至少有一个未应答的消息被 ack。比方说 tag=6 的消息刚刚被确认 ACK,RabbitMQ 将会感知这个情况到并再发送一条消息。
消息应答和 QoS 预取值对用户吞吐量有重大影响。通常增加预取将提高向消费者传递消息的速度,虽然自动应答传输消息速率是最佳的,但是在这种情况下已传递但尚未处理的消息的数量也会增加,从而增加了消费者的RAM消耗。我们应该小心使用具有无限预处理的自动确认模式或采用手动确认模式,消费者消费了大量的消息如果没有确认的话,会导致消费者连接节点的内存消耗变大,所以找到合适的预取值是一个反复试验的过程,不同的负载该值取值也不同 100 到 300 范围内的值通常可提供最佳的吞吐量,并且不会给消费者带来太大的风险。预取值为 1 是最保守的。当然这将使吞吐量变得很低,特别是消费者连接延迟很严重的情况下,特别是在消费者连接等待时间较长的环境中。对于大多数应用来说,稍微高一点的值将是最佳的。
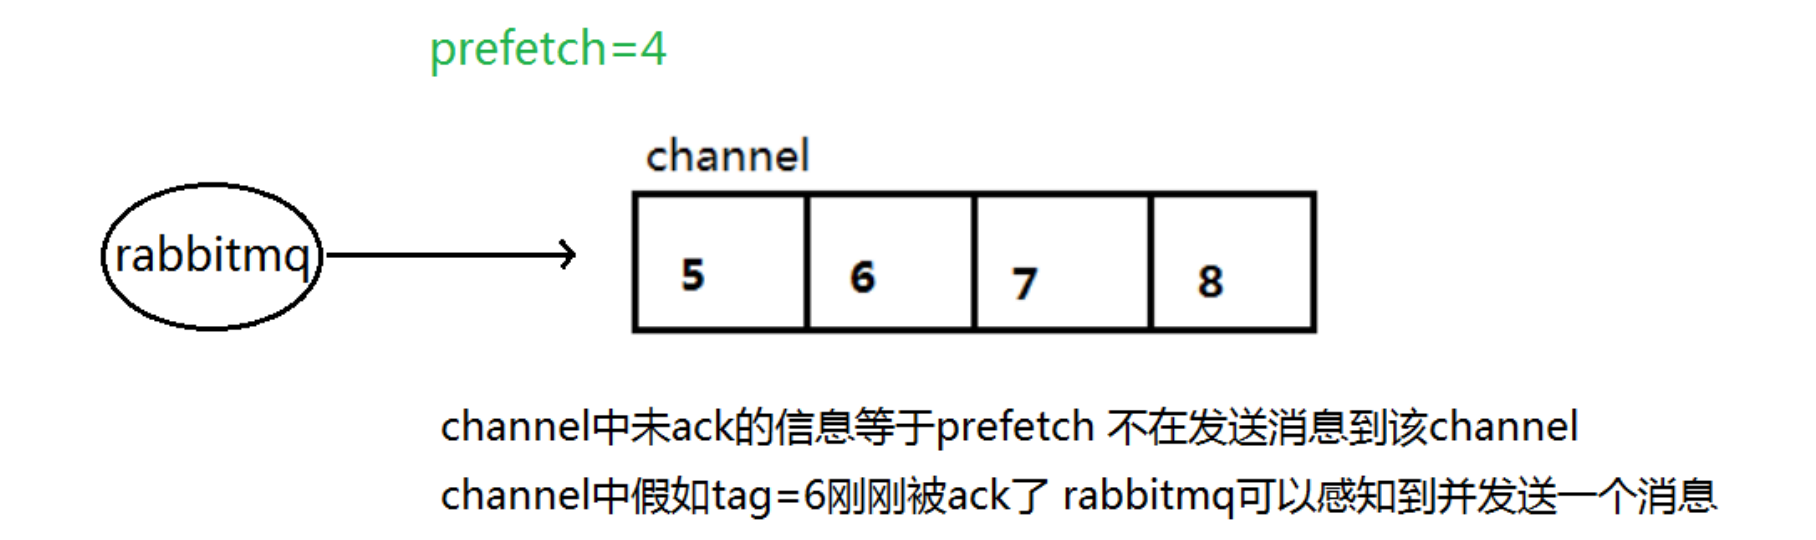
image-20211126012303017
代码示例:编写两个消费者consumer01和consumer02,预取值分别为5和2。然后编写一个消费者发送7条消息
consumer01:预取值5,模拟接受消息延迟1s
package mode2_WorkQueues.ack;

import com.rabbitmq.client.CancelCallback;
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.DeliverCallback;

// 测试手动应答
public class Consumer01 {
    public static String QUEUE_NAME = "prefetch";

    public static void main(String[] args) throws Exception {
        // 创建channel
        Channel channel = utils.RabbitMqUtils.getChannel();
        System.out.println("consumer1收到消息时间较短");
        // 设置预取值5
        channel.basicQos(5);
        // 消费消息(第2个参数修改为false表示手动应答)
        DeliverCallback deliverCallback = (consumerTag, message) -> {
            // 模拟接受消息的延迟 10s
            try {
                Thread.sleep(1000 * 1);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            System.out.println("消息成功消费!内容为:" + new String(message.getBody()));
            // 手动应答:第一个参数表示消息标记tag、第二个参数false表示不进行批量应答
            channel.basicAck(message.getEnvelope().getDeliveryTag(), false);
        };
        CancelCallback cancelCallback = (consumerTag) -> {
            System.out.println("消息消费被中断");
        };
        channel.basicConsume(QUEUE_NAME, false, deliverCallback, cancelCallback);
    }
}
consumer02:预取值2,模拟接受消息延迟10s
package mode2_WorkQueues.ack;

import com.rabbitmq.client.CancelCallback;
import com.rabbitmq.client.Channel;
import com.rabbitmq.client.DeliverCallback;

// 测试手动应答
public class Consumer02 {
    public static String QUEUE_NAME = "prefetch";

    public static void main(String[] args) throws Exception {
        // 创建channel
        Channel channel = utils.RabbitMqUtils.getChannel();
        System.out.println("consumer2收到消息时间较长");
        // 设置预取值2
        channel.basicQos(2);
        // 消费消息(第2个参数修改为false表示手动应答)
        DeliverCallback deliverCallback = (consumerTag, message) -> {
            // 模拟接受消息的延迟 1s
            try {
                Thread.sleep(1000 * 10);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            System.out.println("消息成功消费!内容为:" + new String(message.getBody()));
            // 手动应答:第一个参数表示消息标记tag、第二个参数false表示不进行批量应答
            channel.basicAck(message.getEnvelope().getDeliveryTag(), false);
        };
        CancelCallback cancelCallback = (consumerTag) -> {
            System.out.println("消息消费被中断");
        };
        channel.basicConsume(QUEUE_NAME, false, deliverCallback, cancelCallback);
    }
}
生产者:发送10条消息
package mode2_WorkQueues.ack;

import com.rabbitmq.client.Channel;

public class Producer {
    public static String QUEUE_NAME = "prefetch";

    public static void main(String[] args) throws Exception {
        // 创建channel
        Channel channel = utils.RabbitMqUtils.getChannel();
        // 发送消息
        channel.queueDeclare(QUEUE_NAME, false, false, false, null);
        for (int i = 0; i < 10; i++) {
            String message = i + "";
            channel.basicPublish("", QUEUE_NAME, null, message.getBytes());
            System.out.println("消息发送完毕" + message);
        }
    }
}
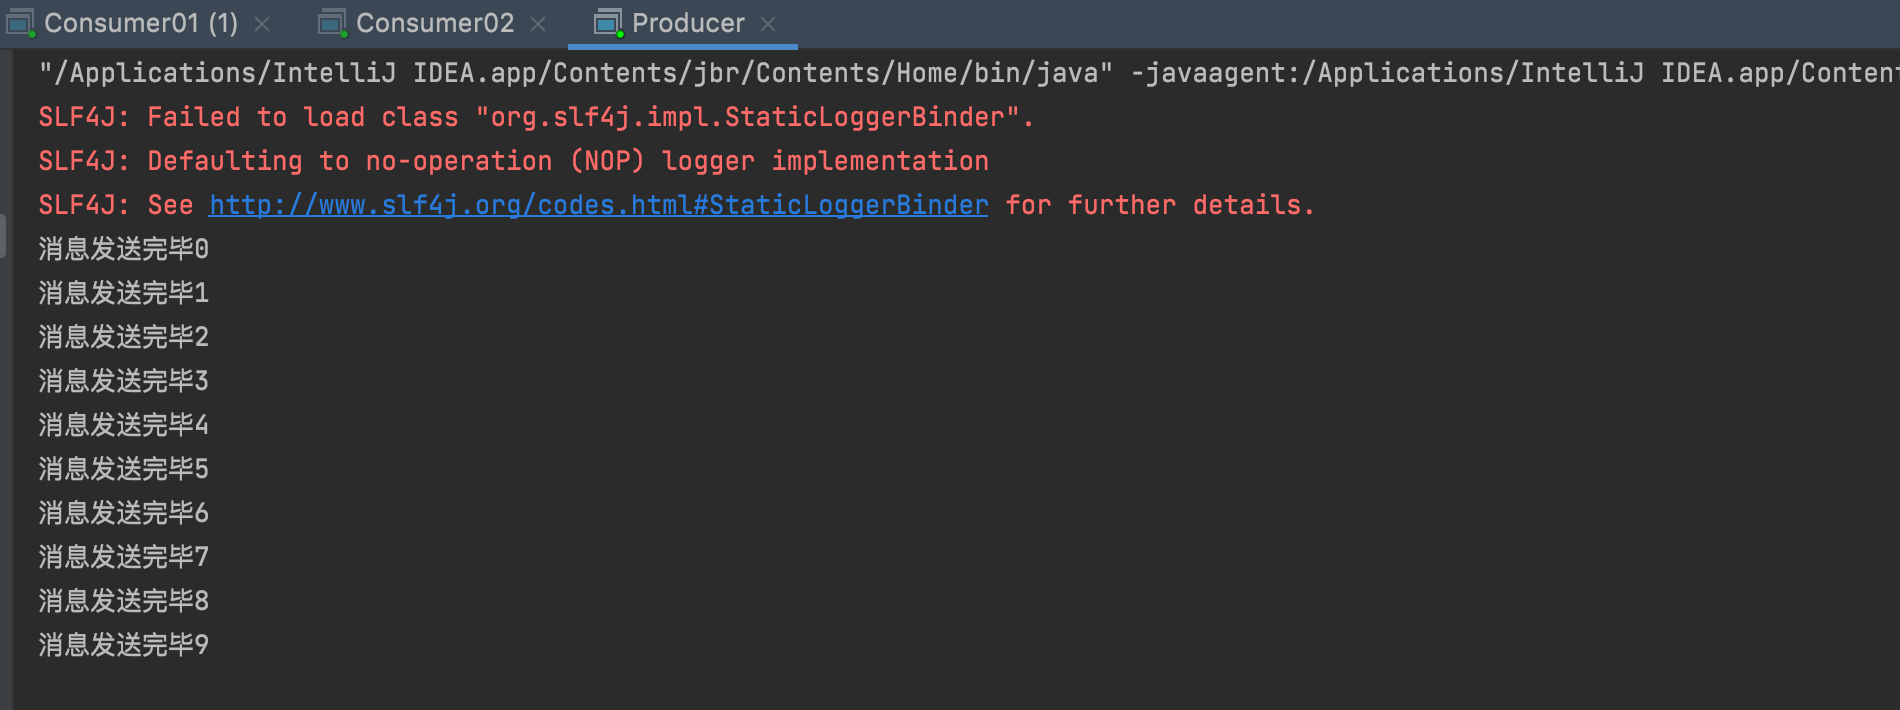
启动消费者发送10条消息,前7条消息按照预取值的设定应该分给5条给consumer01,2条给consumer02
qi
由于consumer01处理速度较快,consumer02处理较慢,所以consumer01处理完5条消息时consumer02还未处理第一条消息,因此后面的8、9、10条消息都会分配给consumer01进行消费。
对比以下结果,与我们设想的相同:
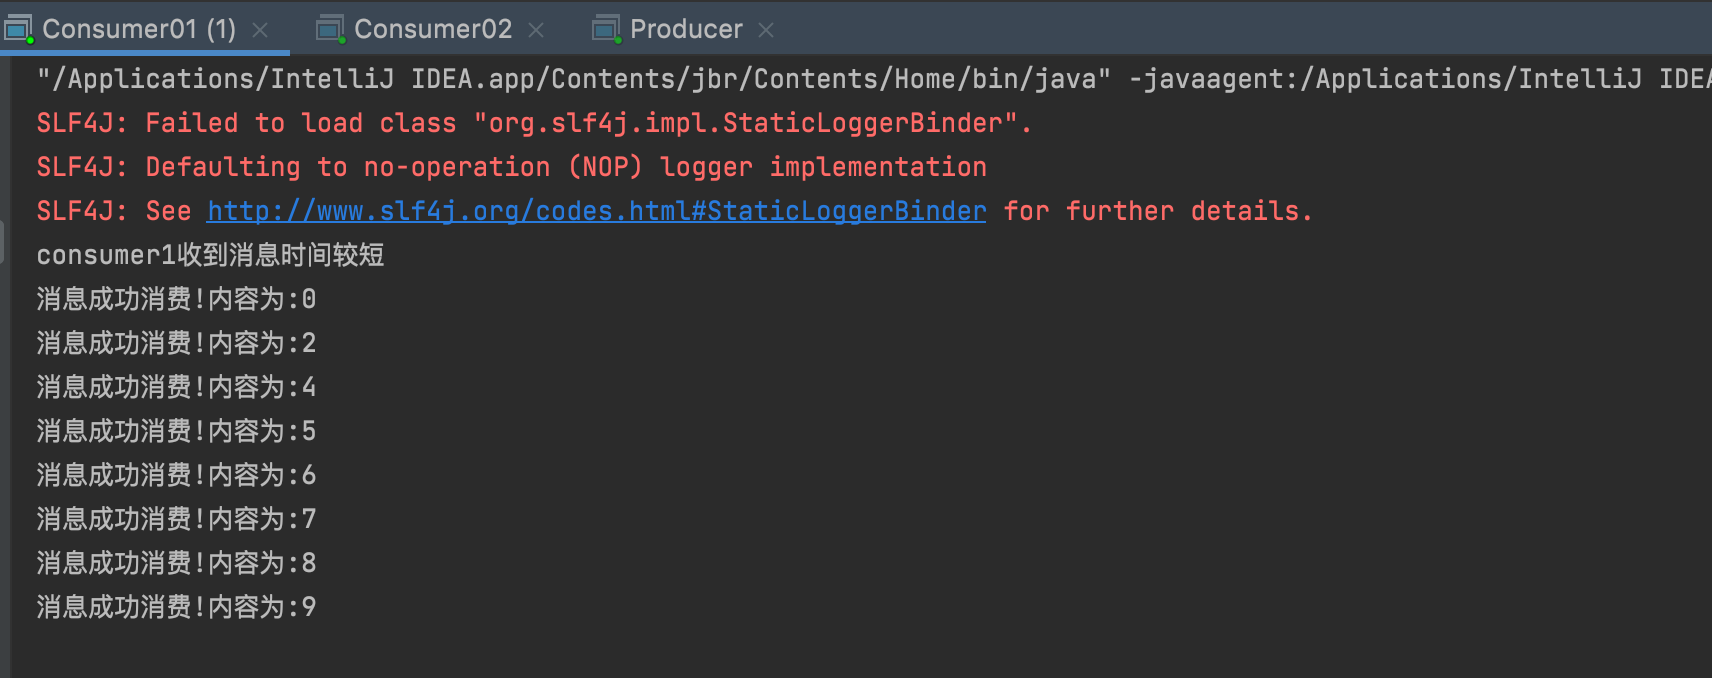
image-20211126142926458
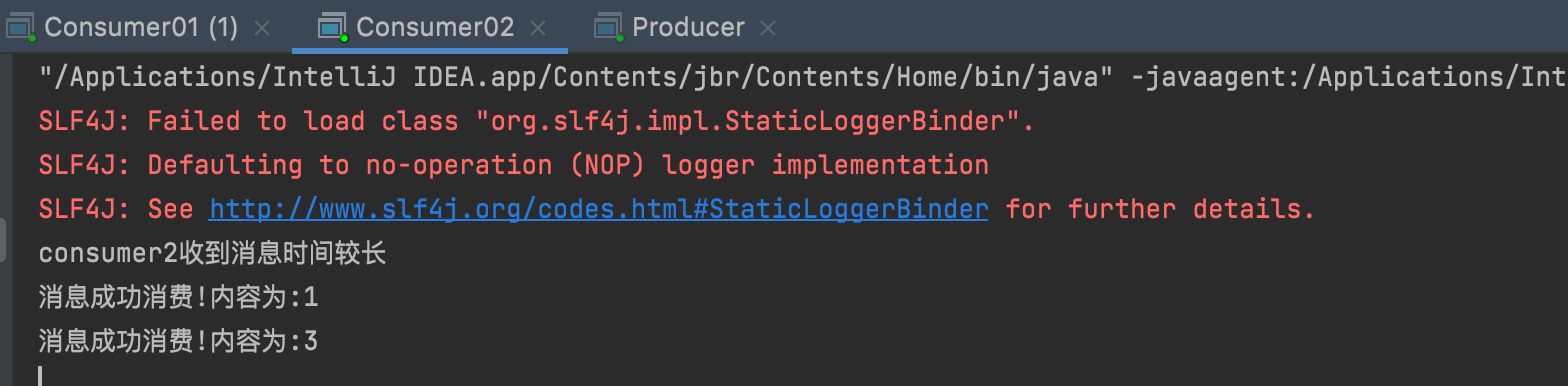
image-20211126142932983
7.5、发布确认
生产者将信道设置成 confirm 模式,一旦信道进入 confirm 模式,所有在该信道上面发布的消息都将会被指派一个唯一的 ID(从 1 开始),一旦消息被投递到所有匹配的队列之后,broker 就会发送一个确认给生产者(包含消息的唯一ID),这就使得生产者知道消息已经正确到达目的队列了,如果消息和队列是可持久化的,那么确认消息会在将消息写入磁盘之后发出,broker 回传给生产者的确认消息中 delivery-tag 域包含了确认消息的序列号,此外 broker 也可以设置basic.ack 的multiple 域,表示到这个序列号之前的所有消息都已经得到了处理。 confirm 模式最大的好处在于他是异步的,一旦发布一条消息,生产者应用程序就可以在等信道返回确认的同时继续发送下一条消息,当消息最终得到确认之后,生产者应用便可以通过回调方法来处理该确认消息,如果 RabbitMQ 因为自身内部错误导致消息丢失,就会发送一条 nack 消息,生产者应用程序同样可以在回调方法中处理该 nack 消息。
发布确认默认是没有开启的,如果要开启需要调用方法 confirmSelect,每当你要想使用发布确认,都需要在 channel 上调用该方法
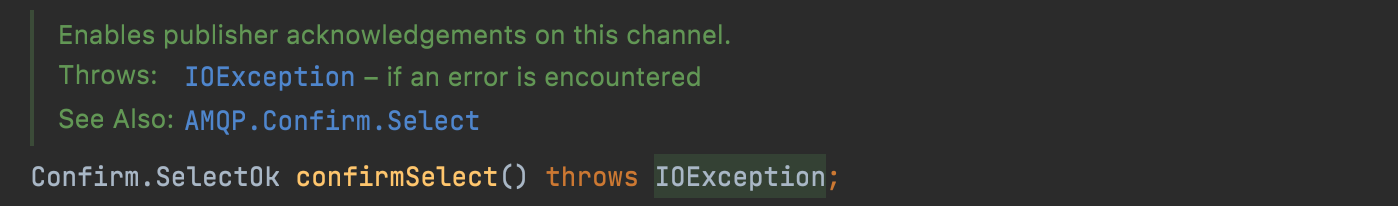
image-20211126143708957
// 开启发布确认
channel.confirmSelect();发布确认机制有三种策略:单个确认发布、批量确认发布、异步确认发布。其中前两者是同步确认的方式,也就是发布一个/一批消息之后只有被确认发布,后续的消息才能继续发布,后者是异步确认的方式,我们只管发布消息即可,消息是否被确认可以通过回调函数来接收到。
单个确认发布
这是一种简单的确认方式,它是一种同步确认发布的方式,也就是发布一个消息之后只有它被确认发布,后续的消息才能继续发布,waitForConfirmsOrDie(long)这个方法只有在消息被确认的时候才返回,如果在指定时间范围内这个消息没有被确认那么它将抛出异常。
这种确认方式有一个最大的缺点就是:发布速度特别的慢,因为如果没有确认发布的消息就会阻塞所有后续消息的发布,这种方式最多提供每秒不超过数百条发布消息的吞吐量。当然对于某些应用程序来说这可能已经足够了。
我们接下来进行测试,首先启动 Consumer01,然后启动 Consumer02,最后启动 Producer。
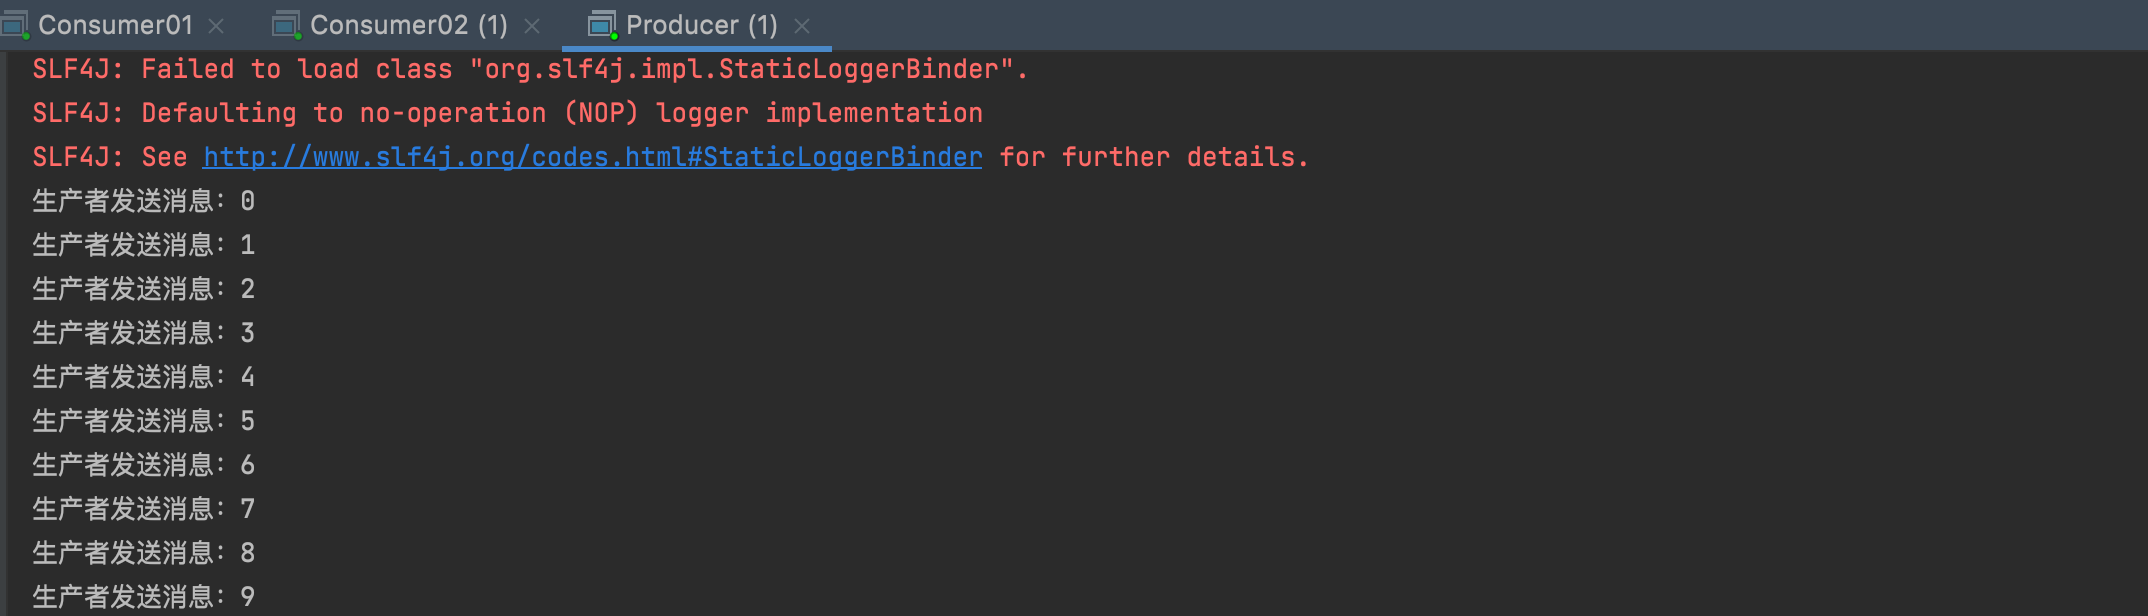
image-20211128210224045
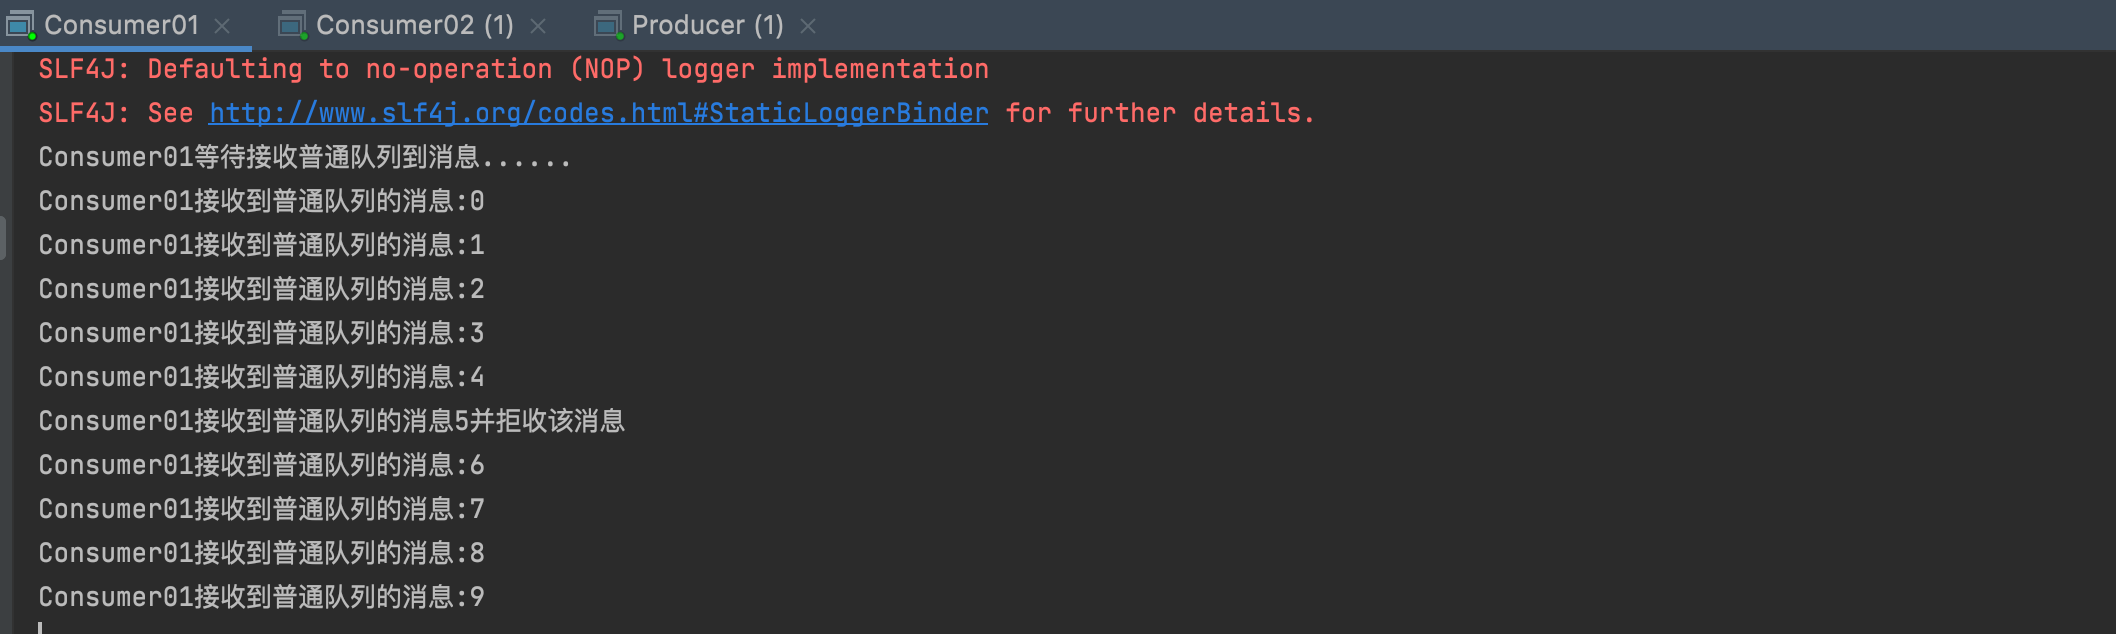
image-20211128210238936
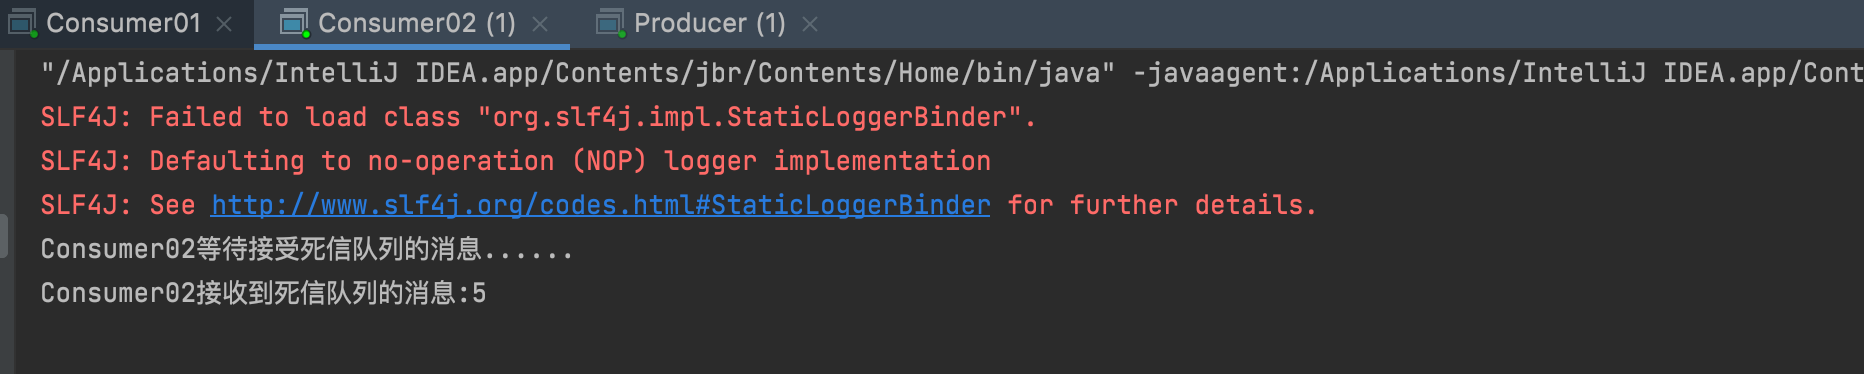
image-20211128210247919
根据结果可以看到,Consumer01 拒绝了消息5,消息5进入死信队列被 Consumer02 消费。
7.7、延迟队列
概念
延时队列,队列内部是有序的,最重要的特性就体现在它的延时属性上,延时队列中的元素是希望在指定时间到了以后或之前取出和处理,简单来说,延时队列就是用来存放需要在指定时间被处理的元素的队列。
使用场景
- 订单在十分钟之内未支付则自动取消。
- 新创建的店铺,如果在十天内都没有上传过商品,则自动发送消息提醒。
- 用户注册成功后,如果三天内没有登陆则进行短信提醒。
- 用户发起退款,如果三天内没有得到处理则通知相关运营人员。
- 预定会议后,需要在预定的时间点前十分钟通知各个与会人员参加会议。
这些场景都有一个特点,需要在某个事件发生之后或者之前的指定时间点完成某一项任务,如:发生订单生成事件,在十分钟之后检查该订单支付状态,然后将未支付的订单进行关闭;看起来似乎使用定时任务,一直轮询数据,每秒查一次,取出需要被处理的数据,然后处理不就完事了吗?如果数据量比较少,确实可以这样做,比如:对于“如果账单一周内未支付则进行自动结算”这样的需求,如果对于时间不是严格限制,而是宽松意义上的一周,那么每天晚上跑个定时任务检查一下所有未支付的账单,确实也是一个可行的方案。但对于数据量比较大,并且时效性较强的场景,如:“订单十分钟内未支付则关闭“,短期内未支付的订单数据可能会有很多,活动期间甚至会达到百万甚至千万级别,对这么庞大的数据量仍旧使用轮询的方式显然是不可取的,很可能在一秒内无法完成所有订单的检查,同时会给数据库带来很大压力,无法满足业务要求而且性能低下。
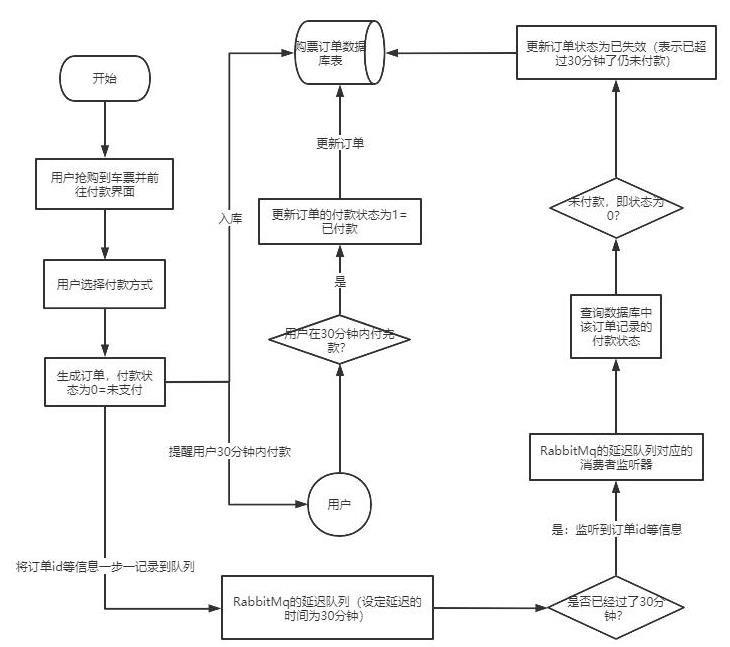
image-20211128213839535
RabbitMQ 中的 TTL
TTL 是什么呢?TTL 是 RabbitMQ 中一个消息或者队列的属性,表明一条消息或者该队列中的所有消息的最大存活时间,单位是毫秒。换句话说,如果一条消息设置了 TTL 属性或者进入了设置TTL 属性的队列,那么这条消息如果在TTL 设置的时间内没有被消费,则会成为"死信"。如果同时配置了队列的TTL 和消息的TTL,那么较小的那个值将会被使用,有两种方式设置 TTL:
1️⃣ 消息设置TTL
便是针对每条消息设置TTL
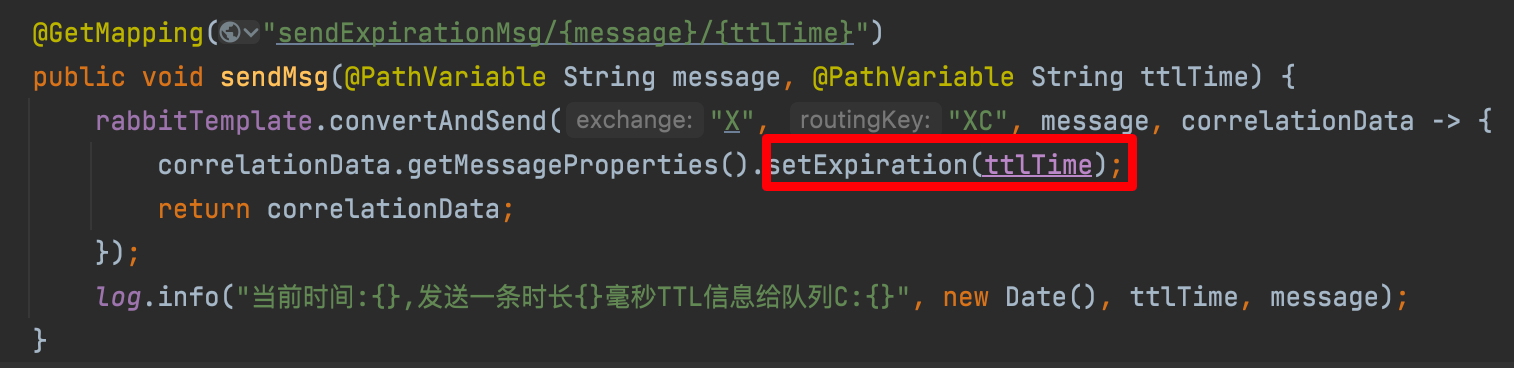
image-20211130131022884
2️⃣ 队列设置TTL
创建队列的时候设置队列的“x-message-ttl”属性

image-20211129122306588
如果设置了队列的 TTL 属性,那么一旦消息过期,就会被队列丢弃(如果配置了死信队列被丢到死信队列中)。而如果仅设置消息的 TTL 属性,即使消息过期,也不一定会被马上丢弃,因为消息是否过期是在即将投递到消费者之前判定的,如果当前队列有严重的消息积压情况,则已过期的消息也许还能存活较长时间;
还需要注意的一点是,如果不设置 TTL,表示消息永远不会过期,如果将 TTL 设置为 0,则表示除非此时可以直接投递该消息到消费者,否则该消息将会被丢弃。
前一小节我们介绍了死信队列,刚刚又介绍了 TTL,至此利用 RabbitMQ 实现延时队列的两大要素已经集齐,接下来只需要将它们进行融合,再加入一点点调味料,延时队列就可以新鲜出炉了。想想看,延时队列,不就是想要消息延迟多久被处理吗,TTL 则刚好能让消息在延迟多久之后成为死信,另一方面,成为死信的消息都会被投递到死信队列里,这样只需要消费者一直消费死信队列里的消息就完事了,因为里面的消息都是希望被立即处理的消息。
SpringBoot整合RabbitMQ实现延迟队列
环境搭建
这里在根目录下新建一个springboot的module
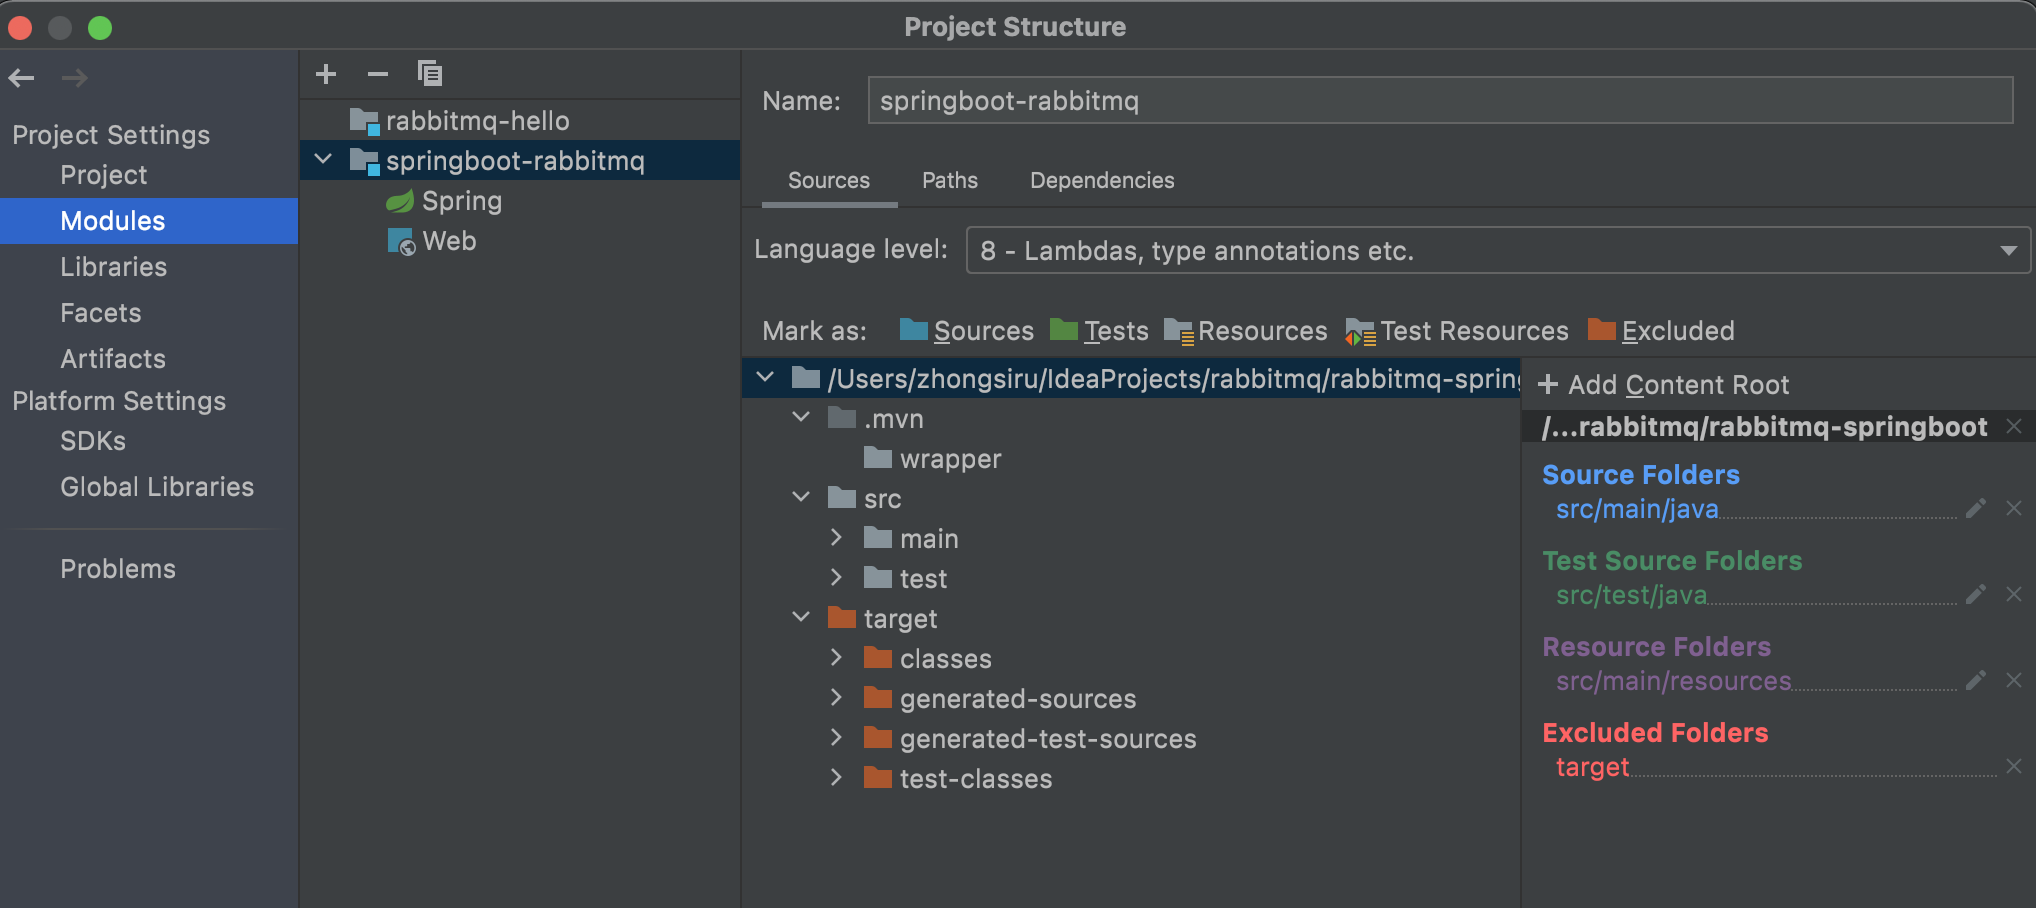
image-20211129203320523
然后导入依赖:
<dependencies>
  <dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter</artifactId>
  </dependency>
  <!--RabbitMQ 依赖-->
  <dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-amqp</artifactId>
  </dependency>
  <dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
  </dependency>
  <dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-test</artifactId>
    <scope>test</scope>
  </dependency>
  <dependency>
    <groupId>com.alibaba</groupId>
    <artifactId>fastjson</artifactId>
    <version>1.2.47</version>
  </dependency>
  <dependency>
    <groupId>org.projectlombok</groupId>
    <artifactId>lombok</artifactId>
  </dependency>
  <!--swagger-->
  <dependency>
    <groupId>io.springfox</groupId>
    <artifactId>springfox-swagger2</artifactId>
    <version>2.9.2</version>
  </dependency>
  <dependency>
    <groupId>io.springfox</groupId>
    <artifactId>springfox-swagger-ui</artifactId>
    <version>2.9.2</version>
  </dependency>
  <!--RabbitMQ 测试依赖-->
  <dependency>
    <groupId>org.springframework.amqp</groupId>
    <artifactId>spring-rabbit-test</artifactId>
    <scope>test</scope>
  </dependency>
</dependencies>然后修改src/main/resources/application.properties,添加 RabbitMQ 的配置,注意其中的host、username、password更改为自己的配置信息:
spring.rabbitmq.host=82.156.9.173
spring.rabbitmq.port=5672
spring.rabbitmq.username=zb
spring.rabbitmq.password=123456
通过设置队列TTL+死信实现消息延迟
1️⃣ 编写初始化类
代码架构图如下所示,其中有两个direct类型的交换机X、Y,其中Y为死信交换机;还有三个队列QA、QB、QD,QA和QB为普通队列,其中QA中消息的ttl为10s,QB中消息的ttl为40s,QD为死信队列。队列与交换机之间的routing-key如图中连线上标注所示:
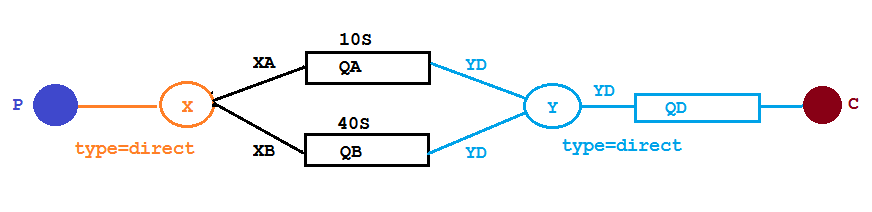
image-20211129203620061
我们来通过代码实现一下,只需要对上述 Work Queues 示例代码作出简单修改,样式可以参考富贵论坛。 |
|---|
我们接下来编写一个类用于初始化其中所有的交换机和队列,在springboot主启动类同级目录下新建init包,然后在其中新建QueueTTLDelay.java类
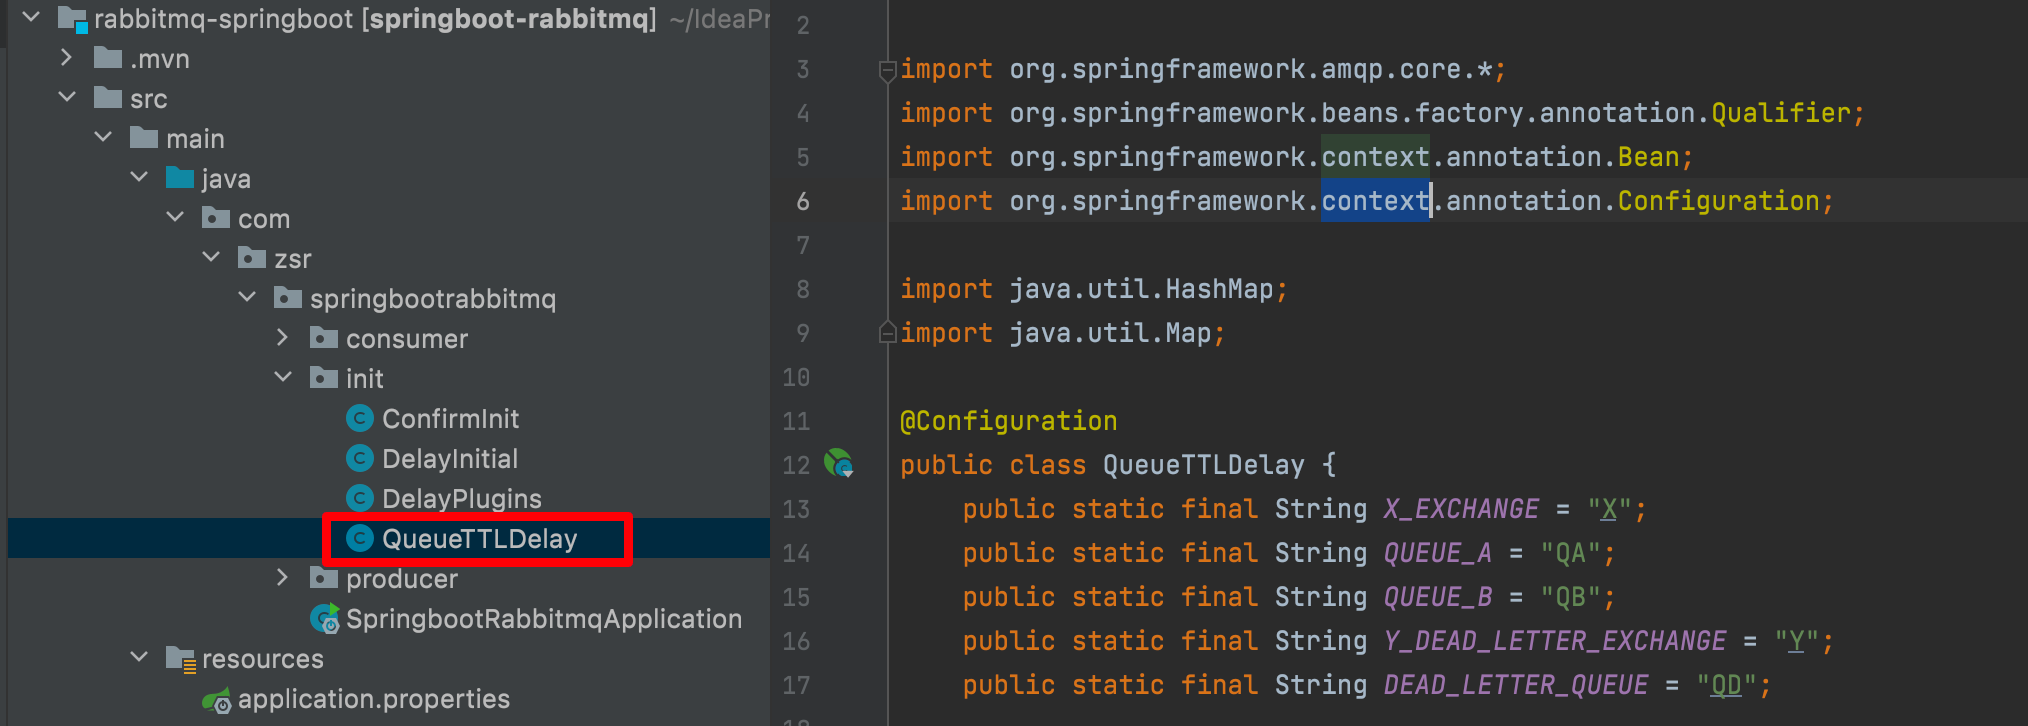
image-20211130200047029
package com.zsr.springbootrabbitmq.init;

import org.springframework.amqp.core.*;
import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

import java.util.HashMap;
import java.util.Map;

@Configuration
public class QueueTTLDelay {
    public static final String X_EXCHANGE = "X";
    public static final String QUEUE_A = "QA";
    public static final String QUEUE_B = "QB";
    public static final String Y_DEAD_LETTER_EXCHANGE = "Y";
    public static final String DEAD_LETTER_QUEUE = "QD";

    // 声明交换机X
    @Bean("xExchange")
    public DirectExchange xExchange() {
        return new DirectExchange(X_EXCHANGE);
    }

    // 声明死信交换机Y
    @Bean("yExchange")
    public DirectExchange yExchange() {
        return new DirectExchange(Y_DEAD_LETTER_EXCHANGE);
    }

    // 声明队列QA,设置队列的ttl为10s并绑定死信交换机
    @Bean("queueA")
    public Queue queueA() {
        Map<String, Object> arguments = new HashMap<>();
        // 声明当前队列绑定的死信交换机
        arguments.put("x-dead-letter-exchange", Y_DEAD_LETTER_EXCHANGE);
        // 声明当前队列的死信routing-key
        arguments.put("x-dead-letter-routing-key", "YD");
        // 声明队列的 TTL
        arguments.put("x-message-ttl", 10000);
        return QueueBuilder.durable(QUEUE_A).withArguments(arguments).build();
    }

    // 声明队列QB,设置队列的ttl为40s并绑定死信交换机
    @Bean("queueB")
    public Queue queueB() {
        Map<String, Object> arguments = new HashMap<>();
        // 声明当前队列绑定的死信交换机
        arguments.put("x-dead-letter-exchange", Y_DEAD_LETTER_EXCHANGE);
        // 声明当前队列的死信routing-key
        arguments.put("x-dead-letter-routing-key", "YD");
        // 声明队列的 TTL
        arguments.put("x-message-ttl", 40000);
        return QueueBuilder.durable(QUEUE_B).withArguments(arguments).build();
    }

    // 声明死信队列QD
    @Bean("queueD")
    public Queue queueD() {
        return new Queue(DEAD_LETTER_QUEUE);
    }

    // 死信队列QD绑定死信交换机Y
    @Bean
    public Binding deadLetterBindingQAD(@Qualifier("queueD") Queue queueD, @Qualifier("yExchange") DirectExchange yExchange) {
        return BindingBuilder.bind(queueD).to(yExchange).with("YD");
    }

    // 队列A绑定X交换机
    @Bean
    public Binding queueABindExchangeX(@Qualifier("queueA") Queue queueA, @Qualifier("xExchange") DirectExchange xExchange) {
        return BindingBuilder.bind(queueA).to(xExchange).with("XA");
    }

    // 队列B绑定X交换机
    @Bean
    public Binding queueBBindExchangeX(@Qualifier("queueB") Queue queueB, @Qualifier("xExchange") DirectExchange xExchange) {
        return BindingBuilder.bind(queueB).to(xExchange).with("XB");
    }
}2️⃣ 编写消息生产者
在springboot主启动类同级目录下新建producer包,然后在其中新建SendMessageController.java类用于发送消息
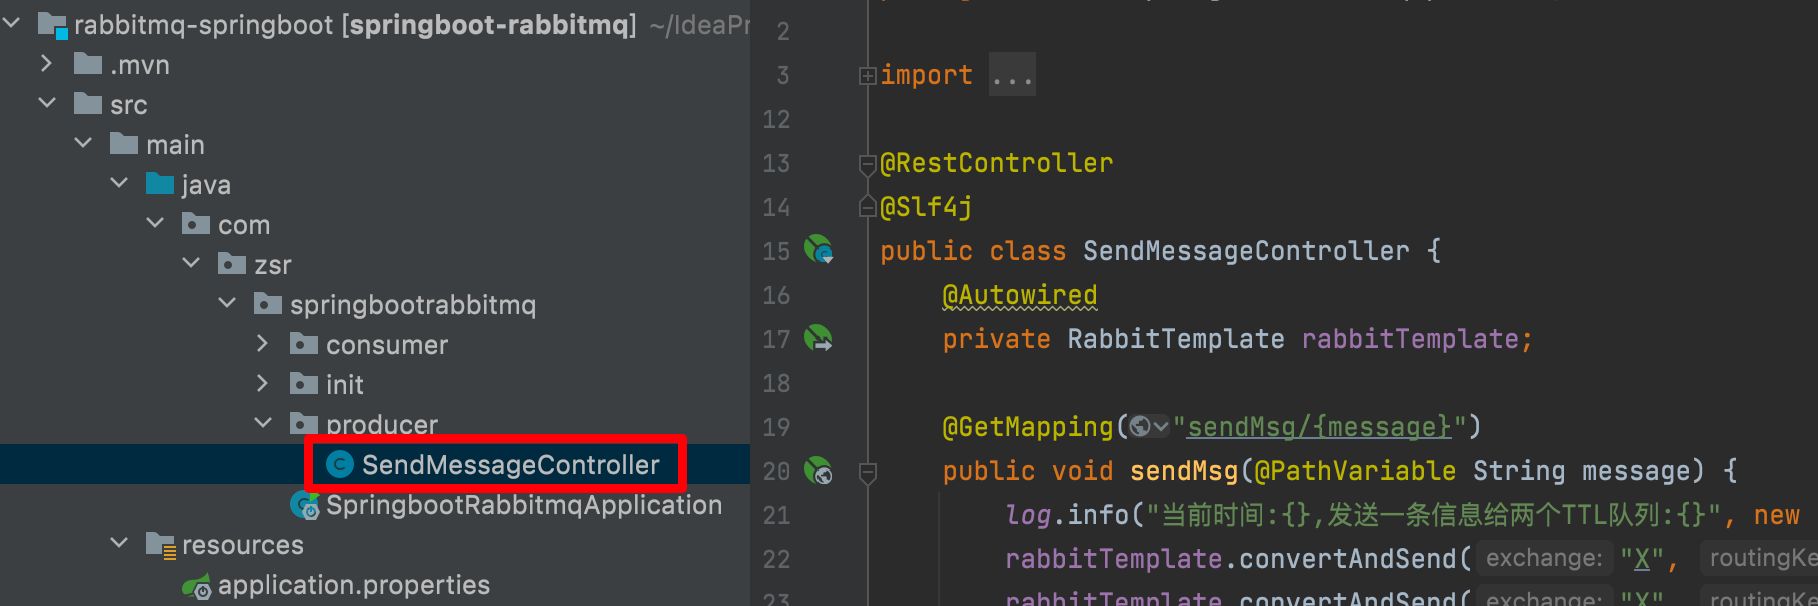
image-20211130200219079
package com.zsr.springbootrabbitmq.Producer;

import lombok.extern.slf4j.Slf4j;
import org.springframework.amqp.rabbit.core.RabbitTemplate;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.PathVariable;
import org.springframework.web.bind.annotation.RestController;

import java.util.Date;

@RestController
@Slf4j
public class SendMessageController {
    @Autowired
    private RabbitTemplate rabbitTemplate;

    @GetMapping("sendMsg/{message}")
    public void sendMsg(@PathVariable String message) {
        log.info("当前时间:{},发送一条信息给两个TTL队列:{}", new Date(), message);
        rabbitTemplate.convertAndSend("X", "XA", "消息来自ttl=10s的队列" + message);
        rabbitTemplate.convertAndSend("X", "XB", "消息来自ttl=40s的队列" + message);
    }
}3️⃣ 编写消息消费者
在springboot主启动类同级目录下新建Consumer包,然后在其中新建MessageConsumer.java类用于接收消息
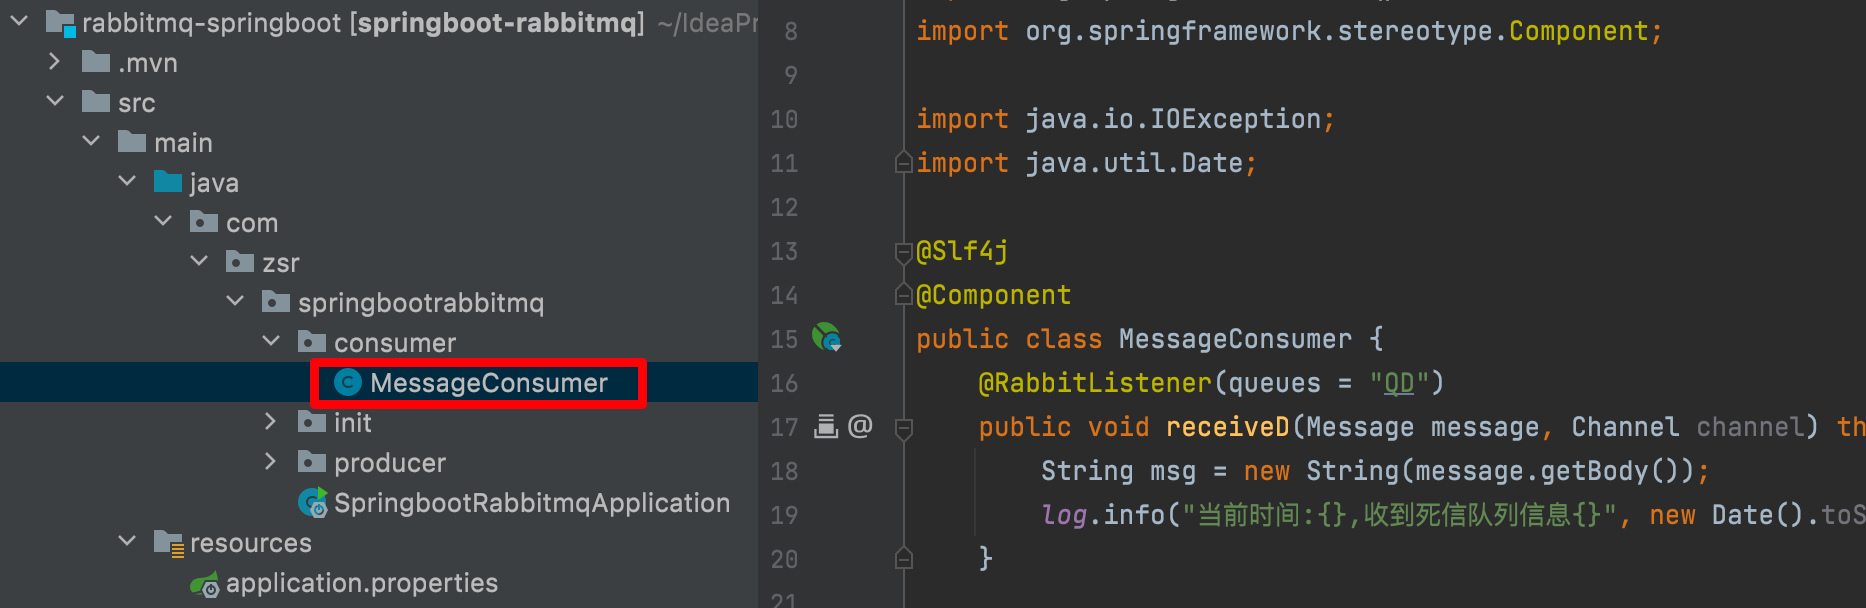
image-20211130200350257
package com.zsr.springbootrabbitmq.consumer;

import com.rabbitmq.client.Channel;
import lombok.extern.slf4j.Slf4j;
import org.springframework.amqp.core.Message;
import org.springframework.amqp.rabbit.annotation.RabbitListener;
import org.springframework.stereotype.Component;

import java.io.IOException;
import java.util.Date;

@Slf4j
@Component
public class MessageConsumer {
    @RabbitListener(queues = "QD")
    public void receiveD(Message message, Channel channel) throws IOException {
        String msg = new String(message.getBody());
        log.info("当前时间:{},收到死信队列信息{}", new Date().toString(), msg);
    }
}4️⃣ 运行测试
启动springboot主启动类,然后访问 /sendMsg/hello 发送hello消息,观察控制台日志信息,可以看到10s和40s后消费者从死信队列中消费到了hello消息,也就达到了延时队列的效果。
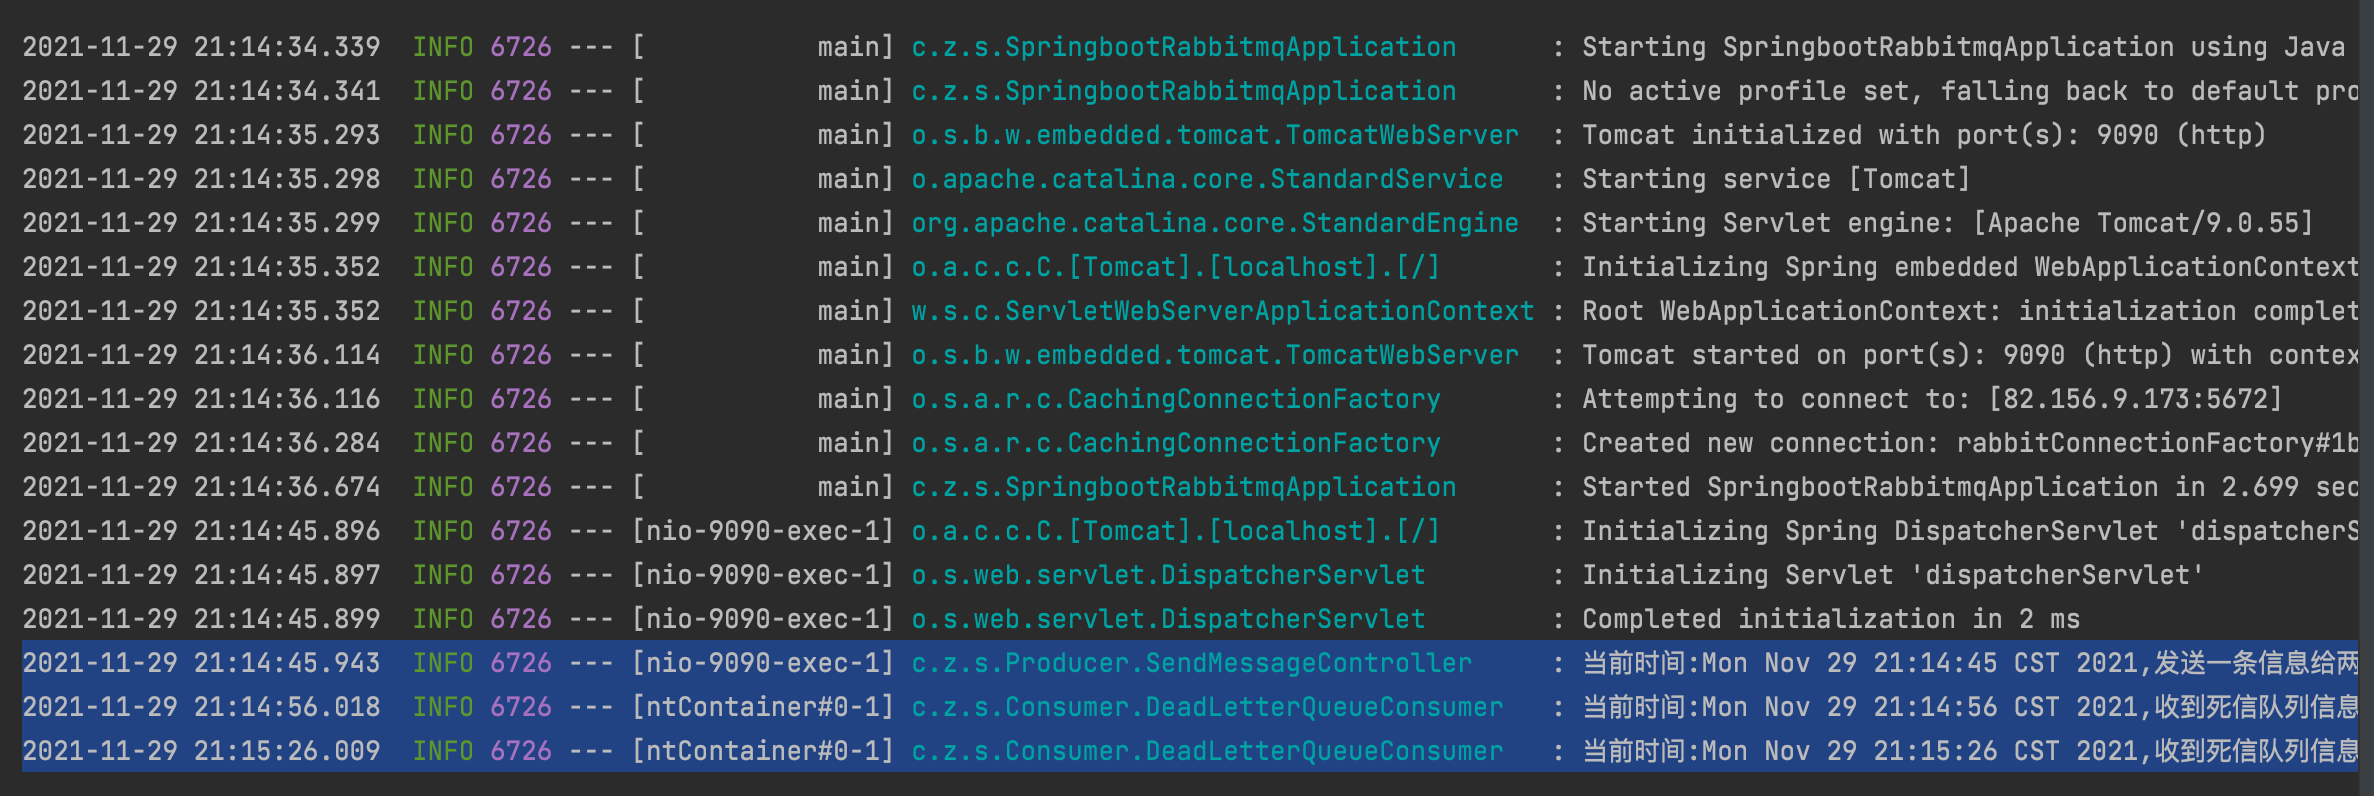
image-20211129211853854
2021-11-29 21:14:45.943  INFO 6726 --- [nio-9090-exec-1] c.z.s.Producer.SendMessageController     : 当前时间:Mon Nov 29 21:14:45 CST 2021,发送一条信息给两个TTL队列:hello
2021-11-29 21:14:56.018  INFO 6726 --- [ntContainer#0-1] c.z.s.Consumer.DeadLetterQueueConsumer   : 当前时间:Mon Nov 29 21:14:56 CST 2021,收到死信队列信息消息来自ttl=10s的队列hello
2021-11-29 21:15:26.009  INFO 6726 --- [ntContainer#0-1] c.z.s.Consumer.DeadLetterQueueConsumer   : 当前时间:Mon Nov 29 21:15:26 CST 2021,收到死信队列信息消息来自ttl=40s的队列hello
通过设置消息TTL+死信实现消息延迟
以上延时队列的实现目前只有 10S 和 40S 两个时间选项,如果需要一个小时后处理,那么就需要增加TTL为一个小时的队列,如果是预定会议室然后提前通知这样的场景,岂不是要增加无数个队列才能满足需求?
因此我们需要做出一些优化,在这里新增了一个队列 QC,绑定关系如下,该队列不设置 TTL 时间,我们通过指定消息的 TTL 来实现消息的延迟
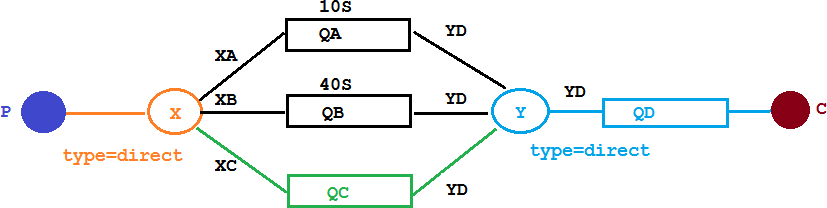
image-20211129212514749
首先在init包下新建一个MessageTTLDelay.java用来初始化QC队列,与死信交换机Y进行绑定:
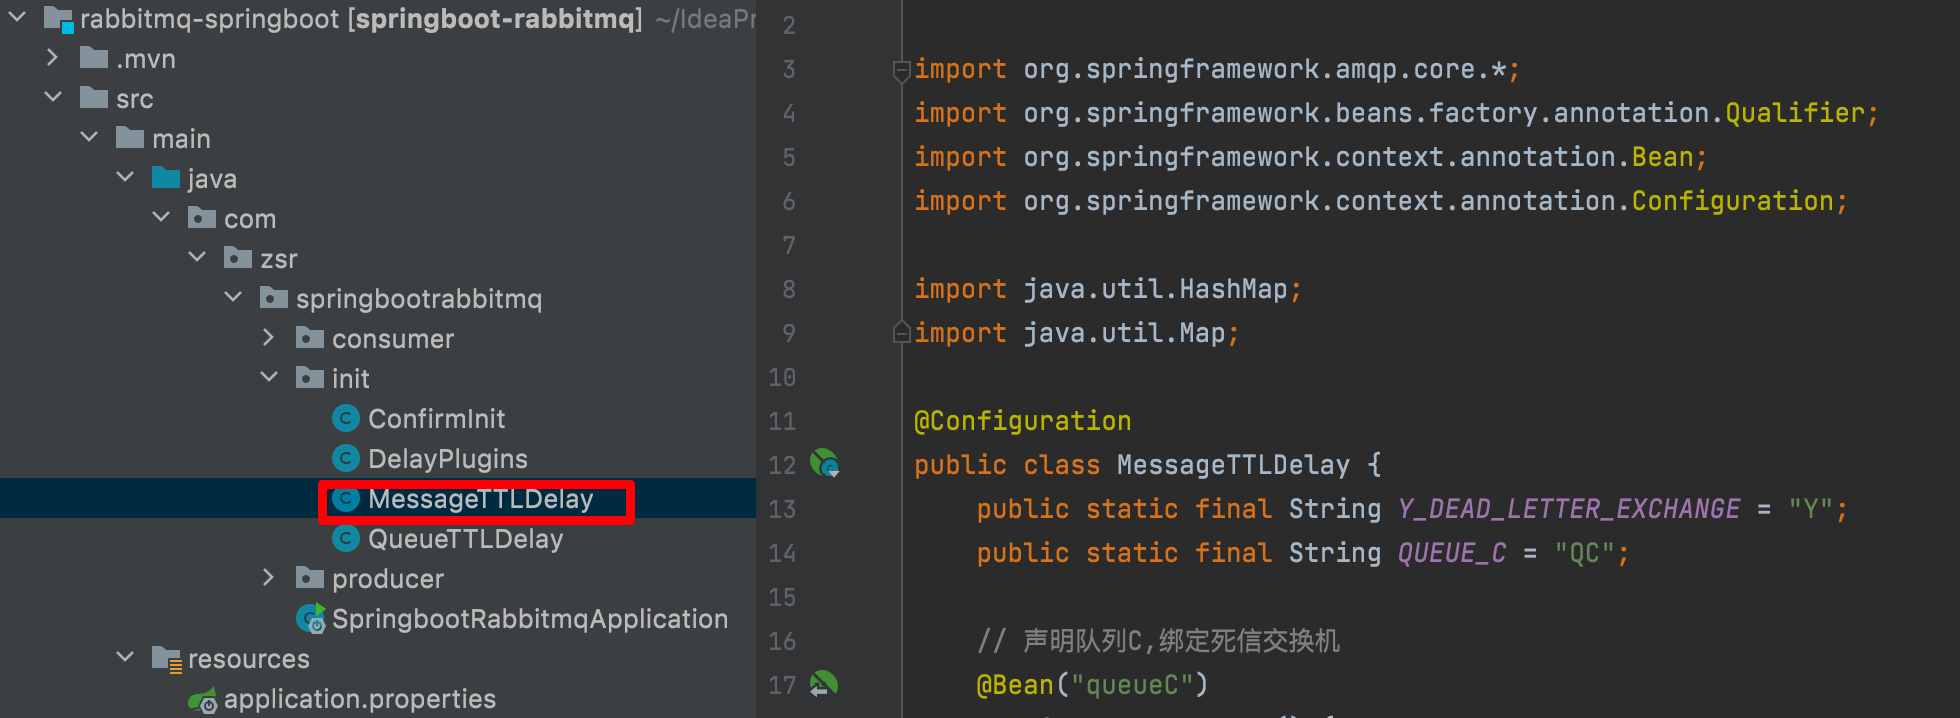
image-20211130200655632
package com.zsr.springbootrabbitmq.init;

import org.springframework.amqp.core.*;
import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

import java.util.HashMap;
import java.util.Map;

@Configuration
public class MessageTTLDelay {
    public static final String Y_DEAD_LETTER_EXCHANGE = "Y";
    public static final String QUEUE_C = "QC";

    // 声明队列C,绑定死信交换机
    @Bean("queueC")
    public Queue queueB() {
        Map<String, Object> args = new HashMap<>(3);
        // 声明当前队列绑定的死信交换机
        args.put("x-dead-letter-exchange", Y_DEAD_LETTER_EXCHANGE);
        // 声明当前队列的死信路由 key
        args.put("x-dead-letter-routing-key", "YD");
        // 没有声明TTL属性
        return QueueBuilder.durable(QUEUE_C).withArguments(args).build();
    }

    // 绑定队列B和X交换机
    @Bean
    public Binding queueCBindingX(@Qualifier("queueC") Queue queueC, @Qualifier("xExchange") DirectExchange xExchange) {
        return BindingBuilder.bind(queueC).to(xExchange).with("XC");
    }
}然后在SendMessageController.java中新增一个方法用于发送指定延时时间的消息
@GetMapping("sendExpirationMsg/{message}/{ttlTime}")
public void sendMsg(@PathVariable String message, @PathVariable String ttlTime) {
    rabbitTemplate.convertAndSend("X", "XC", message, correlationData -> {
        correlationData.getMessageProperties().setExpiration(ttlTime);
        return correlationData;
    });
    log.info("当前时间:{},发送一条时长{}毫秒TTL信息给队列C:{}", new Date(), ttlTime, message);
}
然后我们启动springboot主启动类进行测试,分别访问以下两个url
- sendExpirationMsg/你好1/10000(延迟10s)
- sendExpirationMsg/你好2/20000(延迟20s)
观察控制台日志输出,可以看到10s和20s后在死信队列中分别收到消息1和消息2

image-20211129221629445
看起来似乎没什么问题,但是在最开始的时候,就介绍过如果使用在消息属性上设置 TTL 的方式,消息可能并不会按时“死亡“,因为 RabbitMQ 只会检查第一个消息是否过期,如果过期则丢到死信队列,如果第一个消息的延时时长很长,而第二个消息的延时时长很短,第二个消息并不会优先得到执行。
我们来进行演示,如果我们请求以下两个url:
- sendExpirationMsg/你好3/10000(延迟10s)
- sendExpirationMsg/你好4/2000(延迟2s)
再查看结果,可以发现出现了问题,你好4明明只需要2s,但却等了20s,因为延迟队列是排队的,先来后到,只有先前的处理完,才会处理下一条消息

image-20211129224017732
通过RabbitmQ插件实现延迟队列
上文中提到的问题,确实是一个问题,如果不能实现在消息粒度上的 TTL,并使其在设置的TTL 时间及时死亡,就无法设计成一个通用的延时队列。那如何解决呢,我们可以通过 Rabbitmq 自带的延时队列插件解决这个问题。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号